推出 Claude 4 \ Anthropic
来源: https://www.anthropic.com/news/claude-4 抓取时间: 2026-07-21 16:28:23
公告
推出 Claude 4
May 22, 2025
 今天,我们推出下一代 Claude 模型:Claude Opus 4 和 Claude Sonnet 4,它们为编码、高级推理和 AI 智能体设定了新标准。
Claude Opus 4 是世界上最好的编码模型,在复杂、长时间运行的任务和智能体工作流上具有持续的性能。Claude Sonnet 4 是 Claude Sonnet 3.7 的重大升级,在提供卓越的编码和推理能力的同时,能够更精确地响应您的指令。
除了这些模型,我们还宣布:
- 支持 Tool Use 的扩展思考(测试版):两个模型都可以在扩展思考期间使用工具——比如网页搜索——允许 Claude 在推理和 Tool Use 之间交替以改进响应。
- 新模型能力:两个模型都可以并行使用工具,更精确地遵循指令,并且——当开发人员授予本地文件访问权限时——展示显著改进的记忆能力,提取和保存关键事实以保持连续性并随着时间的推移建立隐性知识。
- Claude Code 现已全面可用:在我们的研究预览期间收到广泛的积极反馈后,我们正在扩展开发人员与 Claude 协作的方式。Claude Code 现在支持通过 GitHub Actions 执行后台任务,以及与 VS Code 和 JetBrains 的原生集成,直接在您的文件中显示编辑,实现无缝的结对编程。
- 新 API 能力:我们正在我们的 API 上发布四项新能力,使开发人员能够构建更强大的 AI 智能体:代码执行工具、MCP 连接器、Files API,以及将提示词缓存长达一小时的能力。
Claude Opus 4 和 Sonnet 4 是混合模型,提供两种模式:近乎即时的响应和用于深度推理的扩展思考。Claude 的 Pro、Max、Team 和 Enterprise 计划包括这两种模型和扩展思考,Sonnet 4 也可供免费用户使用。两种模型都可在我们的 API、Amazon Bedrock 和 Google Cloud 的 Vertex AI 上使用。价格与之前的 Opus 和 Sonnet 模型保持一致:Opus 4 为每百万令牌 15/75 美元(输入/输出),Sonnet 4 为每百万令牌 3/15 美元。
Claude 4
Claude Opus 4 是我们迄今为止最强大的模型,也是世界上最好的编码模型,在 SWE-bench(72.5%)和 Terminal-bench(43.2%)上领先。它在需要专注努力和数千步的长时间运行任务上提供持续的性能,能够连续工作数小时——显著优于所有 Sonnet 模型,并大大扩展了 AI 智能体可以完成的任务范围。
Claude Opus 4 擅长编码和复杂问题解决,为前沿智能体产品提供动力。Cursor 称其为编码领域的最先进技术,是复杂代码库理解的飞跃。Replit 报告说,对于跨多个文件的复杂变更,精度有所提高,并且取得了巨大进步。Block 称其是第一个在其智能体(代号为 goose)中在编辑和调试期间提高代码质量,同时保持完整性能和可靠性的模型。乐天(Rakuten) 通过一个运行独立 7 小时并保持持续性能的苛刻开源重构验证了其能力。Cognition 指出,Opus 4 擅长解决其他模型无法解决的复杂挑战,成功处理了先前模型遗漏的关键操作。
Claude Sonnet 4 显著改进了 Sonnet 3.7 的行业领先能力,在编码方面表现出色,在 SWE-bench 上达到 72.7% 的最先进水平。该模型平衡了内部和外部用例的性能和效率,具有增强的可操纵性,可以更好地控制实现。虽然在大多数领域无法与 Opus 4 匹敌,但它提供了能力和实用性的最佳组合。
GitHub 表示,Claude Sonnet 4 在智能体场景中表现出色,并将其作为 GitHub Copilot 中新编码智能体的动力模型。Manus 强调了它在遵循复杂指令、清晰推理和美观输出方面的改进。iGent 报告说,Sonnet 4 擅长自主的多功能应用开发,以及大幅改进的问题解决和代码库导航——将导航错误从 20% 减少到接近零。Sourcegraph 表示,该模型显示出作为软件开发重大飞跃的前景——更长时间地保持在轨道上,更深入地理解问题,并提供更优雅的代码质量。Augment Code 报告了更高的成功率,更精确的代码编辑,以及在复杂任务中更仔细的工作,使其成为其主要模型的首选。
这些模型全面推进了我们客户的 AI 战略:Opus 4 在编码、研究、写作和科学发现方面突破了界限,而 Sonnet 4 将前沿性能带到了日常用例中,是 Sonnet 3.7 的即时升级。
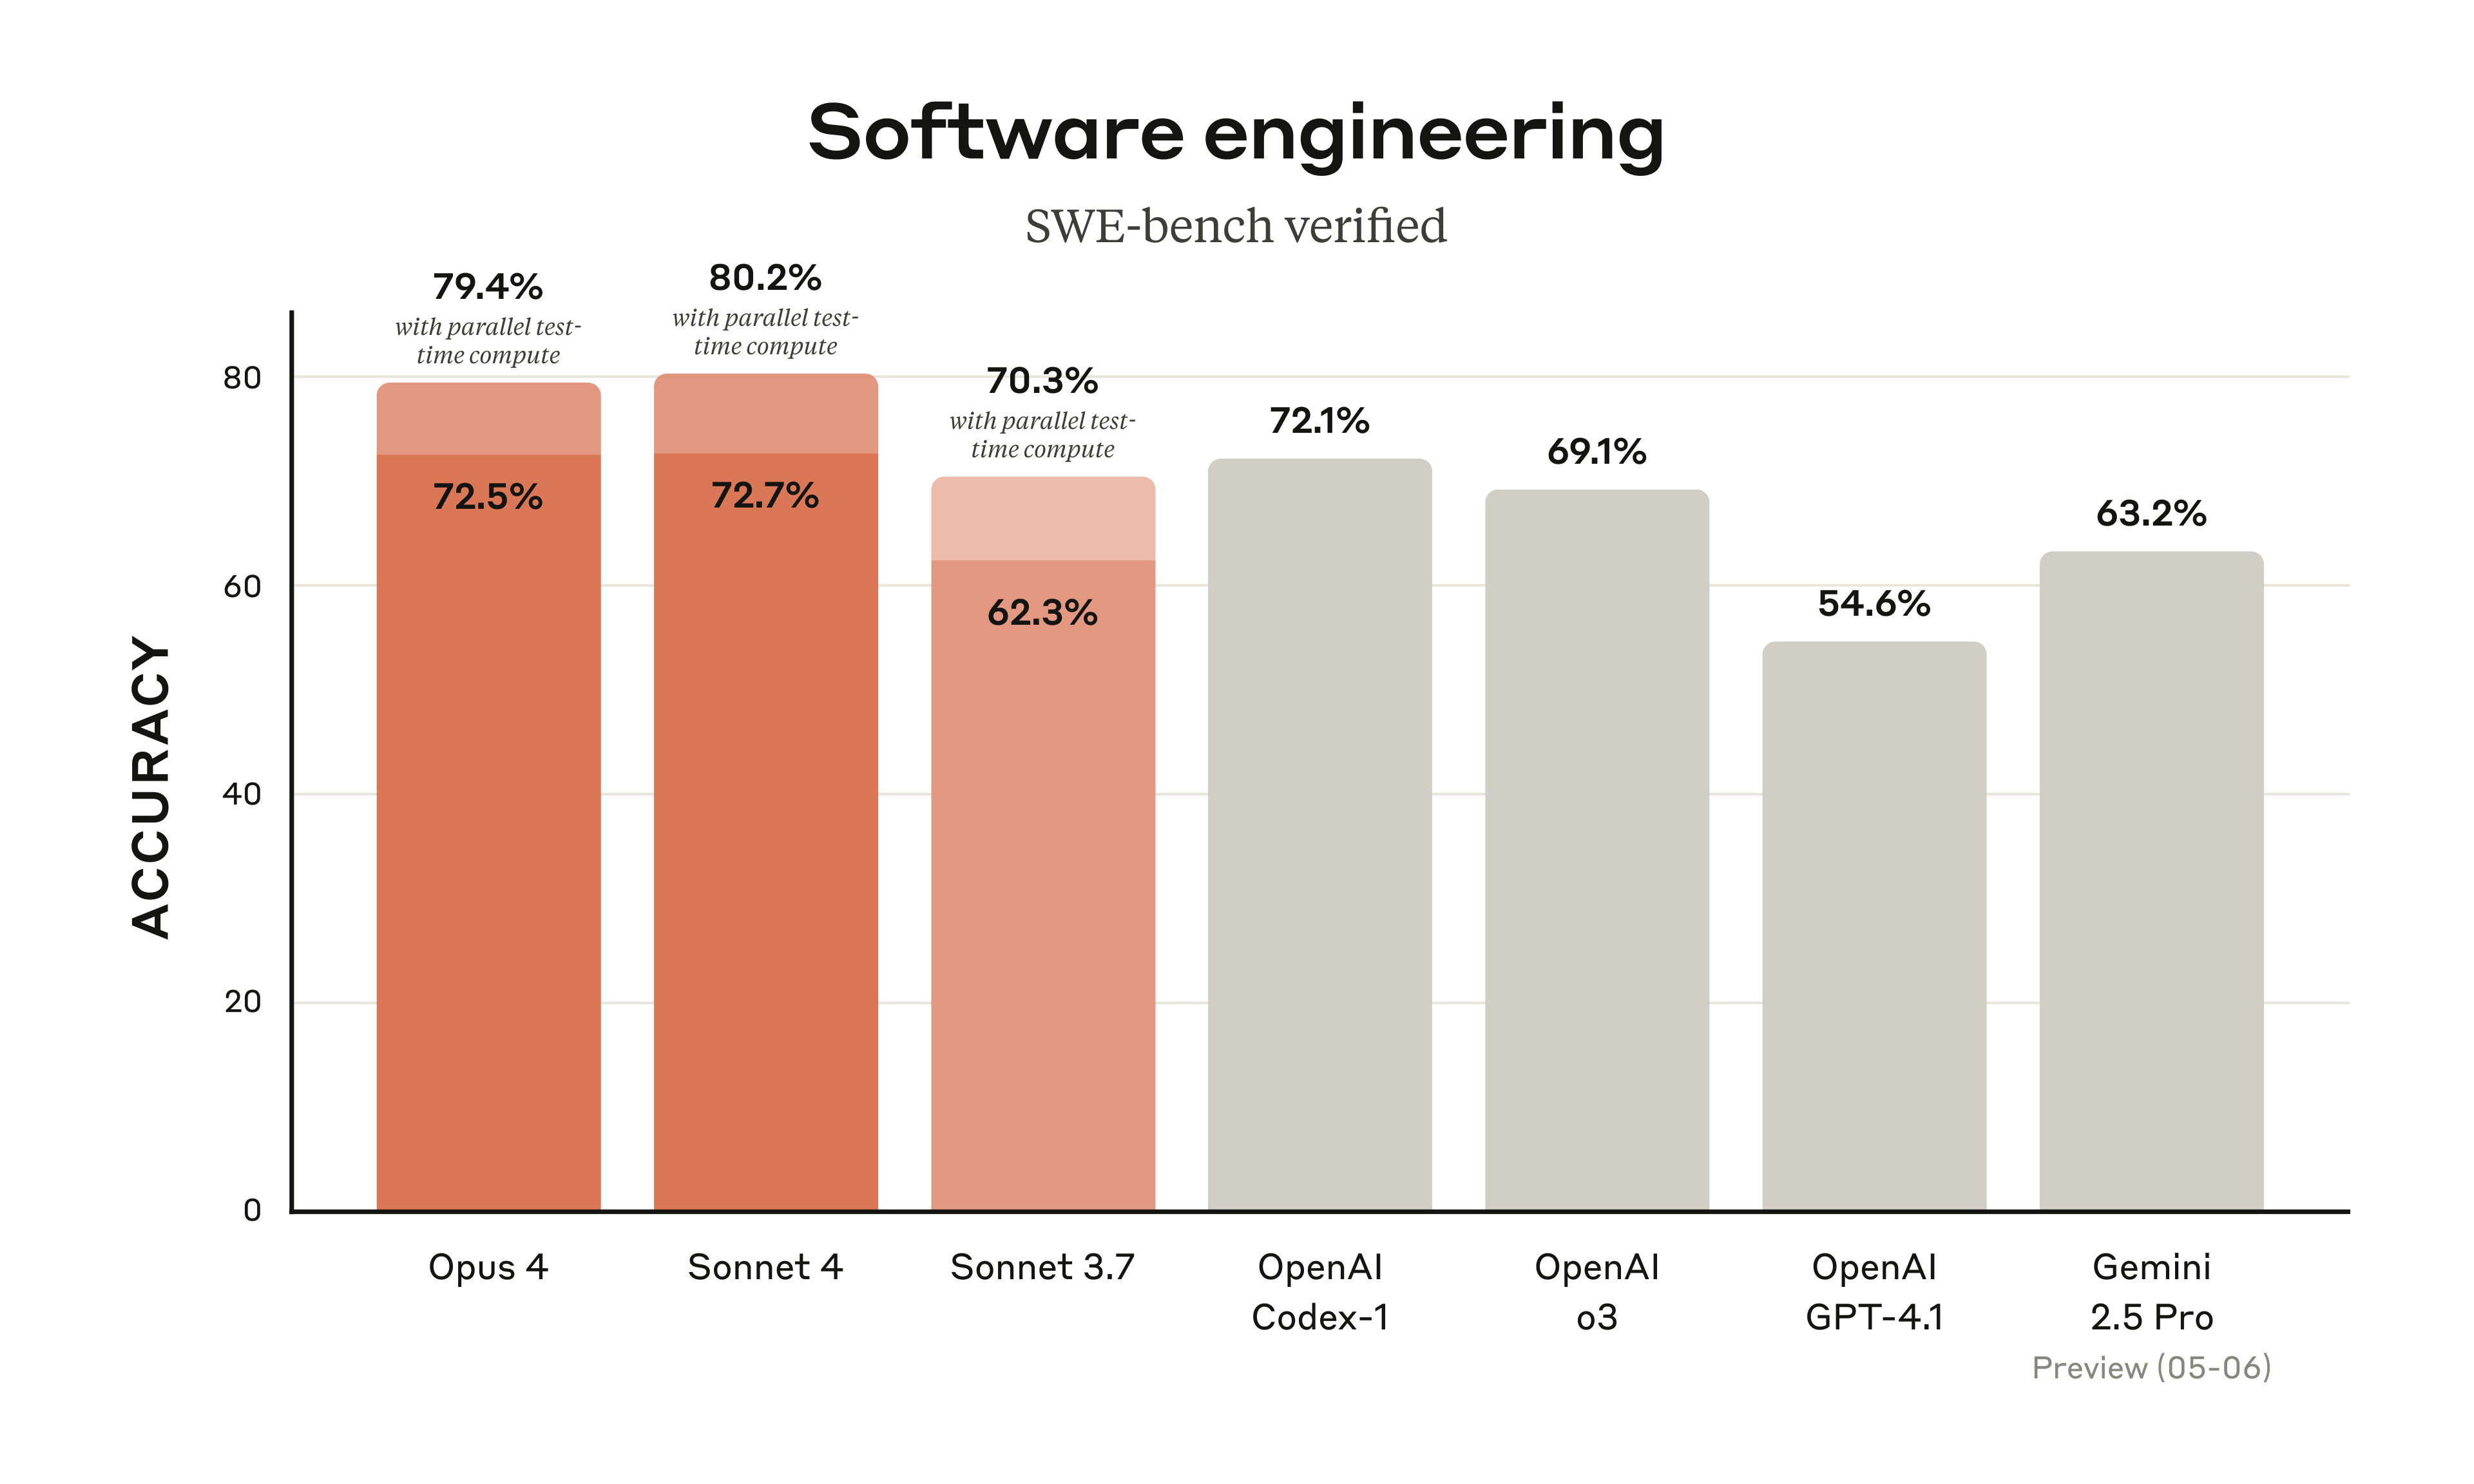 Claude 4 模型在 SWE-bench Verified 上领先,这是真实软件工程任务性能的基准。有关方法的更多信息,请参阅附录。
模型改进
除了支持 Tool Use 的扩展思考、并行工具执行和记忆改进之外,我们还显著减少了模型使用捷径或漏洞来完成任务的行为。在特别容易受到捷径和漏洞影响的智能体任务上,两种模型发生这种行为的可能性比 Sonnet 3.7 低 65%。
Claude Opus 4 在记忆能力方面也显著优于所有先前的模型。当开发人员构建为 Claude 提供本地文件访问权限的应用程序时,Opus 4 变得擅长创建和维护"记忆文件"来存储关键信息。这解锁了对智能体任务更好的长期任务意识、连贯性和性能——就像 Opus 4 在玩 Pokémon 时创建一个"导航指南"一样。
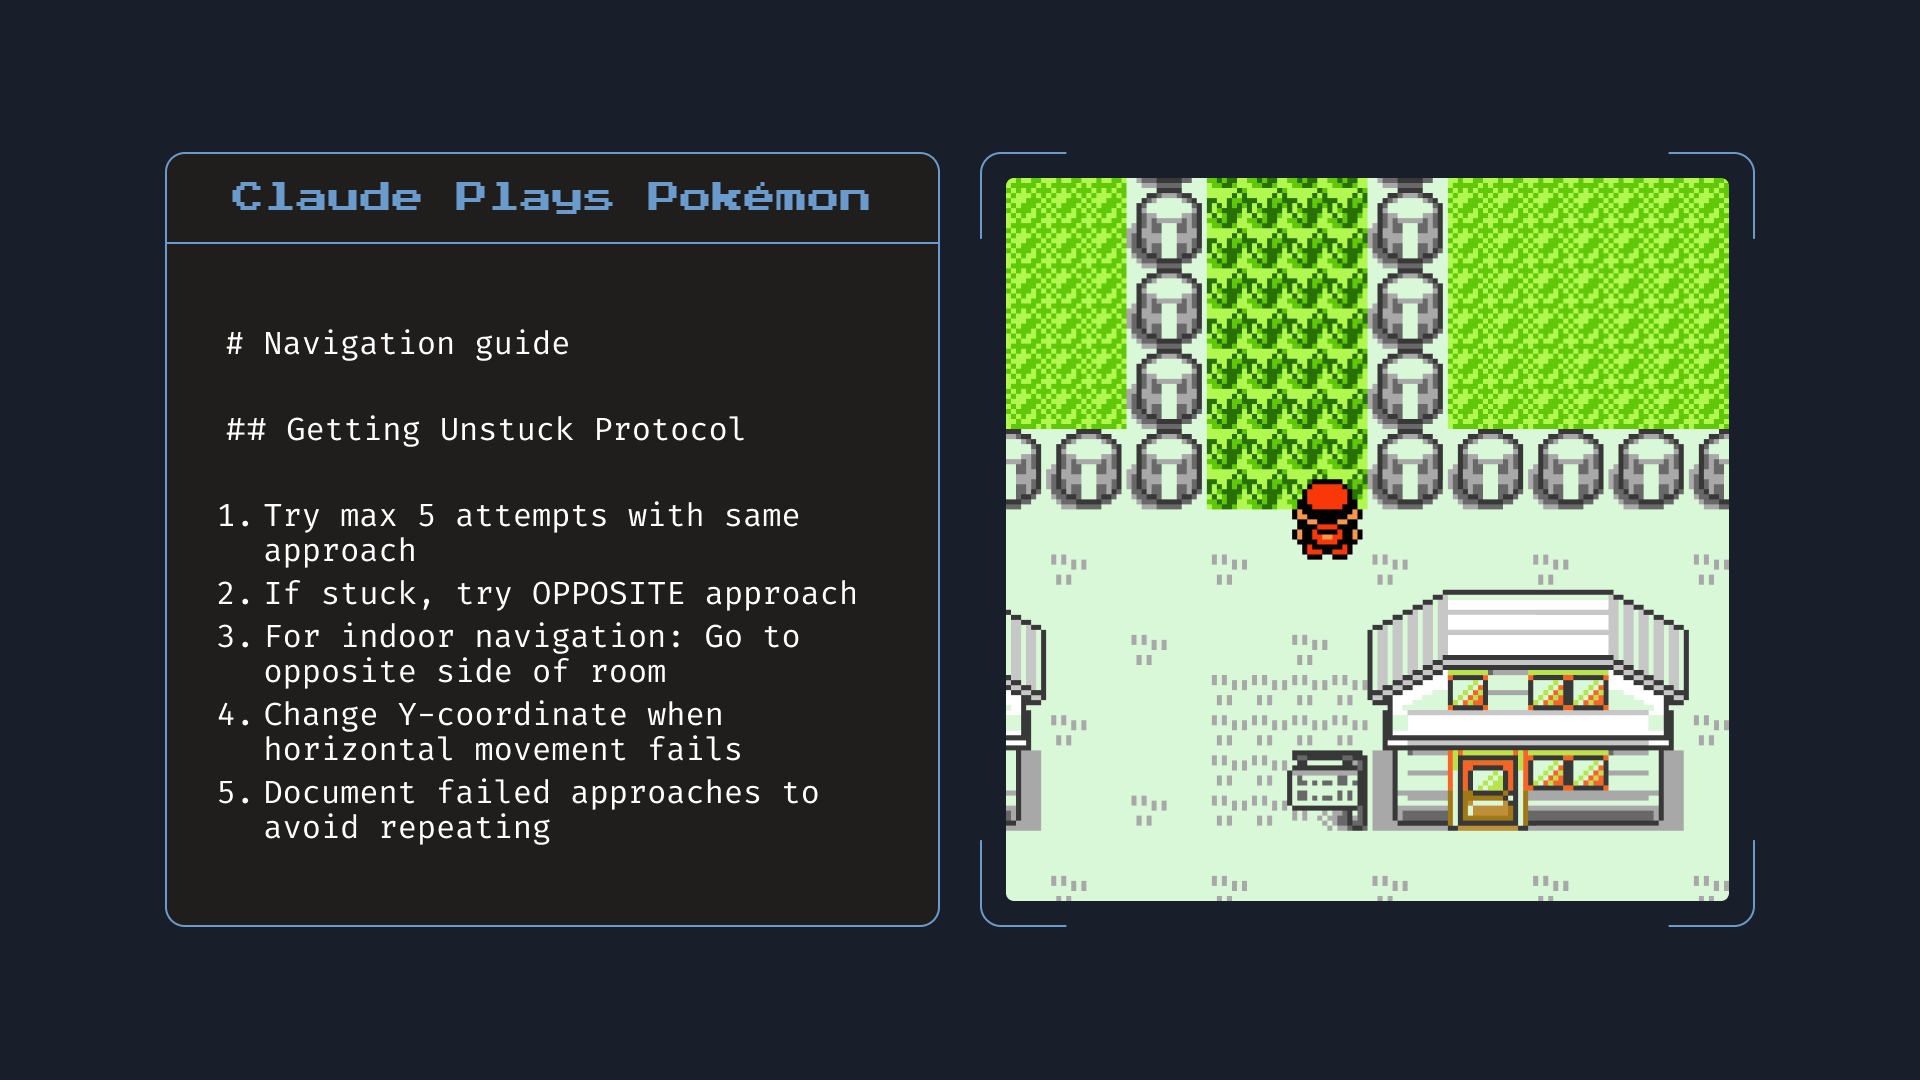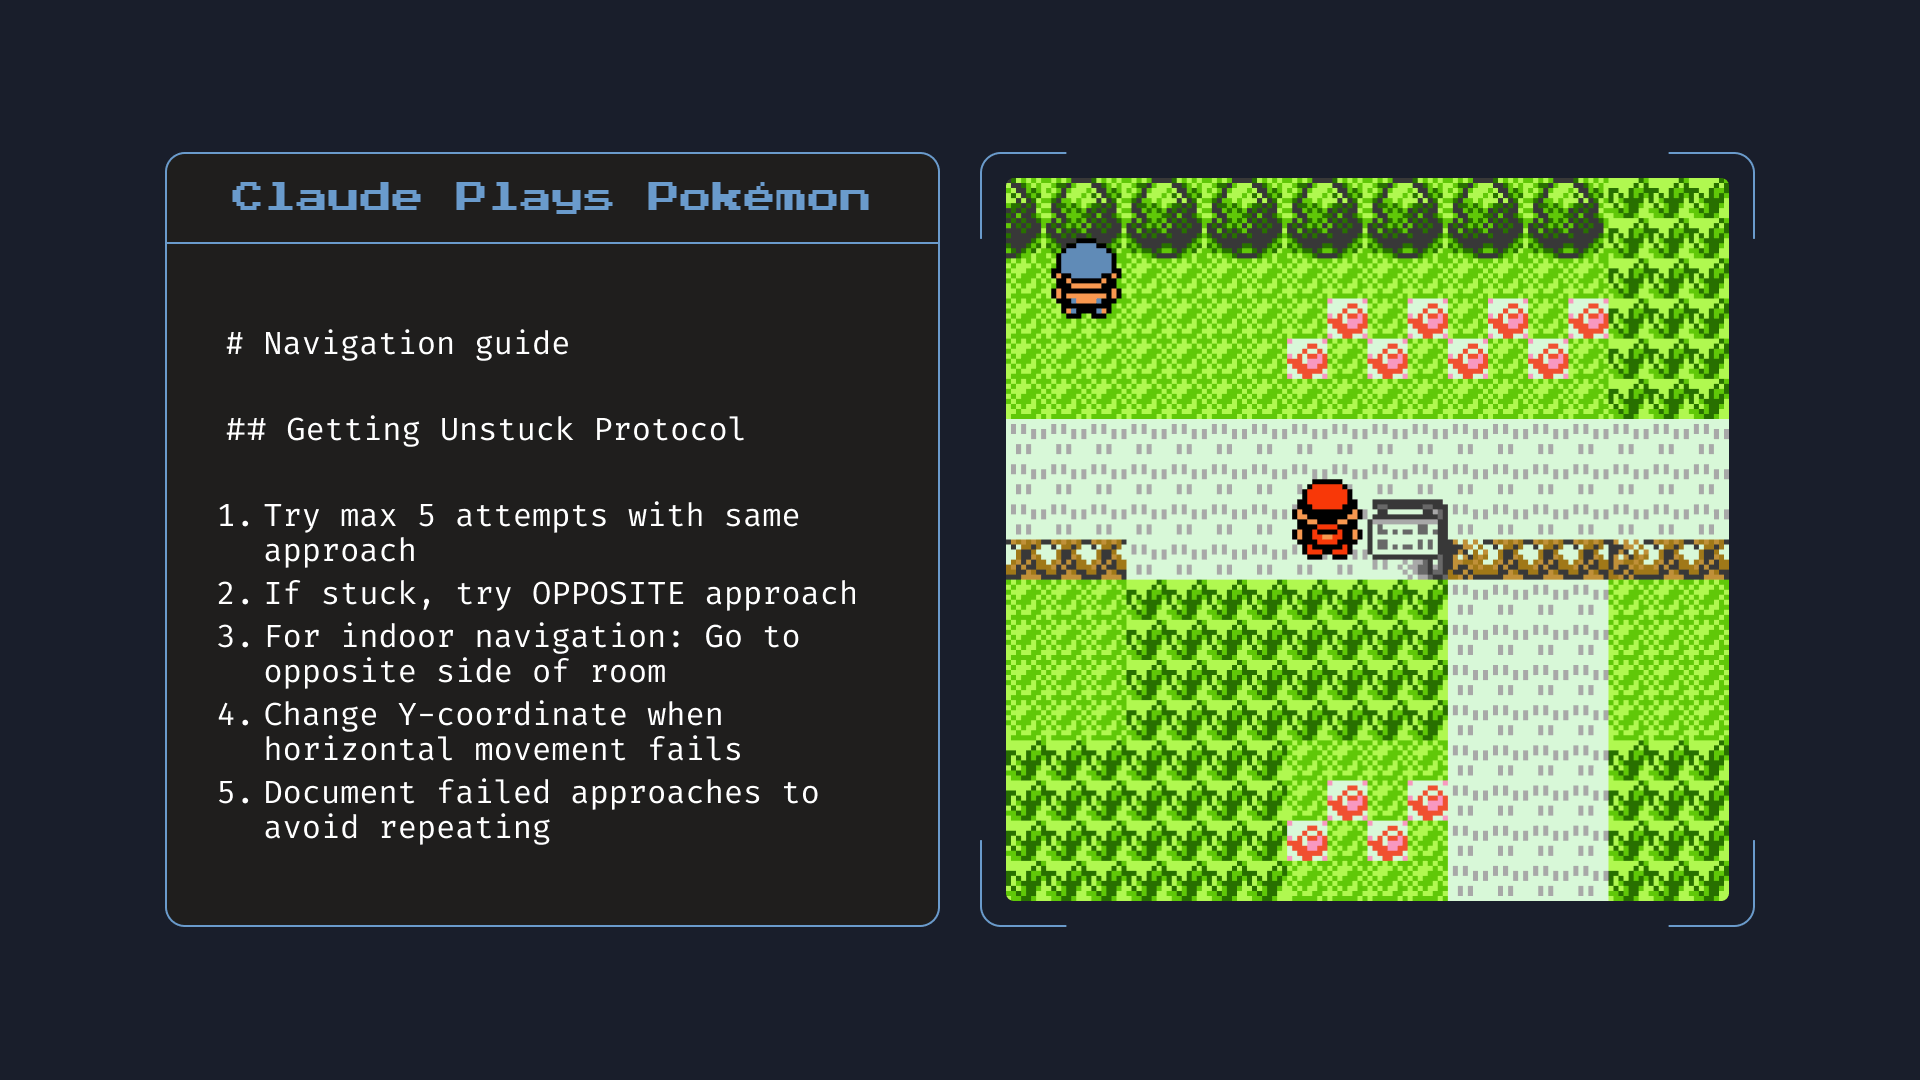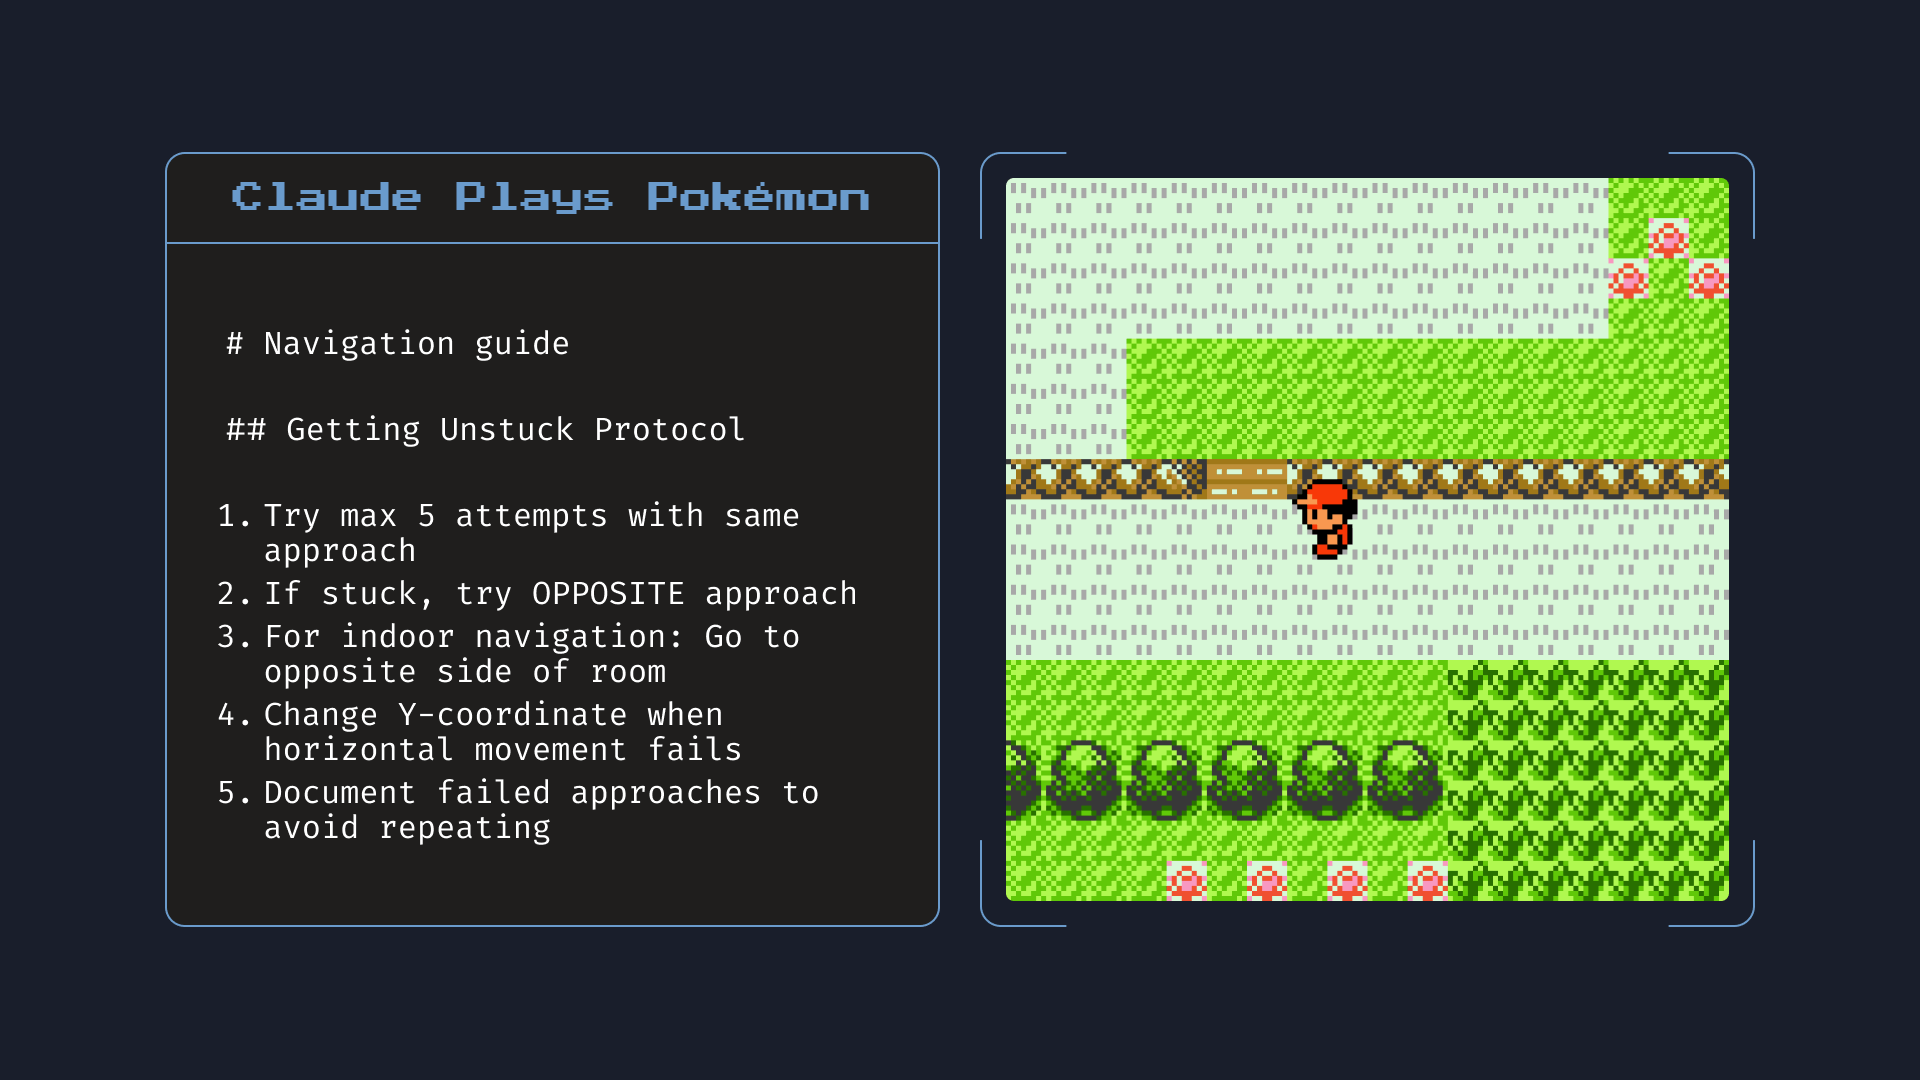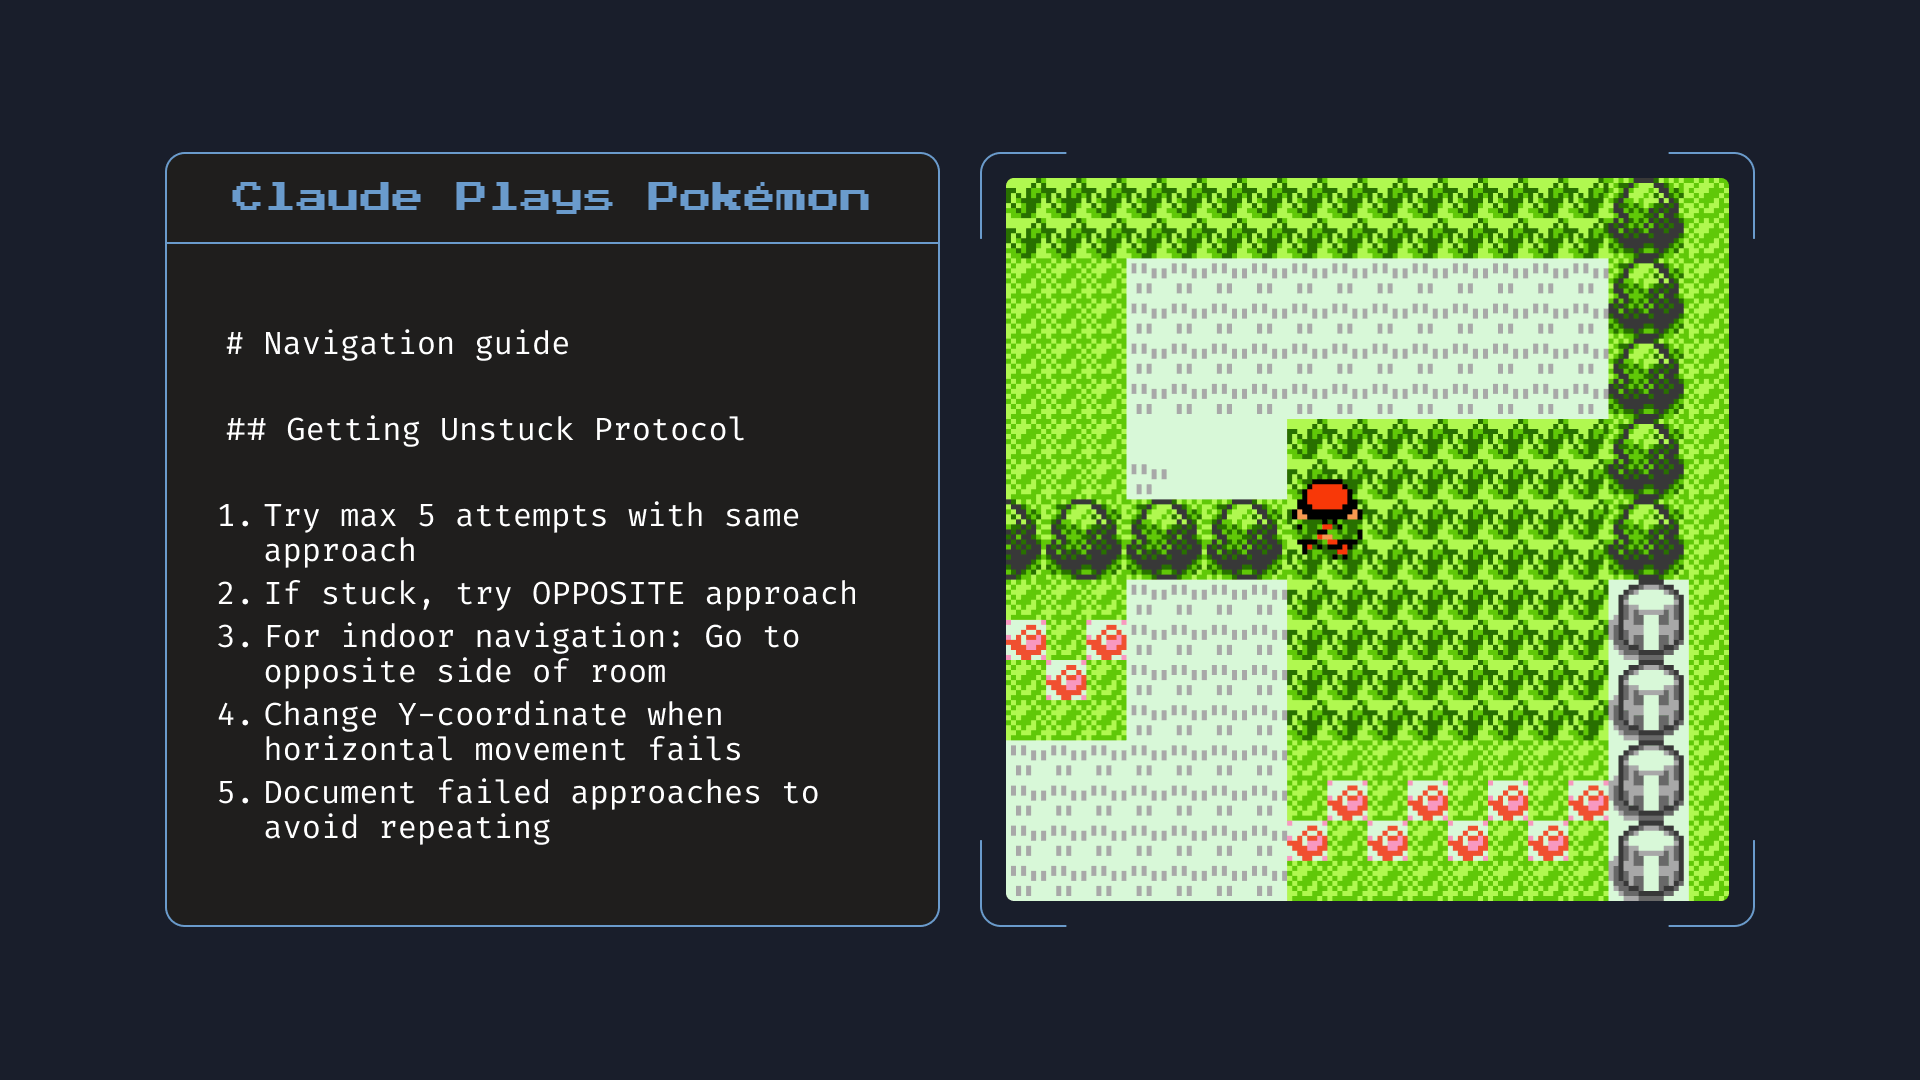 记忆:当获得本地文件访问权限时,Claude Opus 4 会记录关键信息以帮助改进其游戏玩法。上面显示的笔记是 Opus 4 在玩 Pokémon 时拍摄的真实笔记。
最后,我们为 Claude 4 模型引入了思考摘要,使用较小的模型来压缩冗长的思考过程。这种摘要只需要约 5% 的时间——大多数思考过程足够短,可以完整显示。需要原始思考链进行高级提示词工程的用户可以联系销售了解我们新的开发者模式,以保留完全访问权限。
Claude Code
Claude Code 现已全面可用,将 Claude 的强大功能带到了您的更多开发工作流中——在终端中、您喜欢的 IDE 中,以及使用 Claude Code SDK 在后台运行。
VS Code 和 JetBrains 的新测试版扩展将 Claude Code 直接集成到您的 IDE 中。Claude 建议的编辑会内联显示在您的文件中,在熟悉的编辑器界面中简化审查和跟踪。只需在您的 IDE 终端中运行 Claude Code 即可安装。
除了 IDE 之外,我们还发布了一个可扩展的 Claude Code SDK,这样您就可以使用与 Claude Code 相同的核心智能体来构建您自己的智能体和应用程序。我们还发布了一个 SDK 可以实现的示例:GitHub 上的 Claude Code,现在处于测试版。在 PR 上标记 Claude Code 以响应审查者反馈、修复 CI 错误或修改代码。要安装,请在 Claude Code 中运行 /install-github-app。
开始使用
这些模型向虚拟协作者迈出了一大步——保持完整上下文、在较长项目中持续专注、推动变革性影响。它们经过广泛的测试和评估,以最大限度地降低风险并最大限度地提高安全性,包括为更高的 AI 安全级别(如 ASL-3)实施措施。
我们很期待看看你会创造什么。立即在 Claude、Claude Code 或您选择的平台上开始使用。
一如既往,您的[反馈](mailto: feedback@anthropic.com)帮助我们改进。
附录
性能基准数据来源
- Open AI:o3 发布文章、o3 系统卡片、GPT-4.1 发布文章、GPT-4.1 托管评估
- Gemini:Gemini 2.5 Pro 预览版模型卡片
- Claude:Claude 3.7 Sonnet 发布文章
性能基准报告
Claude Opus 4 和 Sonnet 4 是混合推理模型。本博客文章中报告的基准显示了使用或不使用扩展思考获得的最高分。我们在下面为每个结果注明了是否使用了扩展思考:
- 无扩展思考:SWE-bench Verified、Terminal-bench
- 扩展思考(最多 64K 令牌):
- TAU-bench(未报告无扩展思考的结果)
- GPQA Diamond(无扩展思考:Opus 4 得分为 74.9%,Sonnet 4 为 70.0%)
- MMMLU(无扩展思考:Opus 4 得分为 87.4%,Sonnet 4 为 85.4%)
- MMMU(无扩展思考:Opus 4 得分为 73.7%,Sonnet 4 为 72.6%)
- AIME(无扩展思考:Opus 4 得分为 33.9%,Sonnet 4 为 33.1%)
TAU-bench 方法
通过在航空和零售智能体政策中添加提示词附录,指示 Claude 在使用支持 Tool Use 的扩展思考时更好地利用其推理能力。鼓励模型在解决问题时在多轮轨迹中写下其想法,这与我们通常的思考模式不同,以便最好地利用其推理能力。为了适应 Claude 通过使用更多思考产生的额外步骤,最大步数(按模型完成计数)从 30 增加到 100(大多数轨迹在 30 步内完成,只有一条轨迹超过 50 步)。
SWE-bench 方法
对于 Claude 4 系列模型,我们继续使用相同的简单脚手架,该脚手架仅为模型配备我们之前版本此处描述的两个工具——一个 bash 工具,以及一个通过字符串替换操作的文件编辑工具。我们不再包含 Claude 3.7 Sonnet 使用的第三个"规划工具"。在所有 Claude 4 模型上,我们报告完整 500 个问题的分数。OpenAI 模型的分数基于477 个问题的子集报告。
对于我们的"高计算"数字,我们采用了额外的复杂性和并行测试时计算,如下:
- 我们采样多个并行尝试
- 我们丢弃破坏仓库中可见回归测试的补丁,类似于 Agentless(Xia 等人,2024)采用的拒绝采样方法;注意不使用任何隐藏的测试信息
- 然后我们使用内部评分模型从剩余的尝试中选择最佳候选者
这为 Opus 4 和 Sonnet 4 分别产生了 79.4% 和 80.2% 的结果。
相关内容
申请 Anthropic 的 AI for Science 罕见病研究资助
Anthropic 正在分享针对 AI for Science 申请的特别聚焦于罕见遗传病的信息。被录取的申请者将在六个月内获得最高 50,000 美元的 Claude 积分,目标是建立一个研究 AI 如何重塑我们对罕见病理解的研究人员社区。 阅读更多