AI 系统中的上下文检索 | Anthropic
来源: https://www.anthropic.com/news/contextual-retrieval 抓取时间: 2026-07-21 16:28:36
为了让 AI 模型在特定场景中发挥作用,它通常需要访问背景知识。例如,客户支持聊天机器人需要了解它们所服务的特定业务的知识,而法律分析机器人则需要了解大量过去的案例。
开发者通常使用检索增强生成(RAG)来增强 AI 模型的知识。RAG 是一种从知识库中检索相关信息并将其附加到用户提示词的方法,显著提升了模型的响应质量。问题在于,传统的 RAG 解决方案在编码信息时会移除上下文,这常常导致系统无法从知识库中检索到相关信息。
在这篇文章中,我们概述了一种大幅改进 RAG 中检索步骤的方法。该方法被称为"上下文检索"(Contextual Retrieval),使用两种子技术:上下文嵌入(Contextual Embeddings)和上下文 BM25(Contextual BM25)。这种方法可以将检索失败次数减少 49%,如果结合重排序,则可以减少 67%。这些代表了检索准确性的显著改进,直接转化为下游任务的更好性能。
您可以使用 我们的教程 轻松部署您自己的 Claude 上下文检索解决方案。
关于简单使用更长提示词的说明
有时候最简单的解决方案是最好的。如果您的知识库小于 200,000 个令牌(约 500 页材料),您可以将整个知识库包含在给模型的提示词中,无需使用 RAG 或类似方法。
几周前,我们为 Claude 发布了提示词缓存,这使得这种方法速度更快、成本效益更高。开发者现在可以在 API 调用之间缓存常用的提示词,延迟减少超过 2 倍,成本降低高达 90%(您可以通过阅读我们的提示词缓存教程了解其工作原理)。
然而,随着知识库的增长,您需要一个更具可扩展性的解决方案。这就是上下文检索的用武之地。
RAG 入门:扩展到更大的知识库
对于超出上下文窗口大小的大型知识库,RAG 是典型的解决方案。RAG 通过以下步骤预处理知识库:
- 将知识库(文档"语料库")分解成更小的文本块,通常不超过几百个令牌;
- 使用嵌入模型将这些块转换为编码语义的向量嵌入;
- 将这些嵌入存储在向量数据库中,该数据库允许通过语义相似度进行搜索。
在运行时,当用户向模型输入查询时,向量数据库用于基于与查询的语义相似度找到最相关的块。然后,最相关的块被添加到发送给生成模型的提示词中。
虽然嵌入模型擅长捕捉语义关系,但它们可能会错过关键的精确匹配。幸运的是,有一种较旧的技术可以在这些情况下提供帮助。BM25(最佳匹配 25)是一种排名函数,使用词汇匹配来查找精确的单词或短语匹配。它对于包含唯一标识符或技术术语的查询特别有效。
BM25 建立在 TF-IDF(词频-逆文档频率)概念之上。TF-IDF 衡量一个词对集合中某个文档的重要性。BM25 通过考虑文档长度并对词频应用饱和函数来改进这一点,这有助于防止常用词主导结果。
以下是 BM25 如何在语义嵌入失败的情况下取得成功的例子:假设用户在技术支持数据库中查询"错误代码 TS-999"。嵌入模型可能会找到关于错误代码的一般内容,但可能会错过精确的"TS-999"匹配。BM25 会查找这个特定的文本字符串来识别相关文档。
RAG 解决方案可以通过以下步骤结合嵌入和 BM25 技术来更准确地检索最适用的块:
- 将知识库(文档"语料库")分解成更小的文本块,通常不超过几百个令牌;
- 为这些块创建 TF-IDF 编码和语义嵌入;
- 使用 BM25 基于精确匹配找到前几个块;
- 使用嵌入基于语义相似度找到前几个块;
- 使用排名融合技术合并和去重(3)和(4)的结果;
- 将前 K 个块添加到提示词中以生成响应。
通过利用 BM25 和嵌入模型,传统的 RAG 系统可以提供更全面和准确的结果,在精确词匹配和更广泛的语义理解之间取得平衡。
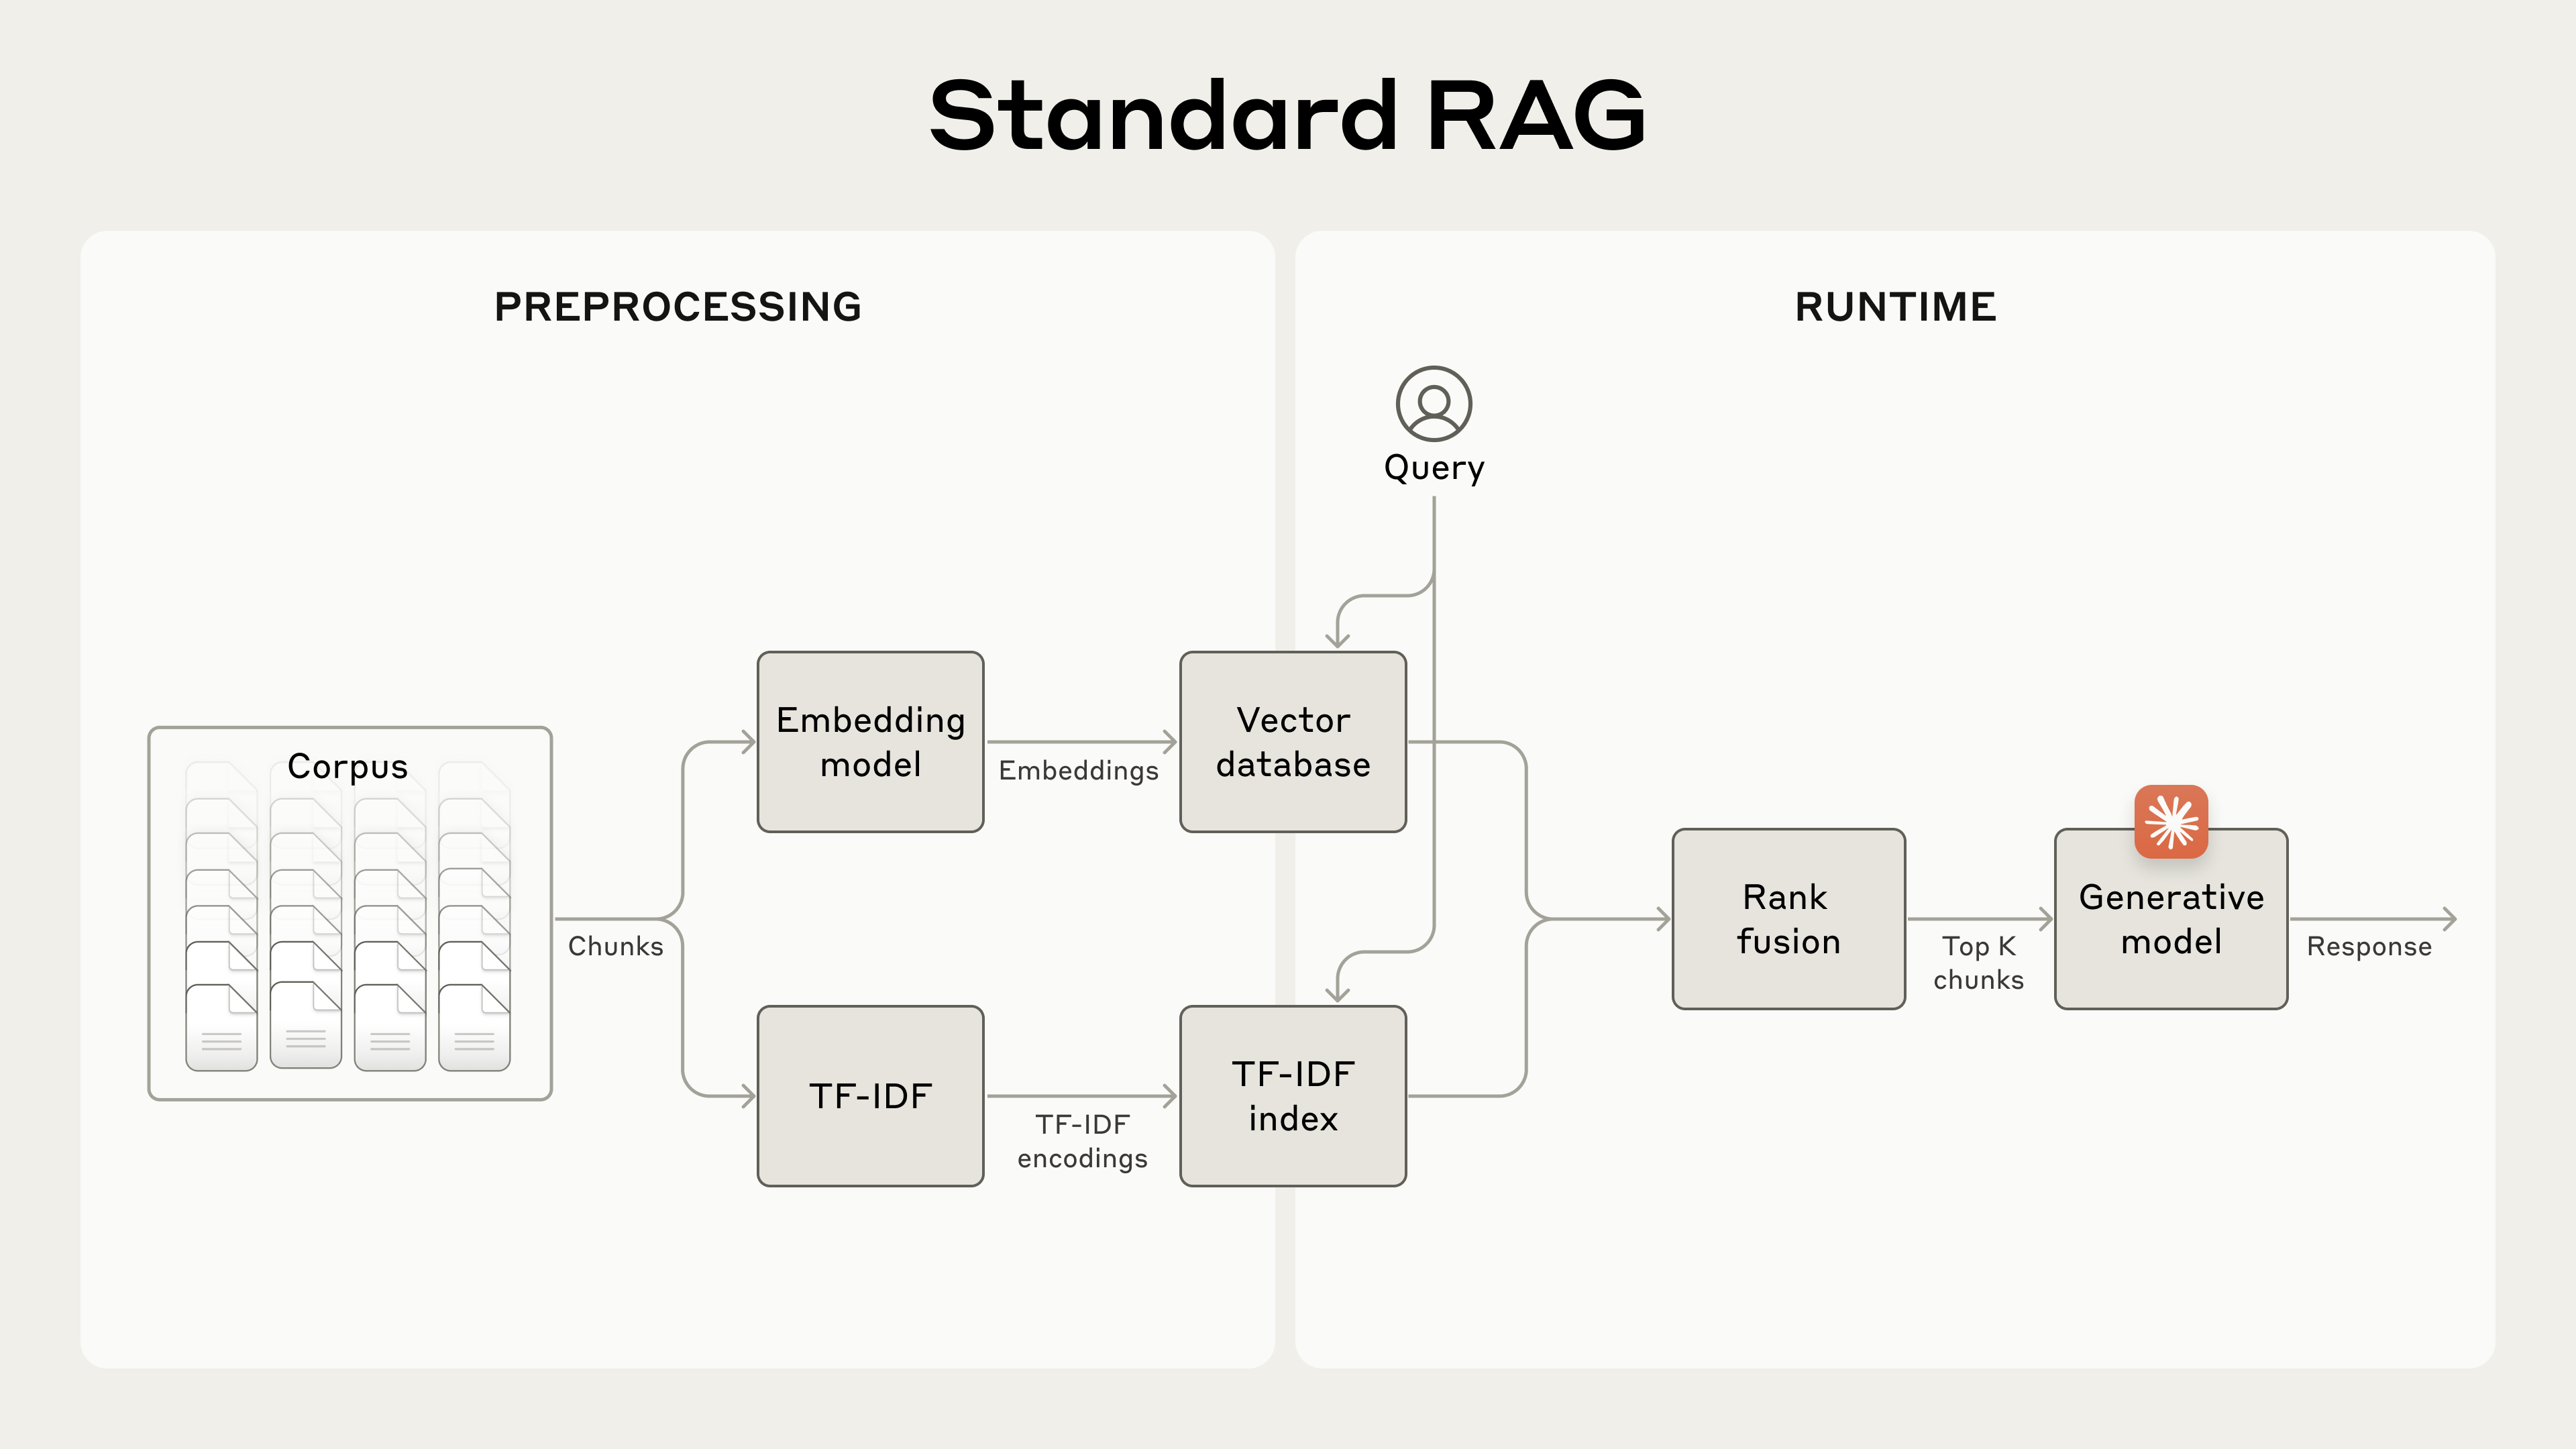 标准检索增强生成(RAG)系统,同时使用嵌入和最佳匹配 25(BM25)来检索信息。TF-IDF(词频-逆文档频率)衡量词的重要性,构成 BM25 的基础。
这种方法允许您以具有成本效益的方式扩展到巨大的知识库,远远超出单个提示词可以容纳的范围。但是这些传统的 RAG 系统有一个重要的限制:它们常常破坏上下文。
传统 RAG 中的上下文困境
在传统的 RAG 中,文档通常被分割成更小的块以实现高效检索。虽然这种方法在许多应用中效果很好,但当单个块缺乏足够的上下文时,它可能会导致问题。
例如,假设您的知识库中嵌入了一系列金融信息(比如美国 SEC 文件),并且您收到了以下问题:"ACME 公司在 2023 年第二季度的收入增长是多少?"
一个相关的块可能包含文本:"公司收入较上一季度增长了 3%。" 但是,这个块本身并没有指明它指的是哪家公司或相关的时间段,这使得难以检索到正确的信息或有效地使用这些信息。
推出上下文检索
上下文检索通过在嵌入("上下文嵌入")和创建 BM25 索引("上下文 BM25")之前为每个块预先添加特定于块的解释性上下文来解决这个问题。
让我们回到我们的 SEC 文件收集示例。以下是一个块如何被转换的例子:
original_chunk = "公司收入较上一季度增长了 3%。"

contextualized_chunk = "这个块来自关于 ACME 公司 2023 年第二季度表现的 SEC 文件;上一季度的收入为 3.14 亿美元。公司收入较上一季度增长了 3%。"
值得注意的是,过去已经提出了其他使用上下文来改进检索的方法。其他提议包括:向块添加通用文档摘要(我们进行了实验,看到的增益非常有限)、假设文档嵌入和基于摘要的索引(我们评估了,性能较低)。这些方法与本文中提出的方法不同。
实施上下文检索
当然,手动注释知识库中的数千甚至数百万个块将是一项太繁重的工作。为了实施上下文检索,我们求助于 Claude。我们编写了一个提示词,指示模型提供简洁的、特定于块的上下文,使用整个文档的上下文来解释该块。我们使用以下 Claude 3 Haiku 提示词为每个块生成上下文:
<document>
{{WHOLE_DOCUMENT}}
</document>
这是我们想要置于整个文档中的块
<chunk>
{{CHUNK_CONTENT}}
</chunk>
请给出简短简洁的上下文,将此块置于整个文档中,以改进该块的搜索检索。只回答简洁的上下文,不要其他内容。
生成的上下文文本通常为 50-100 个令牌,在嵌入块和创建 BM25 索引之前被预先添加到块中。
以下是预处理流程在实践中的样子:
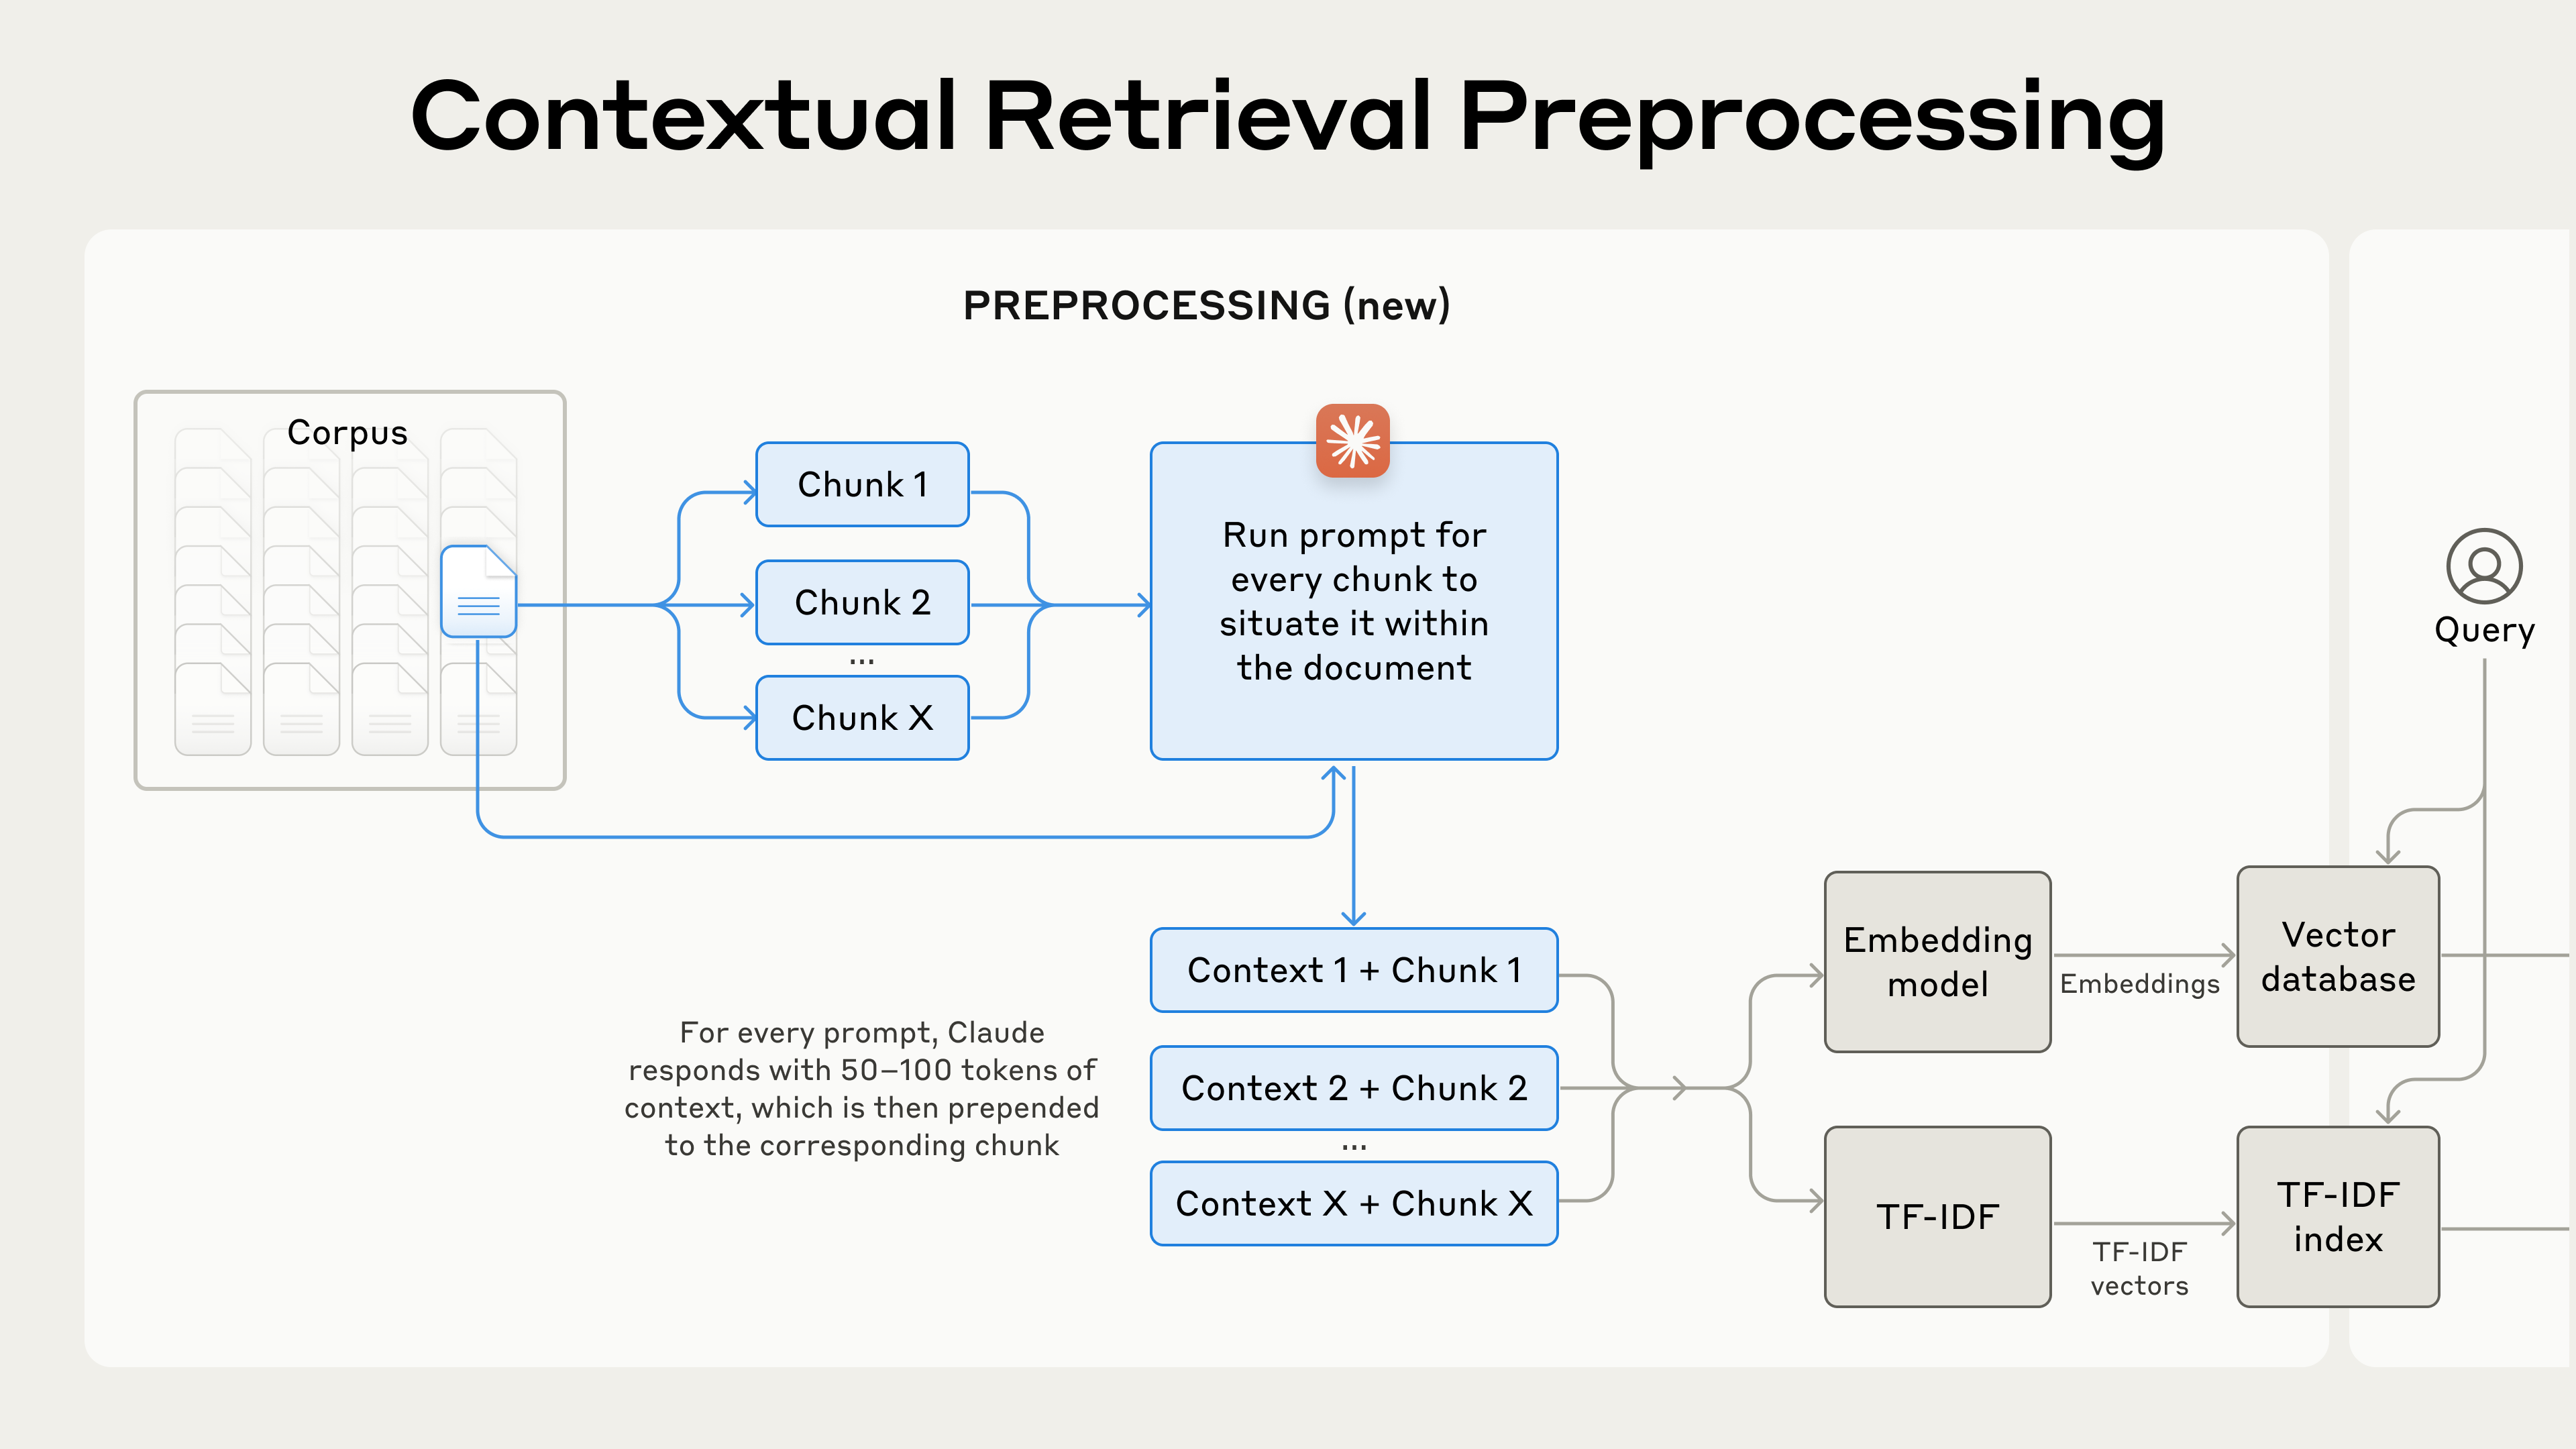 上下文检索是一种提高检索准确性的预处理技术。
如果您有兴趣使用上下文检索,您可以从我们的教程开始。
使用提示词缓存降低上下文检索的成本
由于我们上面提到的特殊提示词缓存功能,上下文检索以低成本使用 Claude 成为独特的可能。使用提示词缓存,您无需为每个块传入参考文档。您只需将文档加载到缓存中一次,然后引用之前缓存的内容。假设 800 个令牌的块、8k 个令牌的文档、50 个令牌的上下文指令和每个块 100 个令牌的上下文,生成上下文化块的一次性成本是每百万文档令牌 1.02 美元。
方法论
我们在各种知识领域(代码库、小说、ArXiv 论文、科学论文)、嵌入模型、检索策略和评估指标中进行了实验。我们在附录 II中包含了每个领域使用的一些问题和答案示例。
下图显示了使用性能最佳的嵌入配置(Gemini Text 004)并检索前 20 个块时所有知识领域的平均性能。我们使用 1 减去 recall@20 作为评估指标,它衡量在前 20 个块中未能检索到的相关文档的百分比。您可以在附录中看到完整结果——在我们评估的每个嵌入-源组合中,上下文化都提高了性能。
性能改进
我们的实验表明:
- 上下文嵌入将前 20 个块的检索失败率降低了 35%(5.7% → 3.7%)。
- 结合上下文嵌入和上下文 BM25 将前 20 个块的检索失败率降低了 49%(5.7% → 2.9%)。
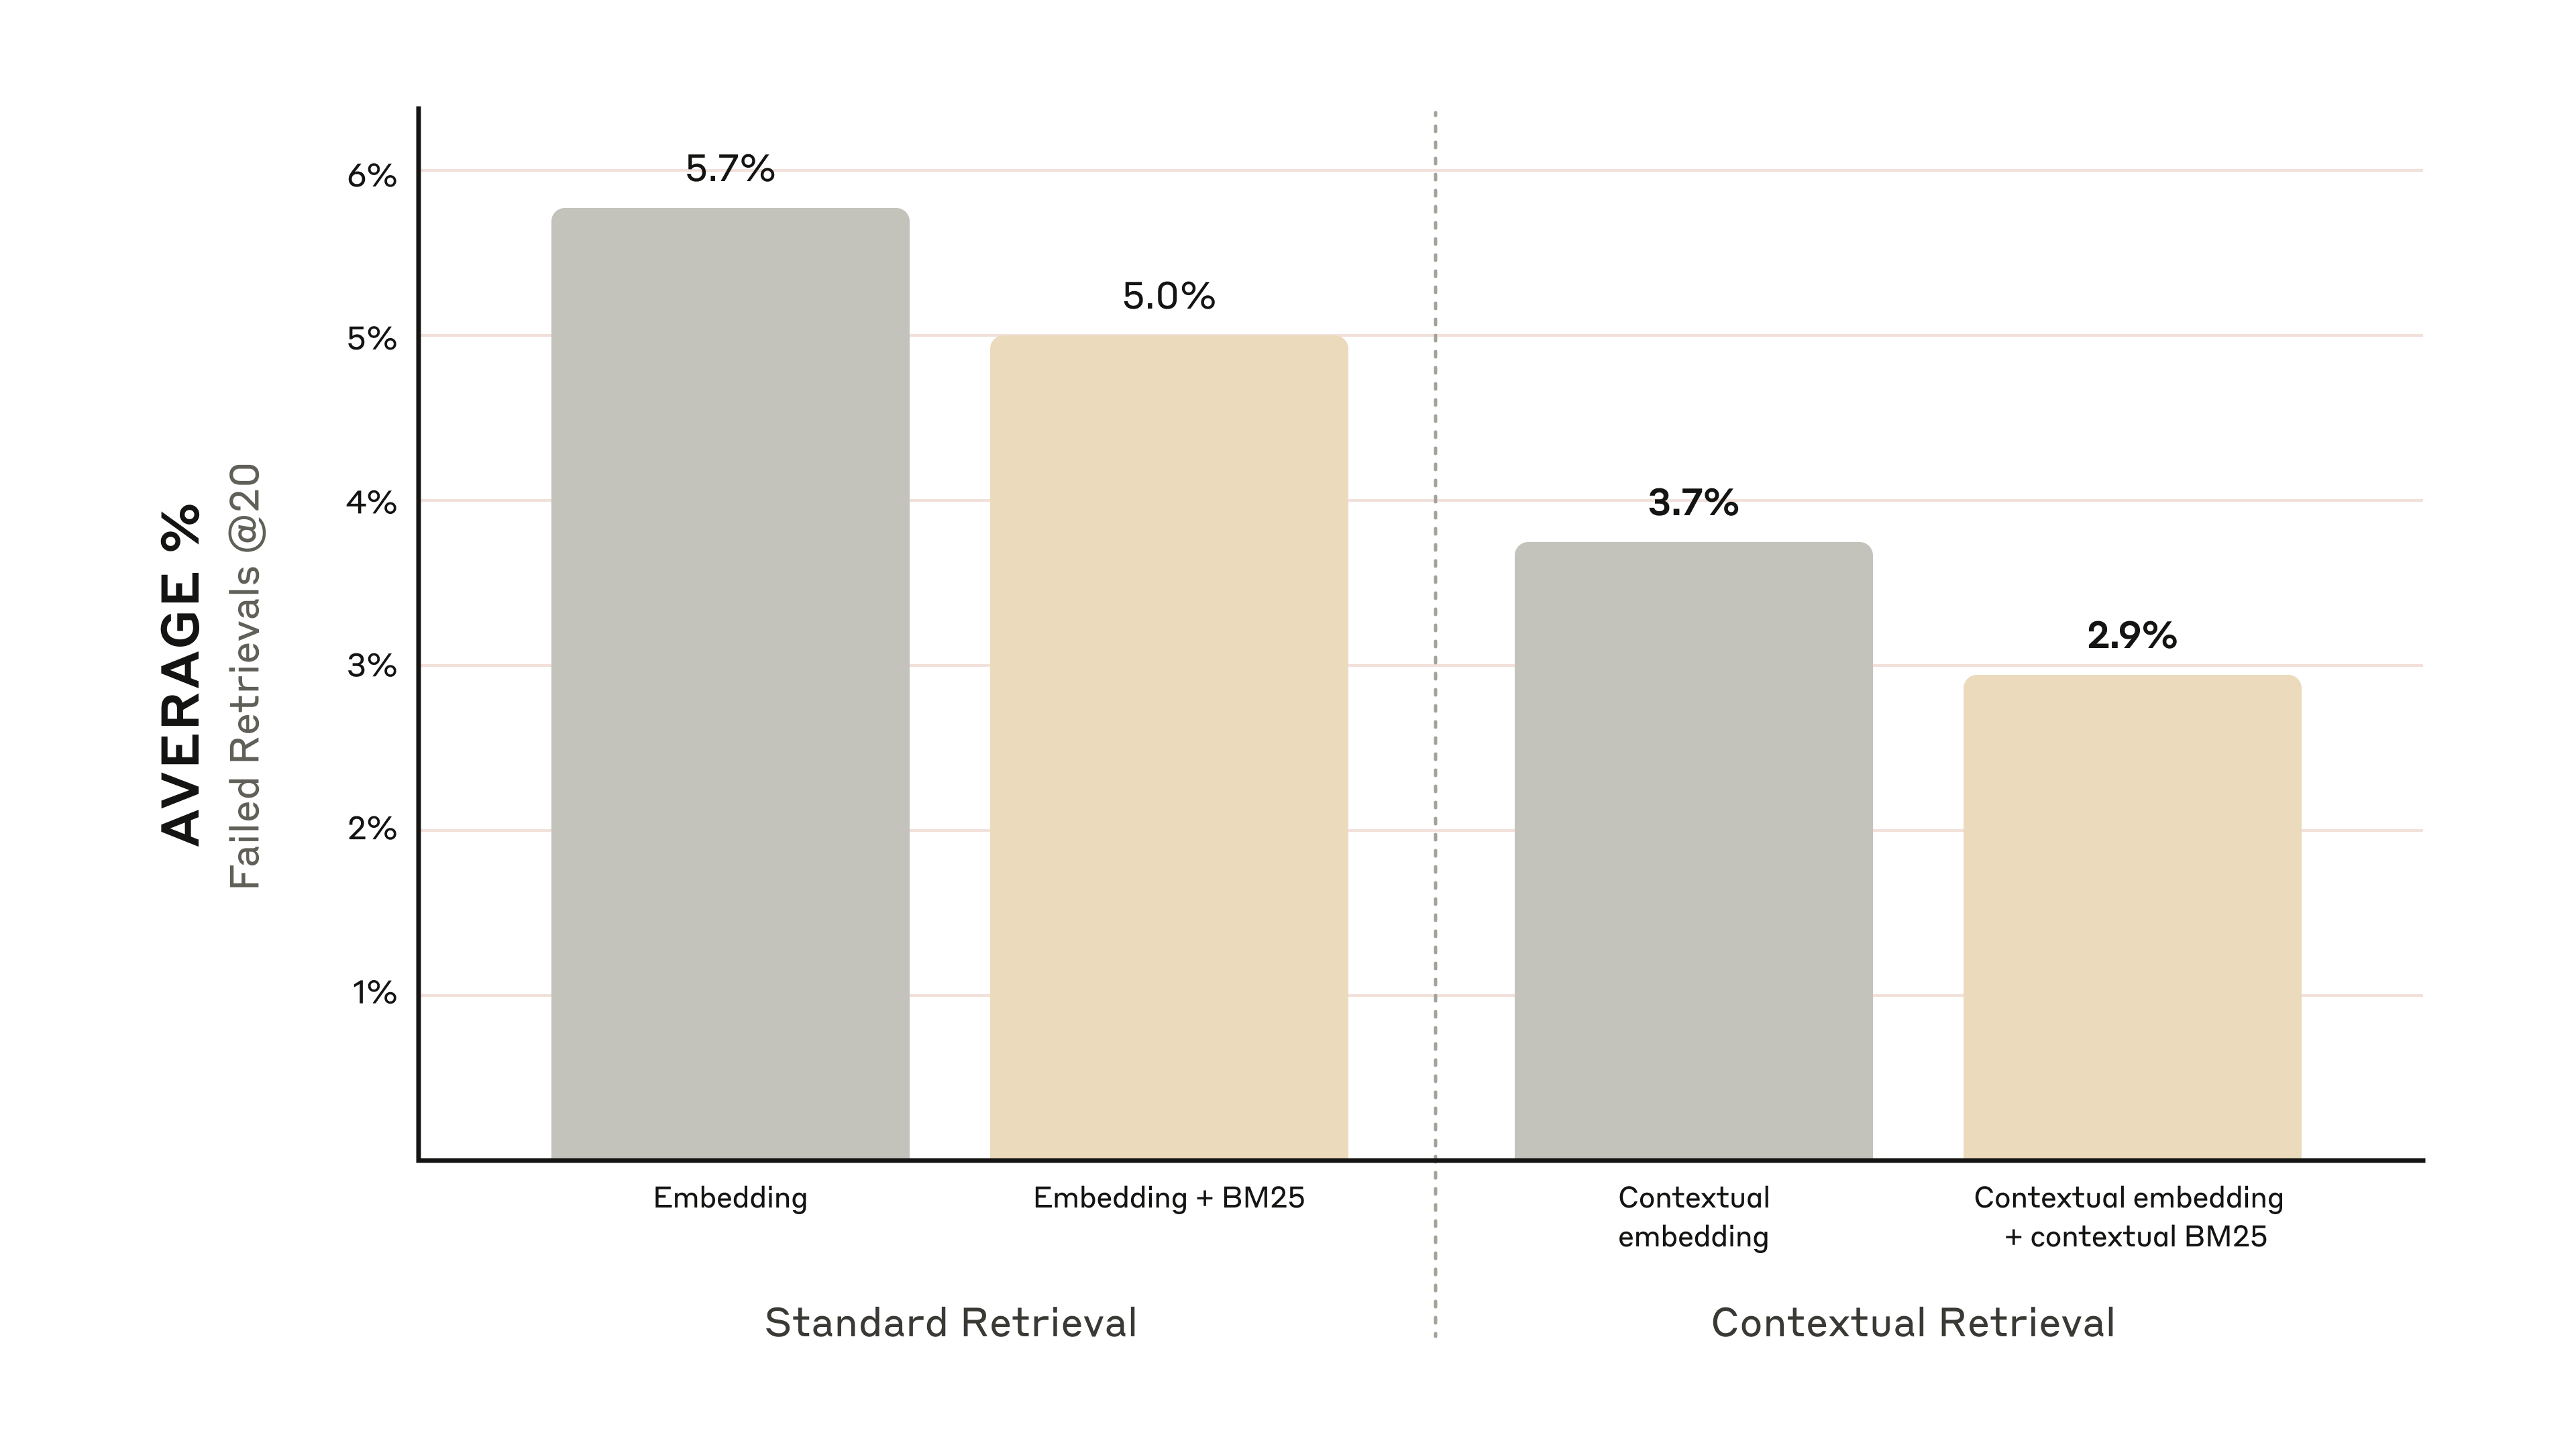 结合上下文嵌入和上下文 BM25 将前 20 个块的检索失败率降低了 49%。
实施注意事项
在实施上下文检索时,需要记住以下几点:
- 块边界: 考虑如何将文档分割成块。块大小、块边界和块重叠的选择会影响检索性能¹。
- 嵌入模型: 虽然上下文检索在我们测试的所有嵌入模型中都提高了性能,但某些模型可能比其他模型受益更多。我们发现 Gemini 和 Voyage 嵌入特别有效。
- 自定义上下文化器提示词: 虽然我们提供的通用提示词效果很好,但您可以使用针对您特定领域或用例定制的提示词来获得更好的结果(例如,包含可能只在知识库中其他文档中定义的关键术语表)。
- 块数量: 向上下文窗口中添加更多块会增加包含相关信息的机会。但是,更多信息可能会分散模型的注意力,因此这是有限度的。我们尝试传递 5、10 和 20 个块,发现使用 20 个块是这些选项中性能最好的(参见附录中的比较),但值得在您的用例上进行实验。
始终运行评估: 通过传递上下文化的块并区分什么是上下文和什么是块,可以改进响应生成。
通过重排序进一步提升性能
在最后一步,我们可以将上下文检索与另一种技术结合起来,以获得更高的性能改进。在传统的 RAG 中,AI 系统搜索其知识库以找到潜在相关的信息块。对于大型知识库,这个初始检索通常会返回很多块——有时是数百个——其相关性和重要性各不相同。
重排序是一种常用的过滤技术,确保只有最相关的块被传递给模型。重排序提供更好的响应并降低成本和延迟,因为模型处理的信息更少。关键步骤是:
- 执行初始检索以获得潜在相关的前几个块(我们使用前 150 个);
- 将前 N 个块连同用户的查询一起传递给重排序模型;
- 使用重排序模型根据其与提示词的相关性和重要性给每个块打分,然后选择前 K 个块(我们使用前 20 个);
- 将前 K 个块作为上下文传递给模型以生成最终结果。
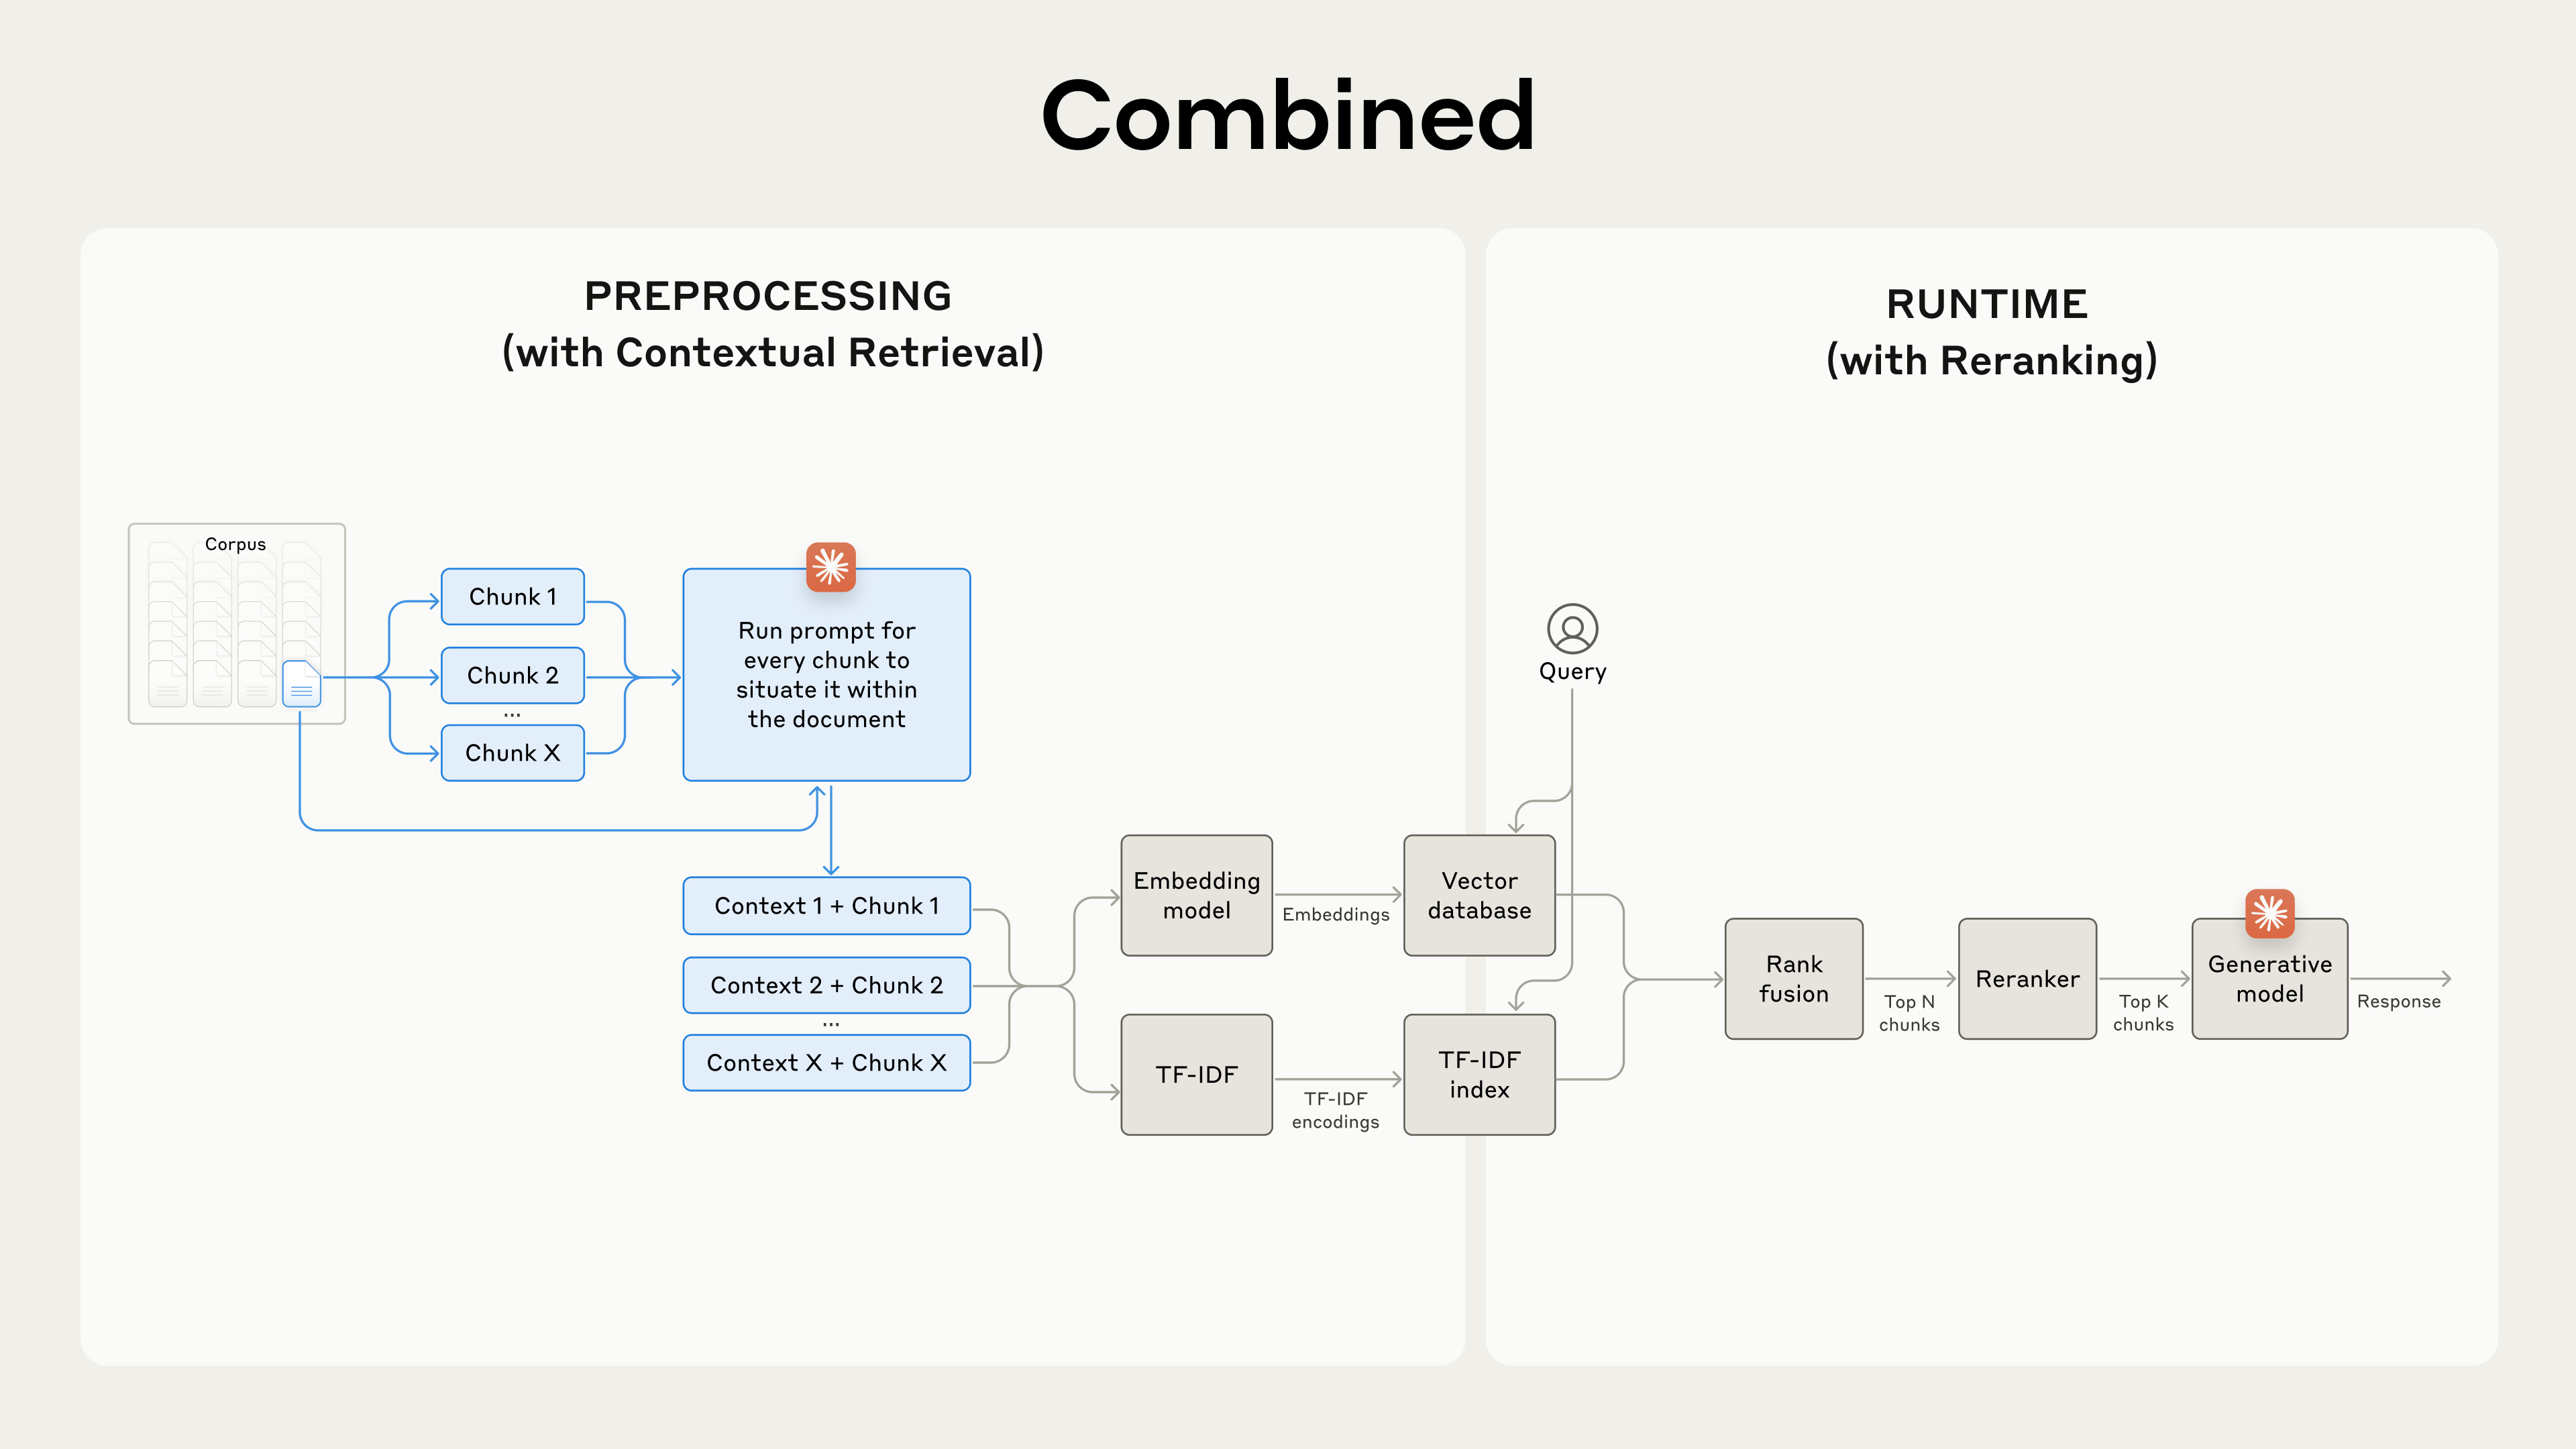 结合上下文检索和重排序以最大化检索准确性。
性能改进
市场上有几种重排序模型。我们使用 Cohere 重排序器 运行了我们的测试。Voyage也提供重排序器,尽管我们没有时间测试它。我们的实验表明,在各个领域中,添加重排序步骤进一步优化了检索。
具体来说,我们发现重排序的上下文嵌入和上下文 BM25 将前 20 个块的检索失败率降低了 67%(5.7% → 1.9%)。
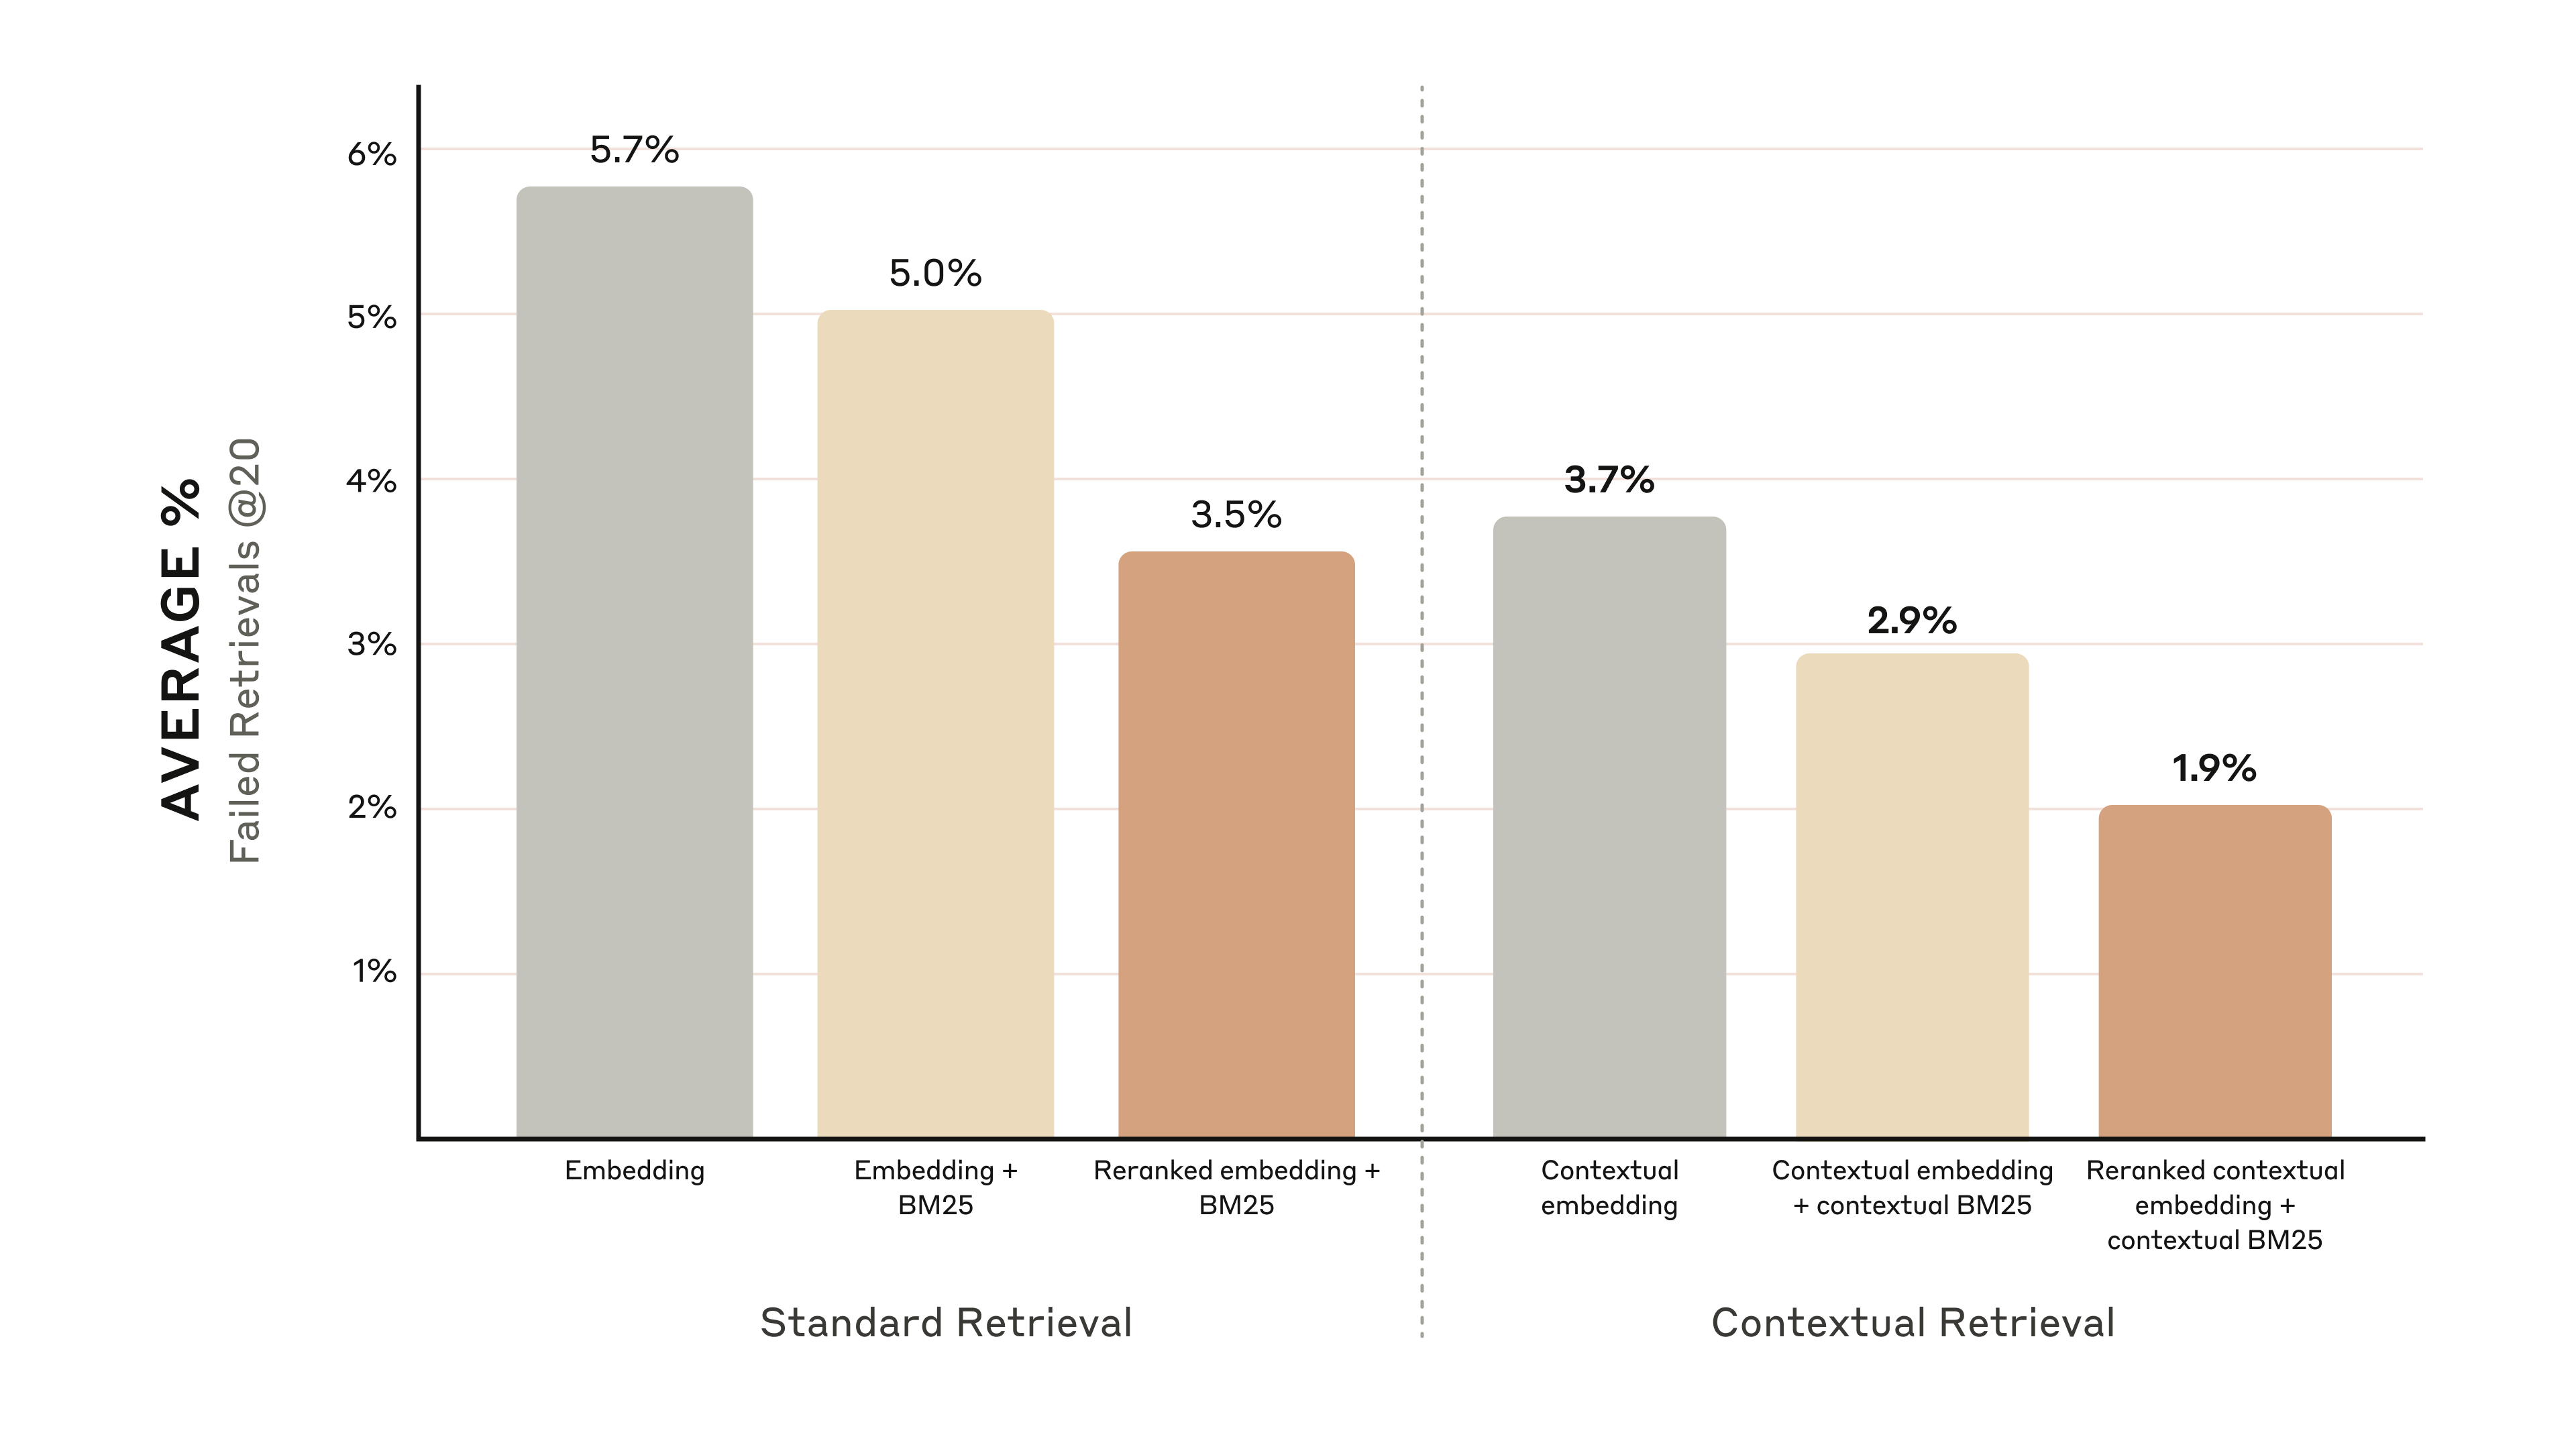 重排序的上下文嵌入和上下文 BM25 将前 20 个块的检索失败率降低了 67%。
成本和延迟考虑
关于重排序的一个重要考虑是对延迟和成本的影响,特别是在重排序大量块时。因为重排序在运行时增加了一个额外步骤,它不可避免地会增加少量延迟,即使重排序器并行处理所有块。在为更好性能重排序更多块与为更低延迟和成本重排序更少块之间存在固有的权衡。我们建议在您的特定用例上试验不同的设置,以找到正确的平衡点。
结论
我们运行了大量测试,比较了上述所有技术的不同组合(嵌入模型、BM25 的使用、上下文检索的使用、重排序器的使用以及检索的前 K 个结果的总数),所有这些都在各种不同的数据集类型上进行。以下是我们发现的总结:
- 嵌入+BM25 优于单独使用嵌入;
- 在我们测试的嵌入中,Voyage 和 Gemini 拥有最好的嵌入;
- 向模型传递前 20 个块比只传递前 10 个或前 5 个更有效;
- 向块添加上下文大大提高了检索准确性;
- 重排序优于不重排序;
- 所有这些好处可以叠加:为了最大化性能改进,我们可以将(来自 Voyage 或 Gemini 的)上下文嵌入与上下文 BM25,加上重排序步骤,以及向提示词添加 20 个块相结合。
我们鼓励所有使用知识库的开发者使用我们的教程来试验这些方法,以释放新的性能水平。
附录 I
以下是跨数据集、嵌入提供商、除嵌入外还使用 BM25、使用上下文检索以及使用重排序的 recall@20 结果分解。
请参阅附录 II以获取 recall@10 和 @5 的分解,以及每个数据集的示例问题和答案。
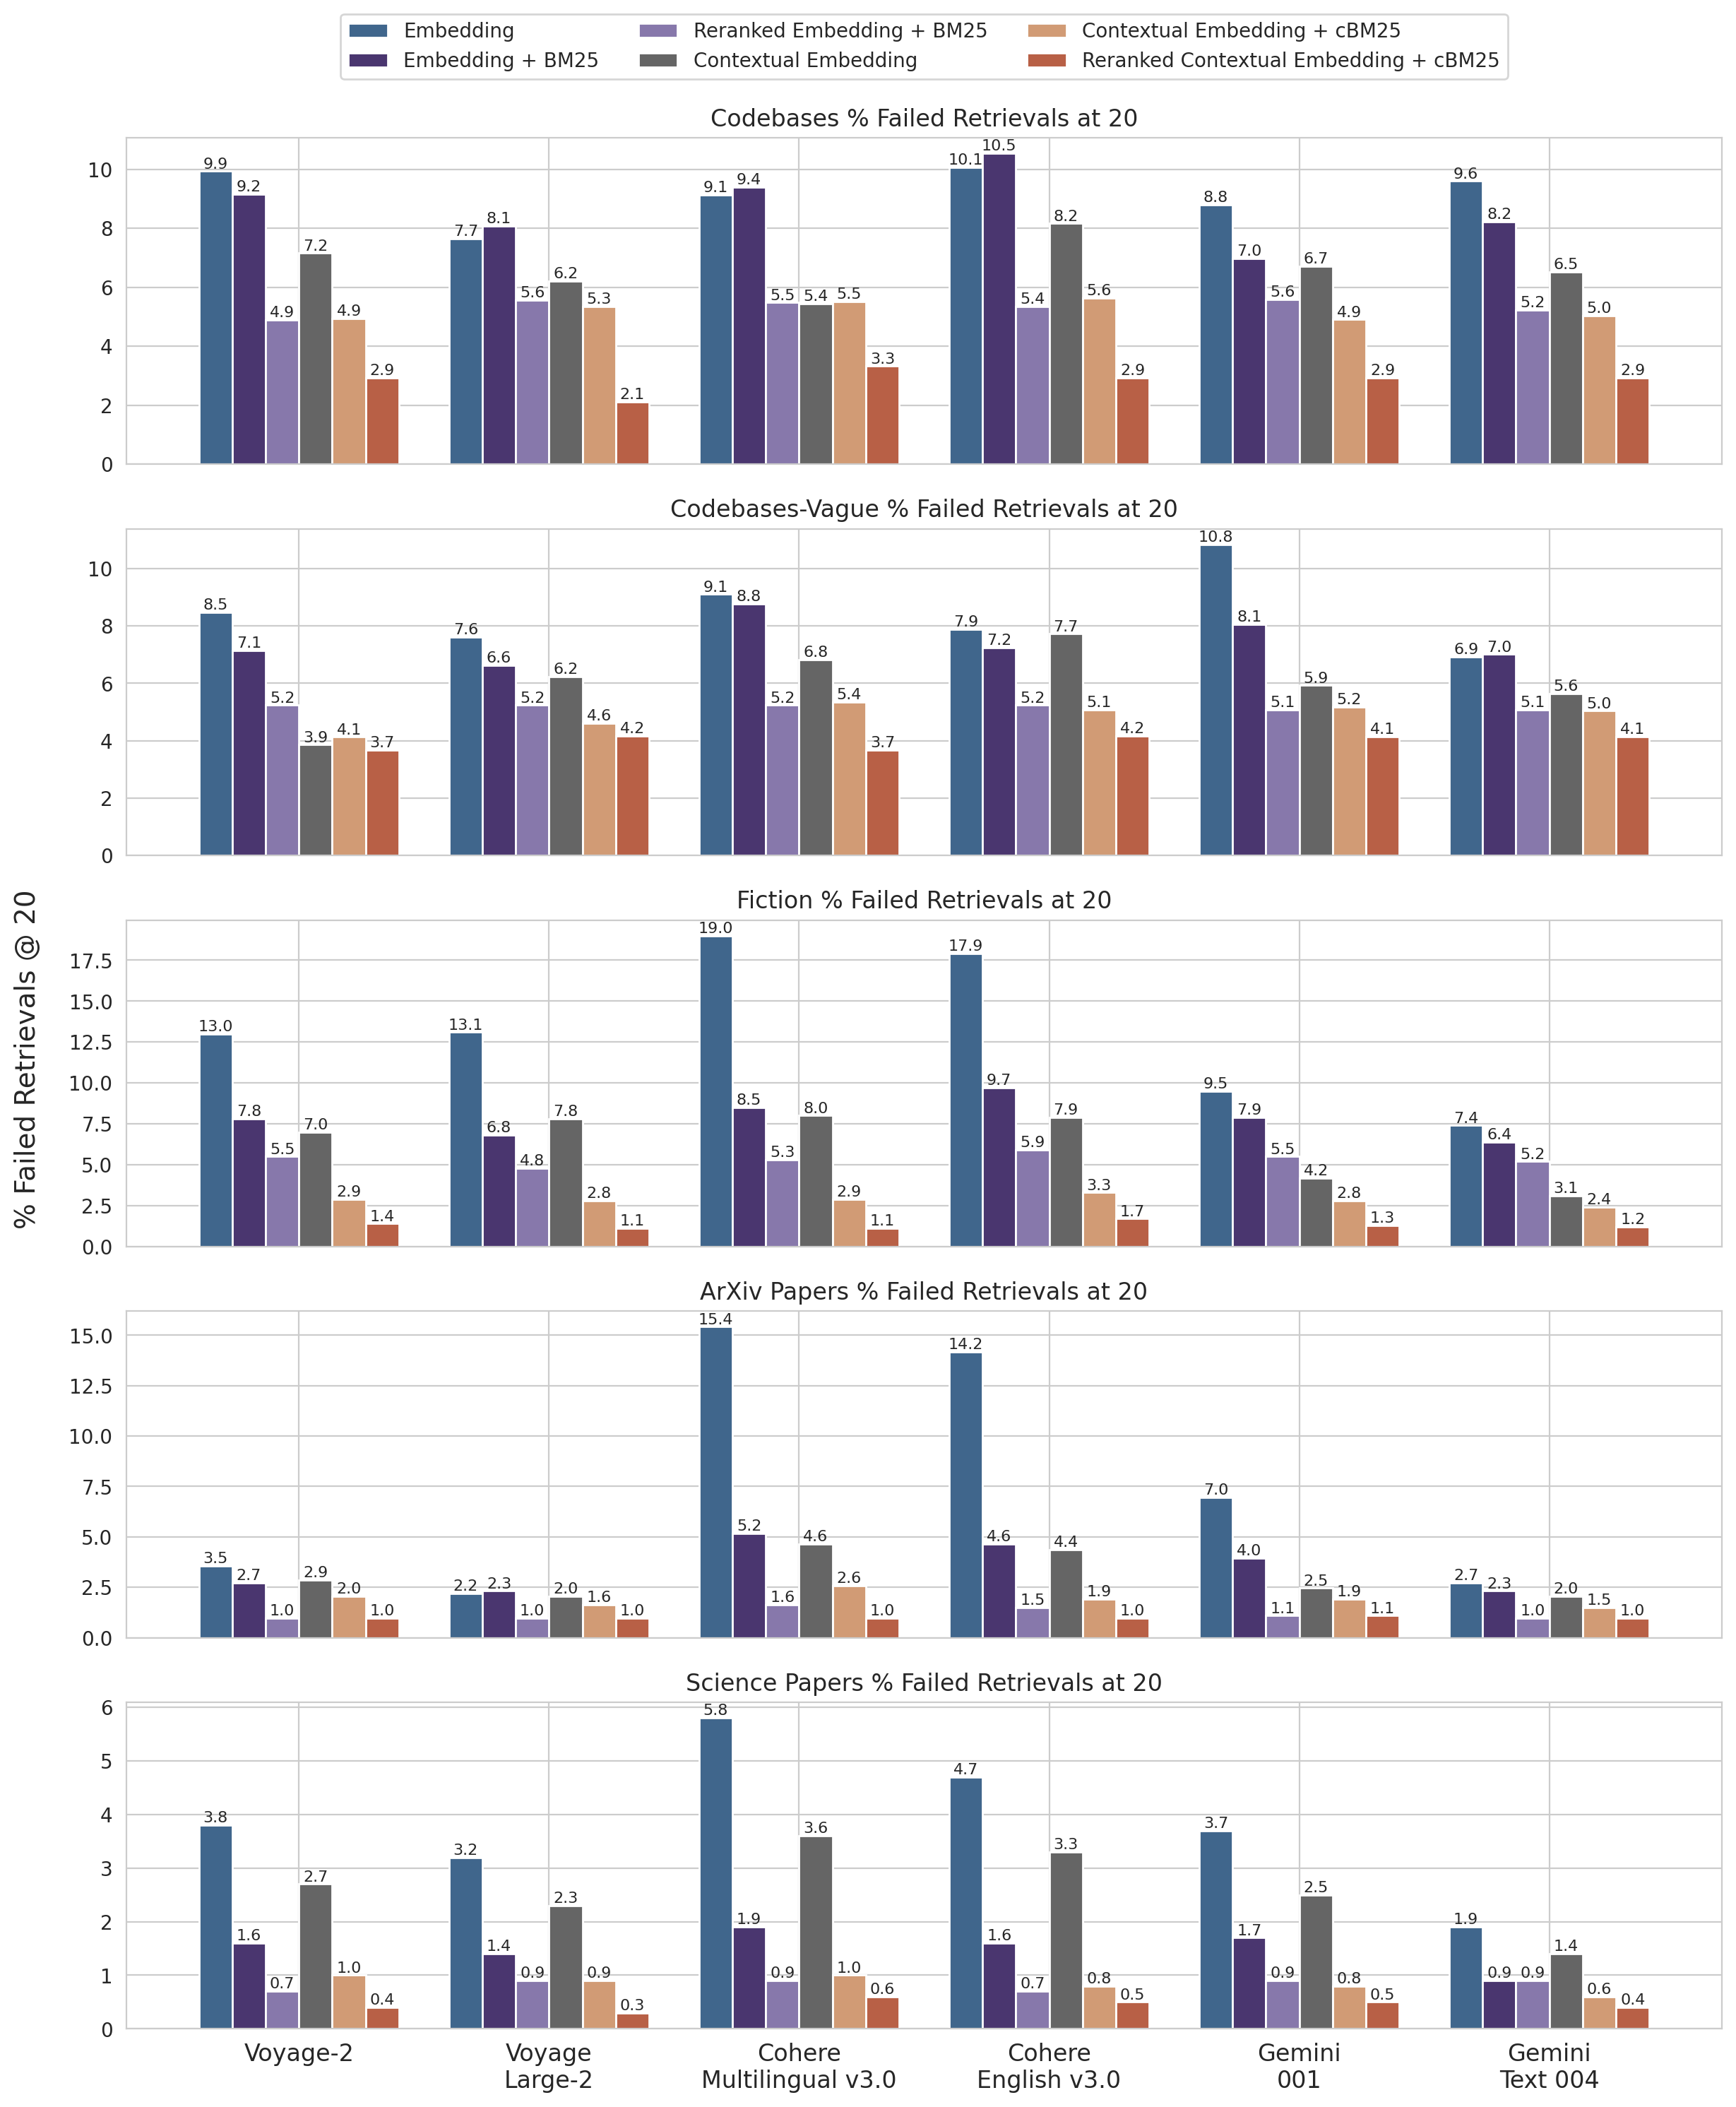 跨数据集和嵌入提供商的 1 减去 recall@20 结果。
致谢
由 Daniel Ford 进行研究和撰写。感谢 Orowa Sikder、Gautam Mittal 和 Kenneth Lien 提供关键反馈,Samuel Flamini 实现教程,Lauren Polansky 进行项目协调,以及 Alex Albert、Susan Payne、Stuart Ritchie 和 Brad Abrams 塑造这篇博客文章。