Claude 开发者平台高级工具使用发布 \ Anthropic
来源: https://www.anthropic.com/engineering/advanced-tool-use 抓取时间: 2026-07-21 16:25:09
AI 智能体的未来是模型可以无缝地跨数百或数千个工具工作。一个集成 Git 操作、文件操作、包管理器、测试框架和部署管道的 IDE 助手。一个可以同时连接 Slack、GitHub、Google Drive、Jira、公司数据库和数十个 MCP 服务器的运营协调器。
为了 构建有效的智能体,它们需要使用无限的工具库,而不是将每个定义预先塞入上下文。我们关于使用 MCP 执行代码 的博客文章讨论了工具结果和定义有时如何在智能体读取请求之前消耗 50,000+ 个令牌。智能体应该按需发现和加载工具,仅保留与当前任务相关的内容。
智能体还需要能够从代码中调用工具。当使用自然语言工具调用时,每次调用都需要完整的推理传递,中间结果无论是否有用都会在上下文中堆积。代码是编排逻辑的天然选择,例如循环、条件和数据转换。智能体需要根据手头任务在代码执行和推理之间灵活选择。
智能体还需要从示例中学习正确的工具使用,而不仅仅是模式定义。JSON 模式定义了结构上有效的内容,但无法表达使用模式:何时包含可选参数、哪些组合有意义,或者您的 API 期望什么约定。
今天,我们发布了三个使这成为可能的功能:
- 工具搜索工具(Tool Search Tool),允许 Claude 使用搜索工具访问数千个工具,而不会消耗其上下文窗口
- 程序化工具调用(Programmatic Tool Calling),允许 Claude 在代码执行环境中调用工具,减少对模型上下文窗口的影响
- 工具使用示例(Tool Use Examples),提供了演示如何有效使用给定工具的通用标准
在内部测试中,我们发现这些功能帮助我们构建了传统工具使用模式无法实现的东西。例如,Claude for Excel 使用程序化工具调用读取和修改数千行的电子表格,而不会使模型的上下文窗口过载。
根据我们的经验,我们相信这些功能为您可以使用 Claude 构建的内容开辟了新的可能性。
工具搜索工具
挑战
MCP 工具定义提供了重要的上下文,但随着更多服务器的连接,这些令牌会累积。考虑一个五服务器设置:
- GitHub:35 个工具(约 26K 令牌)
- Slack:11 个工具(约 21K 令牌)
- Sentry:5 个工具(约 3K 令牌)
- Grafana:5 个工具(约 3K 令牌)
- Splunk:2 个工具(约 2K 令牌)
这是 58 个工具,在对话开始前就消耗了大约 55K 令牌。添加更多服务器如 Jira(仅它就使用约 17K 令牌),您很快就会达到 100K+ 令牌开销。在 Anthropic,我们看到工具定义在优化前消耗了 134K 令牌。
但令牌成本不是唯一的问题。最常见的故障是错误的工具选择和不正确的参数,特别是当工具具有相似的名称如 notification-send-user 与 notification-send-channel 时。
我们的解决方案
工具搜索工具不是预先加载所有工具定义,而是按需发现工具。Claude 只看到它当前任务实际需要的工具。
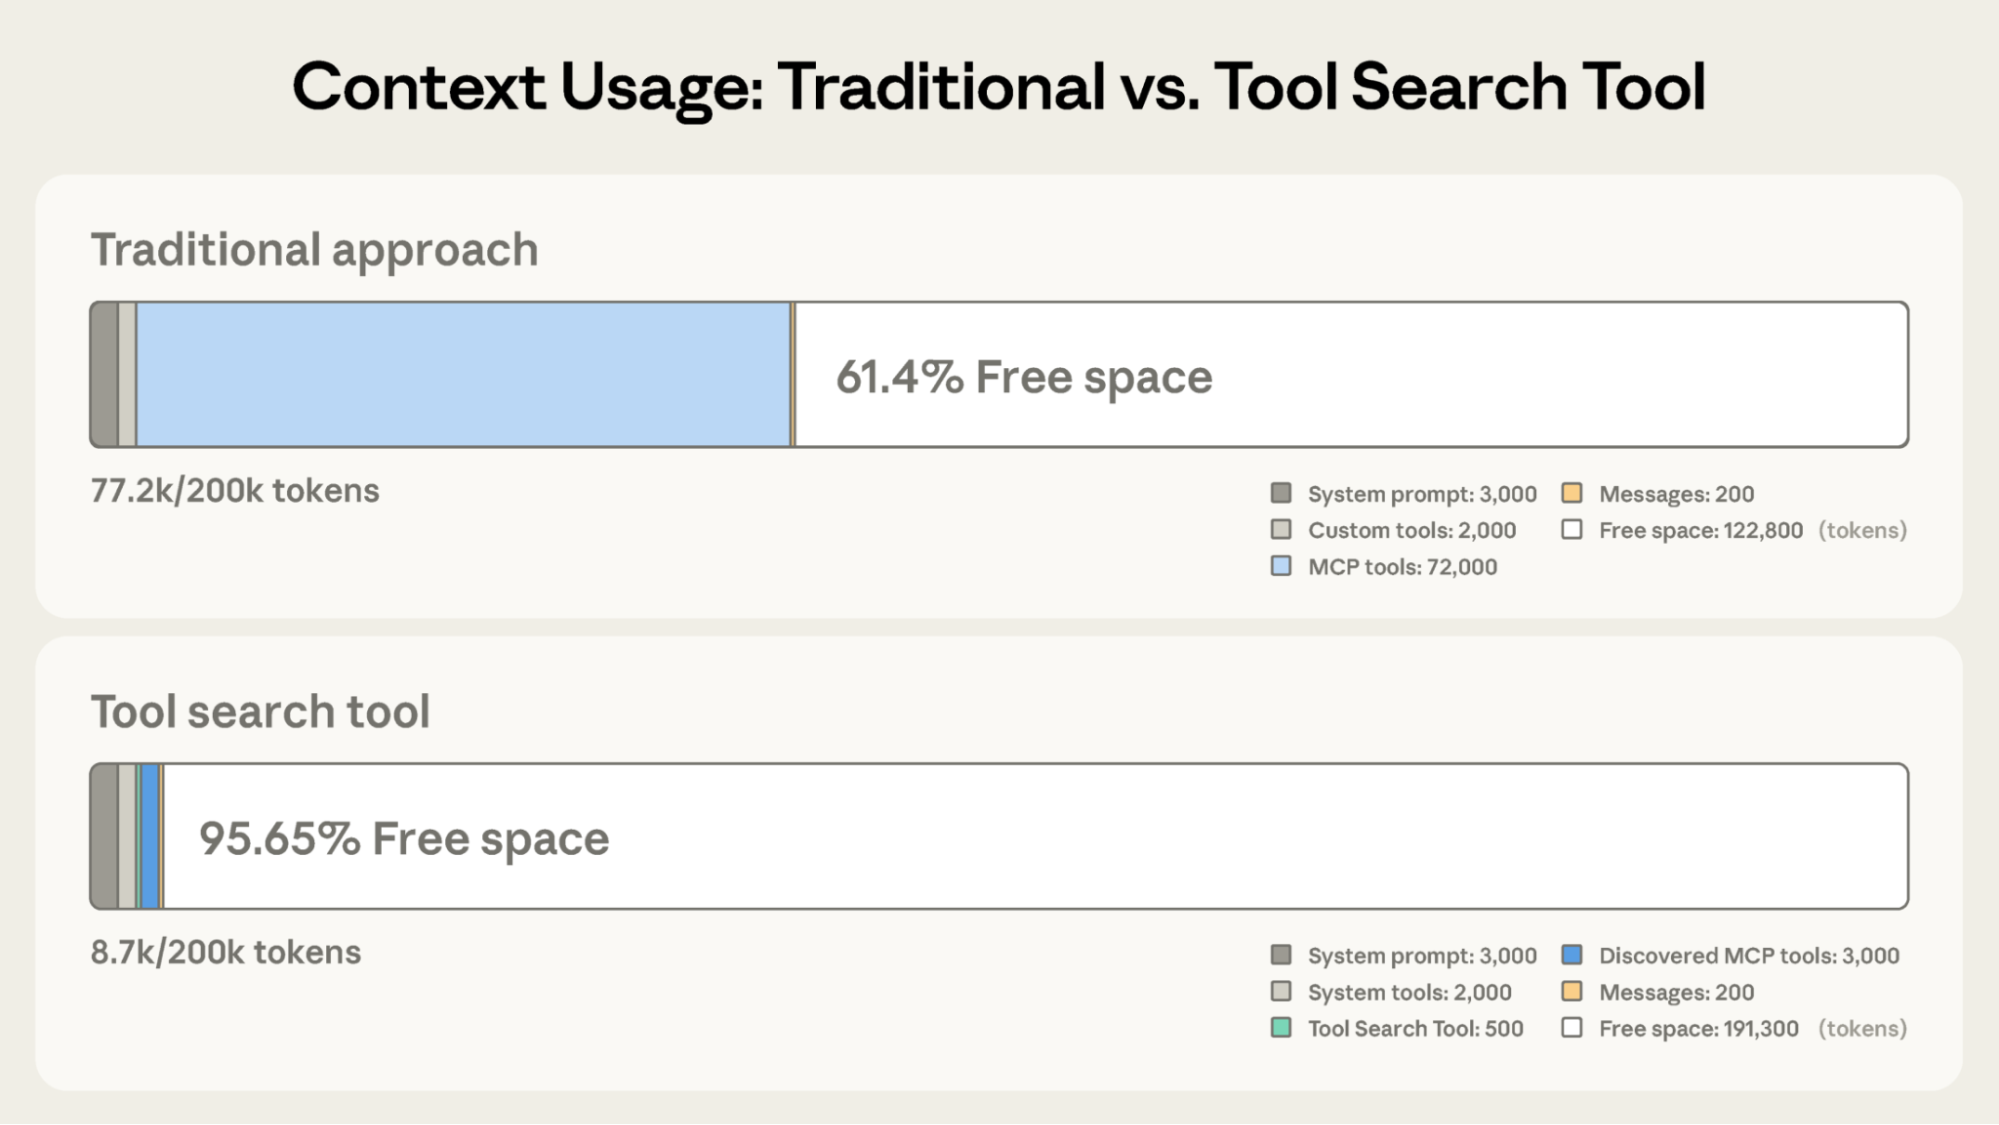 与 Claude 传统方法的 122,800 个令牌相比,工具搜索工具保留了 191,300 个令牌的上下文。
传统方法:
- 所有工具定义预先加载(50+ 个 MCP 工具约 72K 令牌)
- 对话历史和系统提示竞争剩余空间
- 总上下文消耗:任何工作开始前约 77K 令牌
使用工具搜索工具:
- 仅预先加载工具搜索工具本身(约 500 令牌)
- 按需发现所需工具(3-5 个相关工具,约 3K 令牌)
- 总上下文消耗:约 8.7K 令牌,保留 95% 的上下文窗口
这意味着令牌使用减少了 85%,同时保持对完整工具库的访问。内部测试显示,在使用大型工具库时,MCP 评估的准确性有显著提高。启用工具搜索工具后,Opus 4 从 49% 提高到 74%,Opus 4.5 从 79.5% 提高到 88.1%。
工具搜索工具的工作原理
工具搜索工具允许 Claude 动态发现工具,而不是预先加载所有定义。您将所有工具定义提供给 API,但使用 defer_loading: true 标记工具以使其可按需发现。延迟加载的工具最初不会加载到 Claude 的上下文中。Claude 只看到工具搜索工具本身以及任何 defer_loading: false 的工具(您最关键、最常用的工具)。
当 Claude 需要特定功能时,它会搜索相关工具。工具搜索工具返回匹配工具的引用,这些引用会在 Claude 的上下文中扩展为完整定义。
例如,如果 Claude 需要与 GitHub 交互,它会搜索"Github",只加载 github.createPullRequest 和 github.listIssues——而不是您来自 Slack、Jira 和 Google Drive 的其他 50+ 个工具。
这样,Claude 可以访问您的完整工具库,同时只需为实际需要的工具支付令牌成本。
提示缓存说明: 工具搜索工具不会破坏提示缓存,因为延迟加载的工具完全排除在初始提示之外。它们仅在 Claude 搜索后才添加到上下文,因此您的系统提示和核心工具定义仍然可以缓存。
实现:
{
  "tools": [
    // 包含一个工具搜索工具(正则表达式、BM25 或自定义)
    {"type": "tool_search_tool_regex_20251119", "name": "tool_search_tool_regex"},

    // 标记工具以进行按需发现
    {
      "name": "Github.createPullRequest",
      "description": "创建一个拉取请求",
      "input_schema": {...},
      "defer_loading": true
    }
    // ... 数百个更多的延迟加载工具,带有 defer_loading: true
  ]
}
对于 MCP 服务器,您可以延迟加载整个服务器,同时保持特定高使用率工具加载:
{
  "type": "MCP_toolset",
  "MCP_server_name": "google-drive",
  "default_config": {"defer_loading": true}, # 延迟加载整个服务器
  "configs": {
    "search_files": {
      "defer_loading": false
    }  // 保持最常用的工具加载
  }
}
Claude 开发者平台开箱即用地提供了基于正则表达式和基于 BM25 的搜索工具,但您也可以使用嵌入或其他策略实现自定义搜索工具。
何时使用工具搜索工具
与任何架构决策一样,启用工具搜索工具涉及权衡。该功能在工具调用之前添加了一个搜索步骤,因此当上下文节省和准确性改进超过额外延迟时,它会提供最佳的投资回报。
使用场景:
- 工具定义消耗 >10K 令牌
- 遇到工具选择准确性问题
- 构建具有多个服务器的 MCP 驱动系统
- 有 10+ 个可用工具
不太适合的场景:
- 小型工具库(<10 个工具)
- 所有工具在每个会话中都频繁使用
- 工具定义是紧凑的
程序化工具调用
挑战
随着工作流程变得越来越复杂,传统的工具调用会产生两个基本问题:
- 中间结果导致的上下文污染:当 Claude 分析 10MB 日志文件以查找错误模式时,整个文件会进入其上下文窗口,尽管 Claude 只需要错误频率的摘要。当跨多个表获取客户数据时,每条记录都会在上下文中累积,无论其相关性如何。这些中间结果会消耗大量令牌预算,并可能将重要信息完全推出上下文窗口。
- 推理开销和手动综合:每个工具调用都需要完整的模型推理传递。收到结果后,Claude 必须"目测"数据以提取相关信息,推理各个部分如何组合在一起,并决定下一步做什么——所有这些都通过自然语言处理。一个五工具工作流程意味着五次推理传递,加上 Claude 解析每个结果、比较值和综合结论。这既缓慢又容易出错。
我们的解决方案
程序化工具调用使 Claude 能够通过代码而不是通过单独的 API 往返来编排工具。Claude 不是逐个请求工具,每个结果都返回到其上下文,而是编写调用多个工具、处理其输出并控制实际进入其上下文窗口的信息的代码。
Claude 擅长编写代码,通过让它用 Python 而不是通过自然语言工具调用来表达编排逻辑,您可以获得更可靠、更精确的控制流。循环、条件、数据转换和错误处理都在代码中明确表示,而不是隐含在 Claude 的推理中。
示例:预算合规检查
考虑一个常见的业务任务:"哪些团队成员超出了他们的 Q3 旅行预算?"
您有三个可用工具:
get_team_members(department)- 返回带有 ID 和级别的团队成员列表get_expenses(user_id, quarter)- 返回用户的费用明细get_budget_by_level(level)- 返回员工级别的预算限制
传统方法:
- 获取团队成员 → 20 人
- 对于每个人,获取他们的 Q3 费用 → 20 次工具调用,每次返回 50-100 个明细(航班、酒店、餐饮、收据)
- 按员工级别获取预算限制
- 所有这些都进入 Claude 的上下文:2,000+ 个费用明细(50 KB+)
- Claude 手动汇总每个人的费用,查找他们的预算,比较费用与预算限制
- 更多往返于模型,显著的上下文消耗
使用程序化工具调用: 每个工具结果都不会返回给 Claude,而是由 Claude 编写一个 Python 脚本来编排整个工作流程。该脚本在代码执行工具(沙盒环境)中运行,需要工具结果时暂停。当您通过 API 返回工具结果时,它们由脚本处理而不是由模型消耗。脚本继续执行,Claude 只看到最终输出。
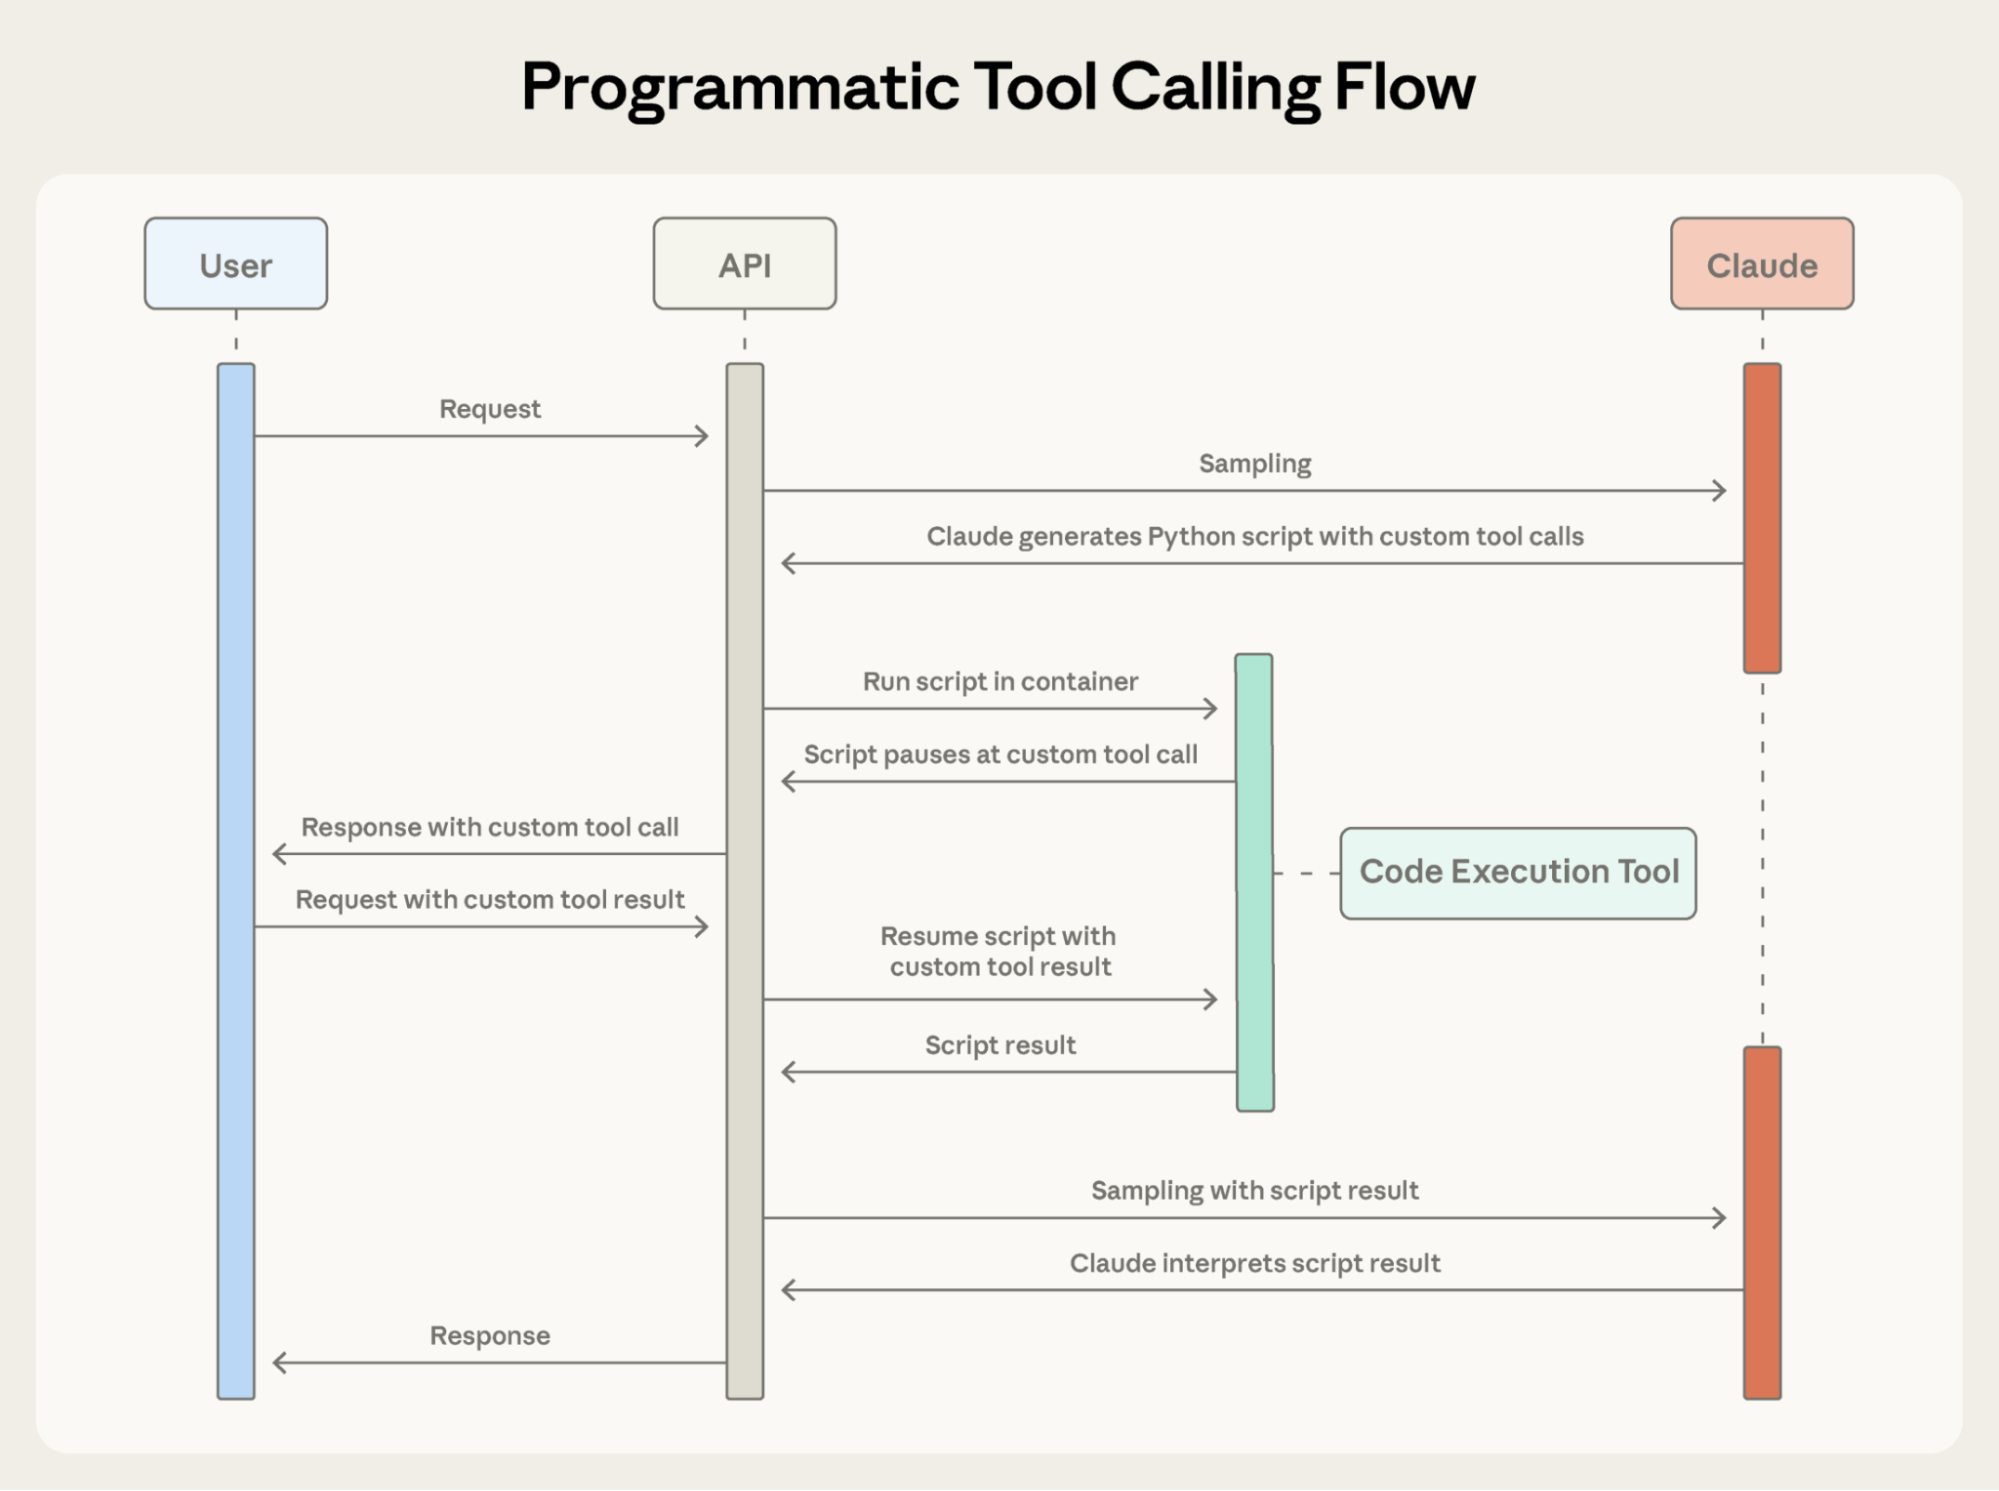 程序化工具调用使 Claude 能够通过代码而不是通过单独的 API 往返来编排工具,允许并行工具执行。
以下是 Claude 为预算合规任务编写的编排代码:
team = await get_team_members("engineering")

# 获取每个唯一级别的预算
levels = list(set(m["level"] for m in team))
budget_results = await asyncio.gather(*[
    get_budget_by_level(level) for level in levels
])

# 创建查找字典:{"junior": budget1, "senior": budget2, ...}
budgets = {level: budget for level, budget in zip(levels, budget_results)}

# 并行获取所有费用
expenses = await asyncio.gather(*[
    get_expenses(m["id"], "Q3") for m in team
])

# 找出超出旅行预算的员工
exceeded = []
for member, exp in zip(team, expenses):
    budget = budgets[member["level"]]
    total = sum(e["amount"] for e in exp)
    if total > budget["travel_limit"]:
        exceeded.append({
            "name": member["name"],
            "spent": total,
            "limit": budget["travel_limit"]
        })

print(json.dumps(exceeded))
Claude 的上下文只接收最终结果:超出预算的两到三个人。2,000+ 个明细、中间汇总和预算查找不会影响 Claude 的上下文,将消耗从 200KB 的原始费用数据减少到仅 1KB 的结果。
效率提升是显著的:
- 令牌节省:通过将中间结果排除在 Claude 的上下文之外,PTC 大大减少了令牌消耗。复杂研究任务的平均使用量从 43,588 个令牌下降到 27,297 个令牌,减少了 37%。
- 减少延迟:每次 API 往返都需要模型推理(数百毫秒到几秒)。当 Claude 在单个代码块中编排 20+ 个工具调用时,您消除了 19+ 次推理传递。API 处理工具执行,而不需要每次都返回给模型。
- 提高准确性:通过编写明确的编排逻辑,Claude 犯的错误比用自然语言处理多个工具结果时少。内部知识检索从 25.6% 提高到 28.5%;GIA 基准 从 46.5% 提高到 51.2%。
生产工作流程涉及混乱的数据、条件逻辑和需要扩展的操作。程序化工具调用让 Claude 以编程方式处理这种复杂性,同时将其重点放在可操作的结果上,而不是原始数据处理。
程序化工具调用的工作原理
1. 将工具标记为可从代码调用
向工具添加 code_execution,并为选择加入的工具设置 allowed_callers 以进行程序化执行:
{
  "tools": [
    {
      "type": "code_execution_20250825",
      "name": "code_execution"
    },
    {
      "name": "get_team_members",
      "description": "获取部门的所有成员...",
      "input_schema": {...},
      "allowed_callers": ["code_execution_20250825"] # 选择加入程序化工具调用
    },
    {
      "name": "get_expenses",
      ...
    },
    {
      "name": "get_budget_by_level",
      ...
    }
  ]
}
API 将这些工具定义转换为 Claude 可以调用的 Python 函数。
2. Claude 编写编排代码
Claude 不是逐个请求工具,而是生成 Python 代码:
{
  "type": "server_tool_use",
  "id": "srvtoolu_abc",
  "name": "code_execution",
  "input": {
    "code": "team = get_team_members('engineering')\n..." # 上面的代码示例
  }
}
3. 工具执行而不进入 Claude 的上下文
当代码调用 get_expenses() 时,您会收到带有 caller 字段的工具请求:
{
  "type": "tool_use",
  "id": "toolu_xyz",
  "name": "get_expenses",
  "input": {"user_id": "emp_123", "quarter": "Q3"},
  "caller": {
    "type": "code_execution_20250825",
    "tool_id": "srvtoolu_abc"
  }
}
您提供结果,该结果在代码执行环境中处理,而不是在 Claude 的上下文中处理。此请求-响应循环对代码中的每个工具调用重复。
4. 仅最终输出进入上下文
代码运行完成后,仅将代码结果返回给 Claude:
{
  "type": "code_execution_tool_result",
  "tool_use_id": "srvtoolu_abc",
  "content": {
    "stdout": "[{\"name\": \"Alice\", \"spent\": 12500, \"limit\": 10000}...]"
  }
}
这是 Claude 看到的全部,而不是沿途处理的 2000+ 个费用明细。
何时使用程序化工具调用
程序化工具调用向您的工作流程添加了代码执行步骤。当令牌节省、延迟改进和准确性增益是实质性的时,这种额外开销会得到回报。
最适合的场景:
- 处理您只需要聚合或摘要的大型数据集
- 运行具有三个或更多依赖工具调用的多步骤工作流程
- 在 Claude 看到工具结果之前对其进行过滤、排序或转换
- 处理中间数据不应影响 Claude 推理的任务
- 跨多个项目运行并行操作(例如,检查 50 个端点)
不太适合的场景:
- 进行简单的单工具调用
- 处理 Claude 应该看到并推理所有中间结果的任务
- 运行具有小响应的快速查找
工具使用示例
挑战
JSON 模式擅长定义结构——类型、必填字段、允许的枚举——但它无法表达使用模式:何时包含可选参数、哪些组合有意义,或者您的 API 期望什么约定。
考虑一个支持工单 API:
{
  "name": "create_ticket",
  "input_schema": {
    "properties": {
      "title": {"type": "string"},
      "priority": {"enum": ["low", "medium", "high", "critical"]},
      "labels": {"type": "array", "items": {"type": "string"}},
      "reporter": {
        "type": "object",
        "properties": {
          "id": {"type": "string"},
          "name": {"type": "string"},
          "contact": {
            "type": "object",
            "properties": {
              "email": {"type": "string"},
              "phone": {"type": "string"}
            }
          }
        }
      },
      "due_date": {"type": "string"},
      "escalation": {
        "type": "object",
        "properties": {
          "level": {"type": "integer"},
          "notify_manager": {"type": "boolean"},
          "sla_hours": {"type": "integer"}
        }
      }
    },
    "required": ["title"]
  }
}
模式定义了什么是有效的,但留下了关键问题没有回答:
- 格式歧义:
due_date应该使用"2024-11-06"、"Nov 6, 2024" 还是"2024-11-06T00:00:00Z"? - ID 约定:
reporter.id是 UUID、"USR-12345" 还是仅"12345"? - 嵌套结构使用:Claude 应该何时填充
reporter.contact? - 参数相关性:
escalation.level和escalation.sla_hours如何与优先级相关?
这些歧义可能导致格式错误的工具调用和不一致的参数使用。
我们的解决方案
工具使用示例让您可以直接在工具定义中提供示例工具调用。您不是仅依赖模式,而是向 Claude 展示具体的使用模式:
{
    "name": "create_ticket",
    "input_schema": { /* 与上面相同的模式 */ },
    "input_examples": [
      {
        "title": "登录页面返回 500 错误",
        "priority": "critical",
        "labels": ["bug", "authentication", "production"],
        "reporter": {
          "id": "USR-12345",
          "name": "Jane Smith",
          "contact": {
            "email": "jane@acme.com",
            "phone": "+1-555-0123"
          }
        },
        "due_date": "2024-11-06",
        "escalation": {
          "level": 2,
          "notify_manager": true,
          "sla_hours": 4
        }
      },
      {
        "title": "添加暗模式支持",
        "labels": ["feature-request", "UI"],
        "reporter": {
          "id": "USR-67890",
          "name": "Alex Chen"
        }
      },
      {
        "title": "更新 API 文档"
      }
    ]
  }
从这三个示例中,Claude 学习到:
- 格式约定:日期使用 YYYY-MM-DD,用户 ID 遵循 USR-XXXXX,标签使用 kebab-case
- 嵌套结构模式:如何构建带有嵌套联系对象的报告者对象
- 可选参数相关性:严重错误有完整的联系信息 + 带有严格 SLA 的升级;功能请求有报告者但没有联系/升级;内部任务只有标题
在我们自己的内部测试中,工具使用示例在复杂参数处理上将准确性从 72% 提高到 90%。
何时使用工具使用示例
工具使用示例向您的工具定义添加了令牌,因此当准确性改进超过额外成本时它们最有价值。
最适合的场景:
- 复杂的嵌套结构,其中有效的 JSON 并不意味着正确的使用
- 具有许多可选参数且包含模式很重要的工具
- 模式中未捕获的具有领域特定约定的 API
- 示例可以澄清使用哪个的相似工具(例如,
create_ticket与create_incident)
不太适合的场景:
- 使用明显的简单单参数工具
- Claude 已经理解的标准格式,如 URL 或电子邮件
- 由 JSON 模式约束更好地处理的验证问题
最佳实践
构建采取真实世界行动的智能体意味着同时处理规模、复杂性和精确性。这三个功能协同工作,以解决工具使用工作流程中的不同瓶颈。以下是如何有效组合它们。
战略性地分层功能
不是每个智能体都需要为给定任务使用所有三个功能。从您最大的瓶颈开始:
- 工具定义导致的上下文膨胀 → 工具搜索工具
- 污染上下文的大型中间结果 → 程序化工具调用
- 参数错误和格式错误的调用 → 工具使用示例
这种专注的方法让您解决限制智能体性能的特定约束,而不是预先增加复杂性。
然后根据需要添加其他功能。它们是互补的:工具搜索工具确保找到正确的工具,程序化工具调用确保高效执行,工具使用示例确保正确调用。
设置工具搜索工具以获得更好的发现
工具搜索与名称和描述匹配,因此清晰、描述性的定义提高了发现准确性。
// 好
{
    "name": "search_customer_orders",
    "description": "按日期范围、状态或总金额搜索客户订单。返回订单详细信息,包括项目、运输和支付信息。"
}

// 差
{
    "name": "query_db_orders",
    "description": "执行订单查询"
}
添加系统提示指导,以便 Claude 知道可用的内容:
您可以访问用于 Slack 消息传递、Google Drive 文件管理、
Jira 工单跟踪和 GitHub 仓库操作的工具。使用工具搜索
来查找特定功能。
保持您的三到五个最常用工具始终加载,延迟加载其余的。这平衡了常见操作的即时访问与其他所有内容的按需发现。
设置程序化工具调用以获得正确执行
由于 Claude 编写代码来解析工具输出,因此请清晰地记录返回格式。这有助于 Claude 编写正确的解析逻辑:
{
    "name": "get_orders",
    "description": "检索客户的订单。
返回:
    订单对象列表,每个包含:
    - id (str): 订单标识符
    - total (float): 订单总金额,美元
    - status (str): 'pending'、'shipped'、'delivered' 之一
    - items (list): {sku, quantity, price} 的数组
    - created_at (str): ISO 8601 时间戳"
}
请参阅以下受益于程序化编排的选择加入工具:
- 可以并行运行的工具(独立操作)
- 重试安全的操作(幂等)
设置工具使用示例以提高参数准确性
为行为清晰度精心设计示例:
- 使用现实数据(真实城市名称、合理价格,而不是"string"或"value")
- 展示最少、部分和完整规范模式的多样性
- 保持简洁:每个工具 1-5 个示例
- 关注歧义(仅在从模式看正确用法不明显的地方添加示例)
开始使用
这些功能在测试版中可用。要启用它们,添加测试版头并包含您需要的工具:
client.beta.messages.create(
    betas=["advanced-tool-use-2025-11-20"],
    model="claude-sonnet-4-5-20250929",
    max_tokens=4096,
    tools=[
        {"type": "tool_search_tool_regex_20251119", "name": "tool_search_tool_regex"},
        {"type": "code_execution_20250825", "name": "code_execution"},
        # 您的工具,带有 defer_loading、allowed_callers 和 input_examples
    ]
)
有关详细的 API 文档和 SDK 示例,请参阅我们的:
这些功能将工具使用从简单的函数调用推向智能编排。随着智能体处理跨越数十个工具和大型数据集的更复杂工作流程,动态发现、高效执行和可靠调用变得至关重要。
我们很期待看到您构建的内容。
致谢
作者:Bin Wu,Adam Jones、Artur Renault、Henry Tay、Jake Noble、Noah Picard、Sam Jiang 和 Claude 开发者平台团队做出了贡献。这项工作建立在 Chris Gorgolewski、Daniel Jiang、Jeremy Fox 和 Mike Lambert 的基础研究之上。我们还从整个 AI 生态系统中汲取了灵感,包括 Joel Pobar 的 LLMVM、Cloudflare 的代码模式 和 作为 MCP 的代码执行。特别感谢 Andy Schumeister、Hamish Kerr、Keir Bradwell、Matt Bleifer 和 Molly Vorwerck 的支持。