Claude 3.7 Sonnet and Claude Code \ Anthropic
来源: https://www.anthropic.com/news/claude-3-7-sonnet 抓取时间: 2026-07-21 16:25:09
公告
Claude 3.7 Sonnet and Claude Code
Feb 24, 2025
 今天,我们宣布推出 Claude 3.7 Sonnet¹——我们迄今为止最智能的模型,也是市场上首个混合推理模型。Claude 3.7 Sonnet 可以产生近乎即时的响应,或者进行对用户可见的扩展的、逐步的思考。API 用户还可以细粒度控制模型的思考时长。
Claude 3.7 Sonnet 在编码和前端 Web 开发方面显示出特别显著的改进。与此同时,我们还推出了一款用于智能体编码的命令行工具 Claude Code。Claude Code 以有限研究预览版提供,使开发人员能够直接从终端将重要的工程任务委派给 Claude。
 Claude 3.7 Sonnet 现已在所有 Claude 计划中可用——包括免费版、Pro、Team 和 Enterprise——以及 Claude 开发者平台、Amazon Bedrock 和 Google Cloud 的 Vertex AI。除了免费 Claude 套餐外,所有套餐均支持扩展思考模式。
在标准和扩展思考模式下,Claude 3.7 Sonnet 的价格与其前代产品相同:每百万输入令牌 3 美元,每百万输出令牌 15 美元——包括思考令牌。
Claude 3.7 Sonnet:前沿推理落地实践
我们开发 Claude 3.7 Sonnet 的理念与市场上其他推理模型不同。正如人类使用单一大脑进行快速响应和深度思考一样,我们认为推理应该是前沿模型的集成能力,而不是完全独立的模型。这种统一的方法也为用户创造了更流畅的体验。
Claude 3.7 Sonnet 在多个方面体现了这一理念。首先,Claude 3.7 Sonnet 既是普通 LLM 又是推理模型:您可以选择何时让模型正常回答,何时让它在回答前思考更长时间。在标准模式下,Claude 3.7 Sonnet 是 Claude 3.5 Sonnet 的升级版。在扩展思考模式下,它在回答前进行自我反思,从而提高其在数学、物理、指令遵循、编码以及许多其他任务上的表现。我们通常发现,两种模式下的提示词工程效果相似。
其次,通过 API 使用 Claude 3.7 Sonnet 时,用户还可以控制思考的"预算":您可以告诉 Claude 思考不超过 N 个令牌,N 最高可达 128K 令牌的输出限制。这使您可以在速度(和成本)与回答质量之间进行权衡。
第三,在开发我们的推理模型时,我们在数学和计算机科学竞赛问题方面的优化较少,而是将重点转向更能反映企业实际使用 LLM 方式的真实世界任务。
早期测试证明了 Claude 在全面编码能力方面的领先地位:Cursor 指出 Claude 再次成为真实世界编码任务的同类最佳,在从处理复杂代码库到高级 Tool Use 的各个领域都有显著改进。Cognition 发现它在规划代码变更和处理全栈更新方面远优于任何其他模型。Vercel 强调了 Claude 对复杂智能体工作流的卓越精度,而 Replit 已成功部署 Claude 从零开始构建复杂的 Web 应用和仪表板,这是其他模型停滞不前的地方。在 Canva 的评估中,Claude 持续生成可投入生产的代码,具有卓越的设计品味,并大幅减少错误。
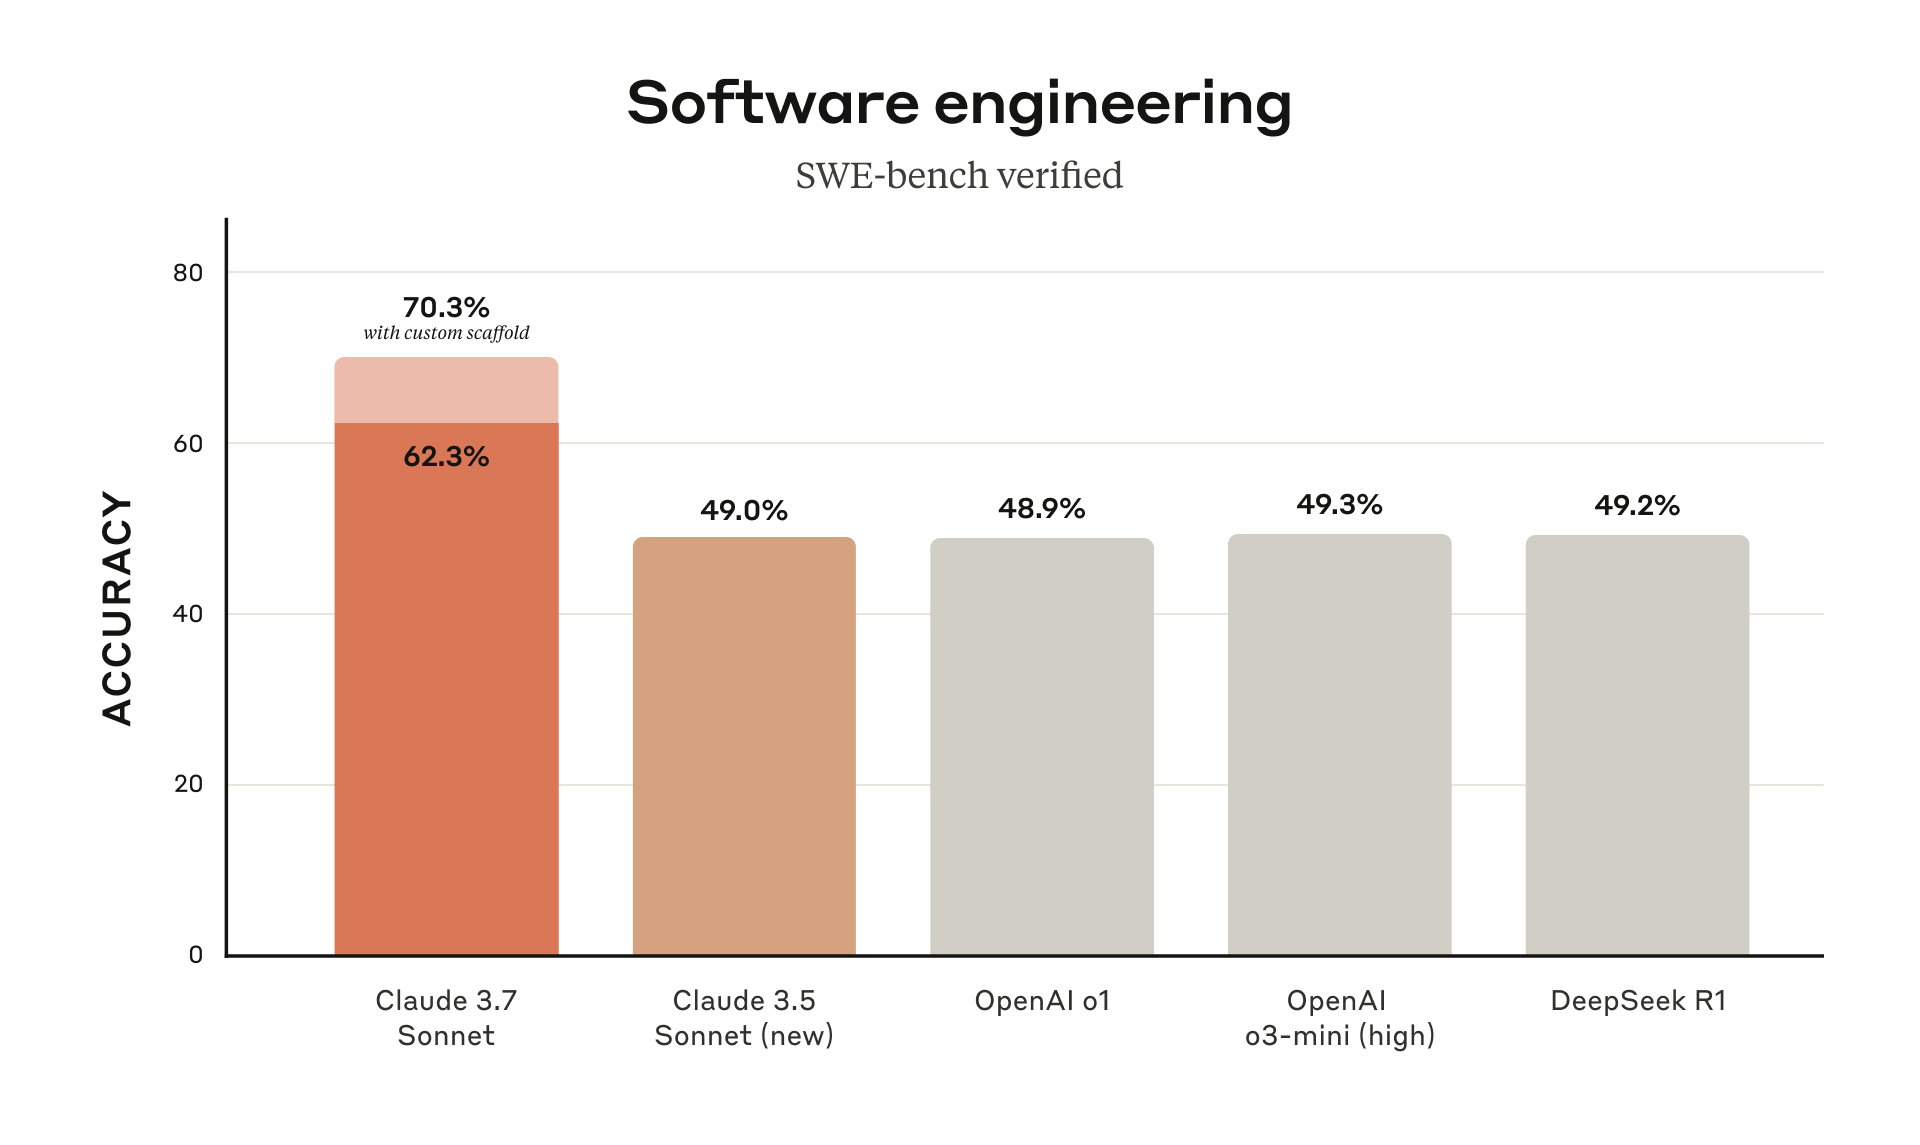 Claude 3.7 Sonnet 在 SWE-bench Verified 上达到最先进的性能,该基准评估 AI 模型解决真实世界软件问题的能力。更多关于脚手架的信息见附录。
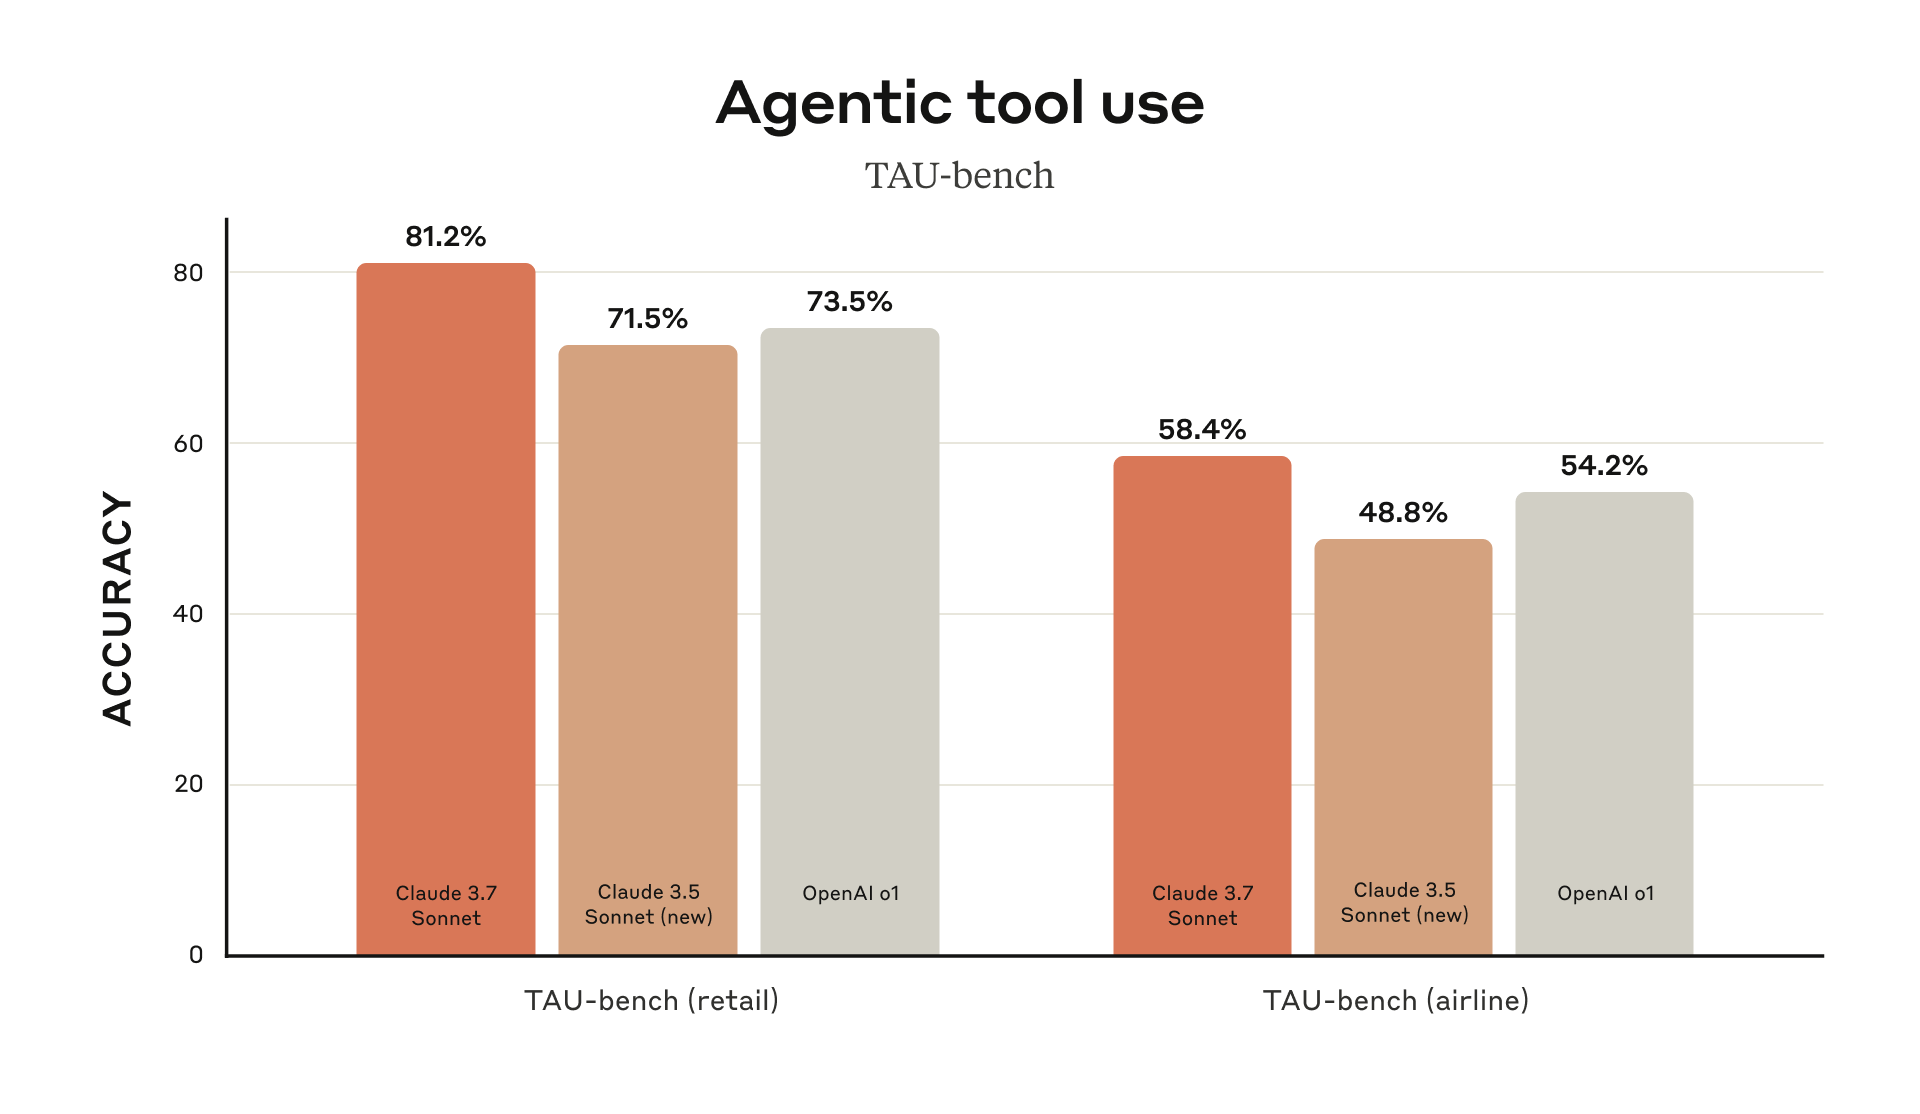 Claude 3.7 Sonnet 在 TAU-bench 上达到最先进的性能,这是一个测试 AI 智能体在复杂真实世界任务中与用户和工具交互的框架。更多关于脚手架的信息见附录。
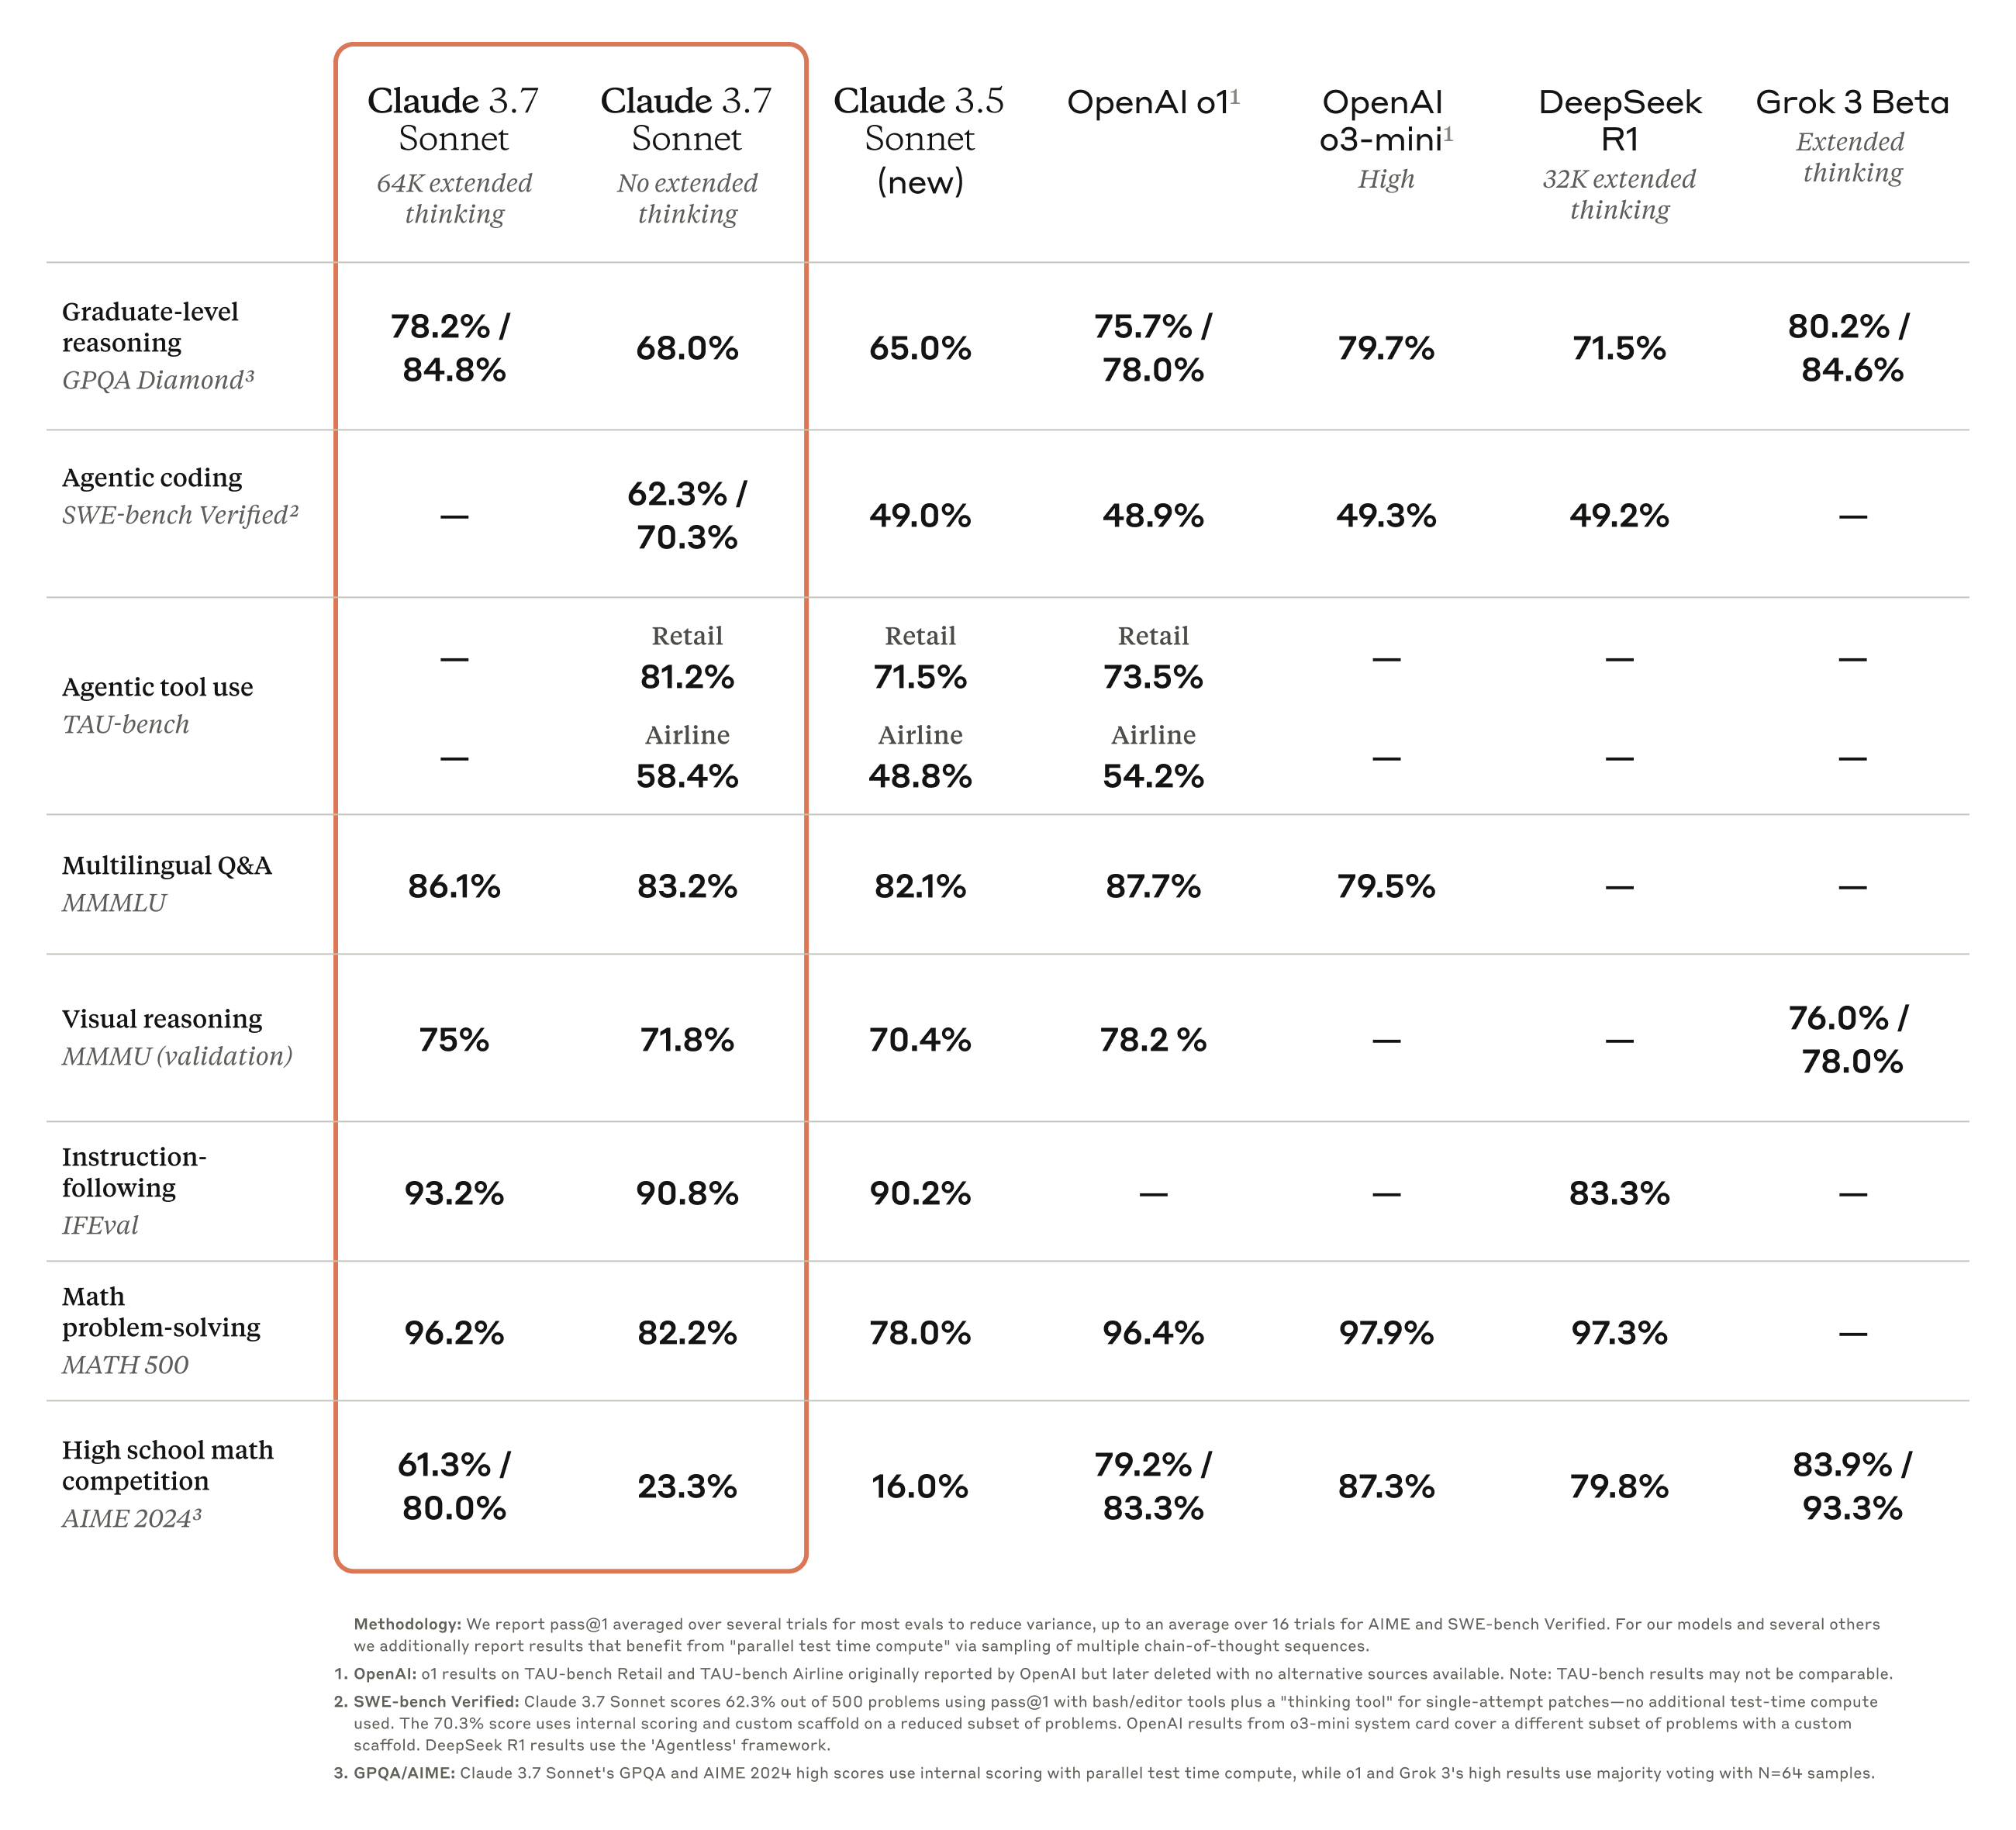 Claude 3.7 Sonnet 在指令遵循、通用推理、多模态能力和智能体编码方面表现出色,扩展思考在数学和科学方面提供了显著提升。除了传统基准测试之外,它甚至在我们的 Pokémon 游戏测试中超越了所有先前的模型。
Claude Code
自 2024 年 6 月以来,Sonnet 一直是全球开发者的首选模型。今天,我们通过推出 Claude Code——我们的首款智能体编码工具——以有限研究预览版进一步赋能开发者。
Claude Code 是一个积极的协作者,可以搜索和阅读代码、编辑文件、编写和运行测试、提交和推送代码到 GitHub,以及使用命令行工具——让你全程参与每一步。
Claude Code 是一款早期产品,但已经成为我们团队不可或缺的工具,特别是对于测试驱动开发、调试复杂问题和大规模重构。在早期测试中,Claude Code 一次完成了通常需要 45 分钟以上手动工作的任务,减少了开发时间和开销。
在未来几周内,我们计划基于我们的使用情况持续改进它:增强工具调用可靠性,添加对长时间运行命令的支持,改进应用内渲染,并扩展 Claude 对自身能力的理解。
我们推出 Claude Code 的目标是更好地了解开发人员如何使用 Claude 进行编码,从而为未来的模型改进提供信息。通过加入此预览,你将获得访问我们用于构建和改进 Claude 的相同强大工具的权限,你的反馈将直接塑造其未来。
在你的代码库中使用 Claude
我们还改进了 Claude.ai 上的编码体验。我们的 GitHub 集成现已在所有 Claude 计划中可用——使开发人员能够将代码仓库直接连接到 Claude。
Claude 3.7 Sonnet 是我们迄今为止最好的编码模型。通过更深入地理解你的个人、工作和开源项目,它成为一个更强大的合作伙伴,用于在你最重要的 GitHub 项目中修复 bug、开发功能和构建文档。
负责任地构建
我们与外部专家合作,对 Claude 3.7 Sonnet 进行了广泛的测试和评估,以确保它满足我们在安全、安保和可靠性方面的标准。Claude 3.7 Sonnet 还能更细致地区分有害和良性的请求,与其前代相比,不必要的拒绝减少了 45%。
此版本的系统卡片涵盖了多个类别的新安全结果,提供了我们负责任扩展政策评估的详细分类明细,其他 AI 实验室和研究人员可以将其应用于他们的工作。该卡片还解决了 Computer Use 带来的新兴风险,特别是提示词注入攻击,并解释了我们如何评估这些漏洞并训练 Claude 抵抗和缓解它们。此外,它还研究了推理模型的潜在安全优势:理解模型如何做出决策的能力,以及模型推理是否真正可信和可靠。阅读完整的系统卡片了解更多。
展望未来
Claude 3.7 Sonnet 和 Claude Code 标志着向能够真正增强人类能力的 AI 系统迈出的重要一步。凭借其深度推理、自主工作和有效协作的能力,它们让我们更接近这样一个未来:AI 丰富和扩展了人类可以实现的目标。
 我们期待你探索这些新能力,并期待看到你将用它们创造什么。一如既往,我们欢迎你的[反馈](mailto: feedback@anthropic.com),因为我们会持续改进和演进我们的模型。
附录
¹ 关于命名的经验教训。
评估数据来源
TAU-bench
关于脚手架的信息 通过在航空智能体政策中添加提示词附录,指示 Claude 更好地利用"规划"工具,在该工具中,鼓励模型在解决问题时在多轮轨迹中写下其想法,这与我们通常的思考模式不同,以便最好地利用其推理能力。为了适应 Claude 通过使用更多思考产生的额外步骤,最大步数(按模型完成计数)从 30 增加到 100(大多数轨迹在 30 步内完成,只有一条轨迹超过 50 步)。
此外,Claude 3.5 Sonnet(新版)的 TAU-bench 分数与我们最初发布时报告的不同,因为自那时以来引入了小的数据集改进。我们在更新后的数据集上重新运行,以便与 Claude 3.7 Sonnet 进行更准确的比较。
SWE-bench Verified
关于脚手架的信息 有多种方法可以解决 SWE-bench 这样的开放式智能体任务。一些方法将大量复杂性转移到决定要调查或编辑哪些文件以及决定要运行哪些测试到更传统的软件,让核心语言模型在预定义位置生成代码,或从更有限的动作集中选择。Agentless(Xia 等人,2024)是一个流行的框架,用于评估 Deepseek 的 R1 和其他模型,它通过基于提示词和嵌入的文件检索机制、补丁定位和针对回归测试的 40 选优拒绝采样来增强智能体。其他脚手架(例如 Aide)通过额外的测试时计算进一步补充模型,以进行重试、N 选优或蒙特卡洛树搜索(MCTS)。
对于 Claude 3.7 Sonnet 和 Claude 3.5 Sonnet(新版),我们使用了一种更简单的方法,具有最少的脚手架,模型在单一会话中决定要运行哪些命令和要编辑哪些文件。我们的主要"无扩展思考"pass@1 结果只是为模型配备了此处描述的两个工具——一个 bash 工具,以及一个通过字符串替换操作的文件编辑工具——以及我们在 TAU-bench 结果中提到的"规划工具"。由于基础设施限制,在我们的内部基础设施上实际上只有 500 个问题中的 489 个可解(即黄金解决方案通过测试)。对于我们的原生 pass@1 分数,我们将 11 个不可解的问题计为失败,以与官方排行榜保持一致。为了透明度,我们单独发布了在我们的基础设施上无法运行的测试用例。
对于我们的"高计算"数字,我们采用了额外的复杂性和并行测试时计算,如下:
- 我们使用上述脚手架采样多个并行尝试
- 我们丢弃破坏仓库中可见回归测试的补丁,类似于 Agentless 采用的拒绝采样方法;注意不使用任何隐藏的测试信息
- 然后,我们使用评分模型对剩余的尝试进行排名,该评分模型与我们在研究文章中描述的 GPQA 和 AIME 中使用的评分模型相同,并选择最佳的进行提交
这在我们的基础设施上工作的 n=489 个已验证任务上产生了 70.3% 的结果。如果没有这个脚手架,Claude 3.7 Sonnet 在相同子集上的 SWE-bench Verified 达到 63.7%。与我们的内部基础设施不兼容的排除的 11 个测试用例是:
- scikit-learn__scikit-learn-14710
- django__django-10097
- psf__requests-2317
- sphinx-doc__sphinx-10435
- sphinx-doc__sphinx-7985
- sphinx-doc__sphinx-8475
- matplotlib__matplotlib-20488
- astropy__astropy-8707
- astropy__astropy-8872
- sphinx-doc__sphinx-8595
- sphinx-doc__sphinx-9711
相关内容
申请 Anthropic 的 AI for Science 罕见病研究资助
Anthropic 正在分享针对 AI for Science 申请的特别聚焦于罕见遗传病的信息。被录取的申请者将在六个月内获得最高 50,000 美元的 Claude 积分,目标是建立一个研究 AI 如何重塑我们对罕见病理解的研究人员社区。 阅读更多