"思考"工具:让 Claude 停下来思考 \ Anthropic
来源: https://www.anthropic.com/engineering/claude-think-tool 抓取时间: 2026-07-21 16:25:12
- 扩展思考更新 2025年12月15日
扩展思考能力自首次发布以来已得到改进,因此我们建议在大多数情况下使用该功能而非专用的思考工具。扩展思考提供了类似的好处——为 Claude 提供解决复杂问题的空间——并具有更好的集成和性能。请参阅我们的扩展思考文档以了解实现细节。
随着我们持续增强 Claude 的复杂问题解决能力,我们发现了一种特别有效的方法:一个"思考"工具,它为复杂任务期间的结构化思考创造了专用空间。
这个简单而强大的技术——正如我们将在下面解释的,它不同于 Claude 新的"扩展思考"功能(参见扩展思考实现细节)——已使 Claude 的智能体工具使用能力取得了显著的改进。这包括遵循策略、做出一致决策以及处理多步骤问题,所有这些都只需最少的实现开销。
在这篇文章中,我们将探讨如何在不同的应用程序中实现"思考"工具,并根据经过验证的基准测试结果为开发者提供实用指导。
什么是"思考"工具?
通过"思考"工具,我们赋予 Claude 包含额外思考步骤的能力——它有自己的指定空间——作为获得最终答案的一部分。
虽然听起来类似于扩展思考,但它是一个不同的概念。扩展思考是关于 Claude 在开始生成响应之前所做的事情。通过扩展思考,Claude 在采取行动之前深入考虑并迭代其计划。"思考"工具是让 Claude 在开始生成响应后添加一个步骤,停下来思考它是否拥有继续前进所需的所有信息。这在执行长链的工具调用或与用户进行长时间的多步对话时特别有用。
这使得"思考"工具更适合以下情况:Claude 没有足够的信息仅从用户查询中制定其响应,以及它需要处理外部信息(例如工具调用结果中的信息)的情况。Claude 使用"思考"工具执行的推理不如使用扩展思考获得的那么全面,而且更多地集中在模型发现的_新_信息上。
我们建议对简单的工具使用场景使用扩展思考,例如非顺序工具调用或直接的指令遵循。扩展思考对于不需要 Claude 调用工具的用例也很有用,例如编码、数学和物理。"思考"工具更适合以下情况:Claude 需要调用复杂工具、在长链工具调用中仔细分析工具输出、导航具有详细指南的策略密集型环境,或者做出每个步骤都建立在以前步骤之上且错误成本高昂的顺序决策。
以下是使用来自 τ-Bench 的标准工具规范格式的示例实现:
{
  "name": "think",
  "description": "Use the tool to think about something. It will not obtain new information or change the database, but just append the thought to the log. Use it when complex reasoning or some cache memory is needed.",
  "input_schema": {
    "type": "object",
    "properties": {
      "thought": {
        "type": "string",
        "description": "A thought to think about."
      }
    },
    "required": ["thought"]
  }
}
在 τ-Bench 上的表现
我们使用 τ-bench (TAU-bench) 评估了"思考"工具,这是一个全面的基准测试,旨在测试模型在现实客户服务场景中使用工具的能力,其中"思考"工具是评估标准环境的一部分。
τ-bench 评估 Claude 的以下能力:
- 与模拟用户进行现实的对话
- 一致地遵循复杂的客户服务智能体政策指南
- 使用各种工具访问和操作环境数据库
τ-bench 中使用的主要评估指标是 pass^k,它衡量给定任务的所有 k 次独立任务试验成功的概率,并在所有任务中取平均值。与其他 LLM 评估中常见的 pass@k 指标(衡量 k 次试验中是否至少有一次成功)不同,pass^k 评估一致性和可靠性——这是客户服务应用的关键质量,在这些应用中,对策略的一致遵循至关重要。
表现分析
我们的评估比较了几种不同的配置:
- 基线(无"思考"工具,无扩展思考模式)
- 仅扩展思考模式
- 仅"思考"工具
- 带有优化提示的"思考"工具(针对航空领域)
结果表明,当 Claude 3.7 在基准测试的"航空"和"零售"客户服务领域有效使用"思考"工具时,表现得到了大幅提升:
- 航空领域:带有优化提示的"思考"工具在 pass^1 指标上达到了 0.570,而基线仅为 0.370——相对提升了 54%;
- 零售领域:仅"思考"工具达到了 0.812,而基线为 0.783。
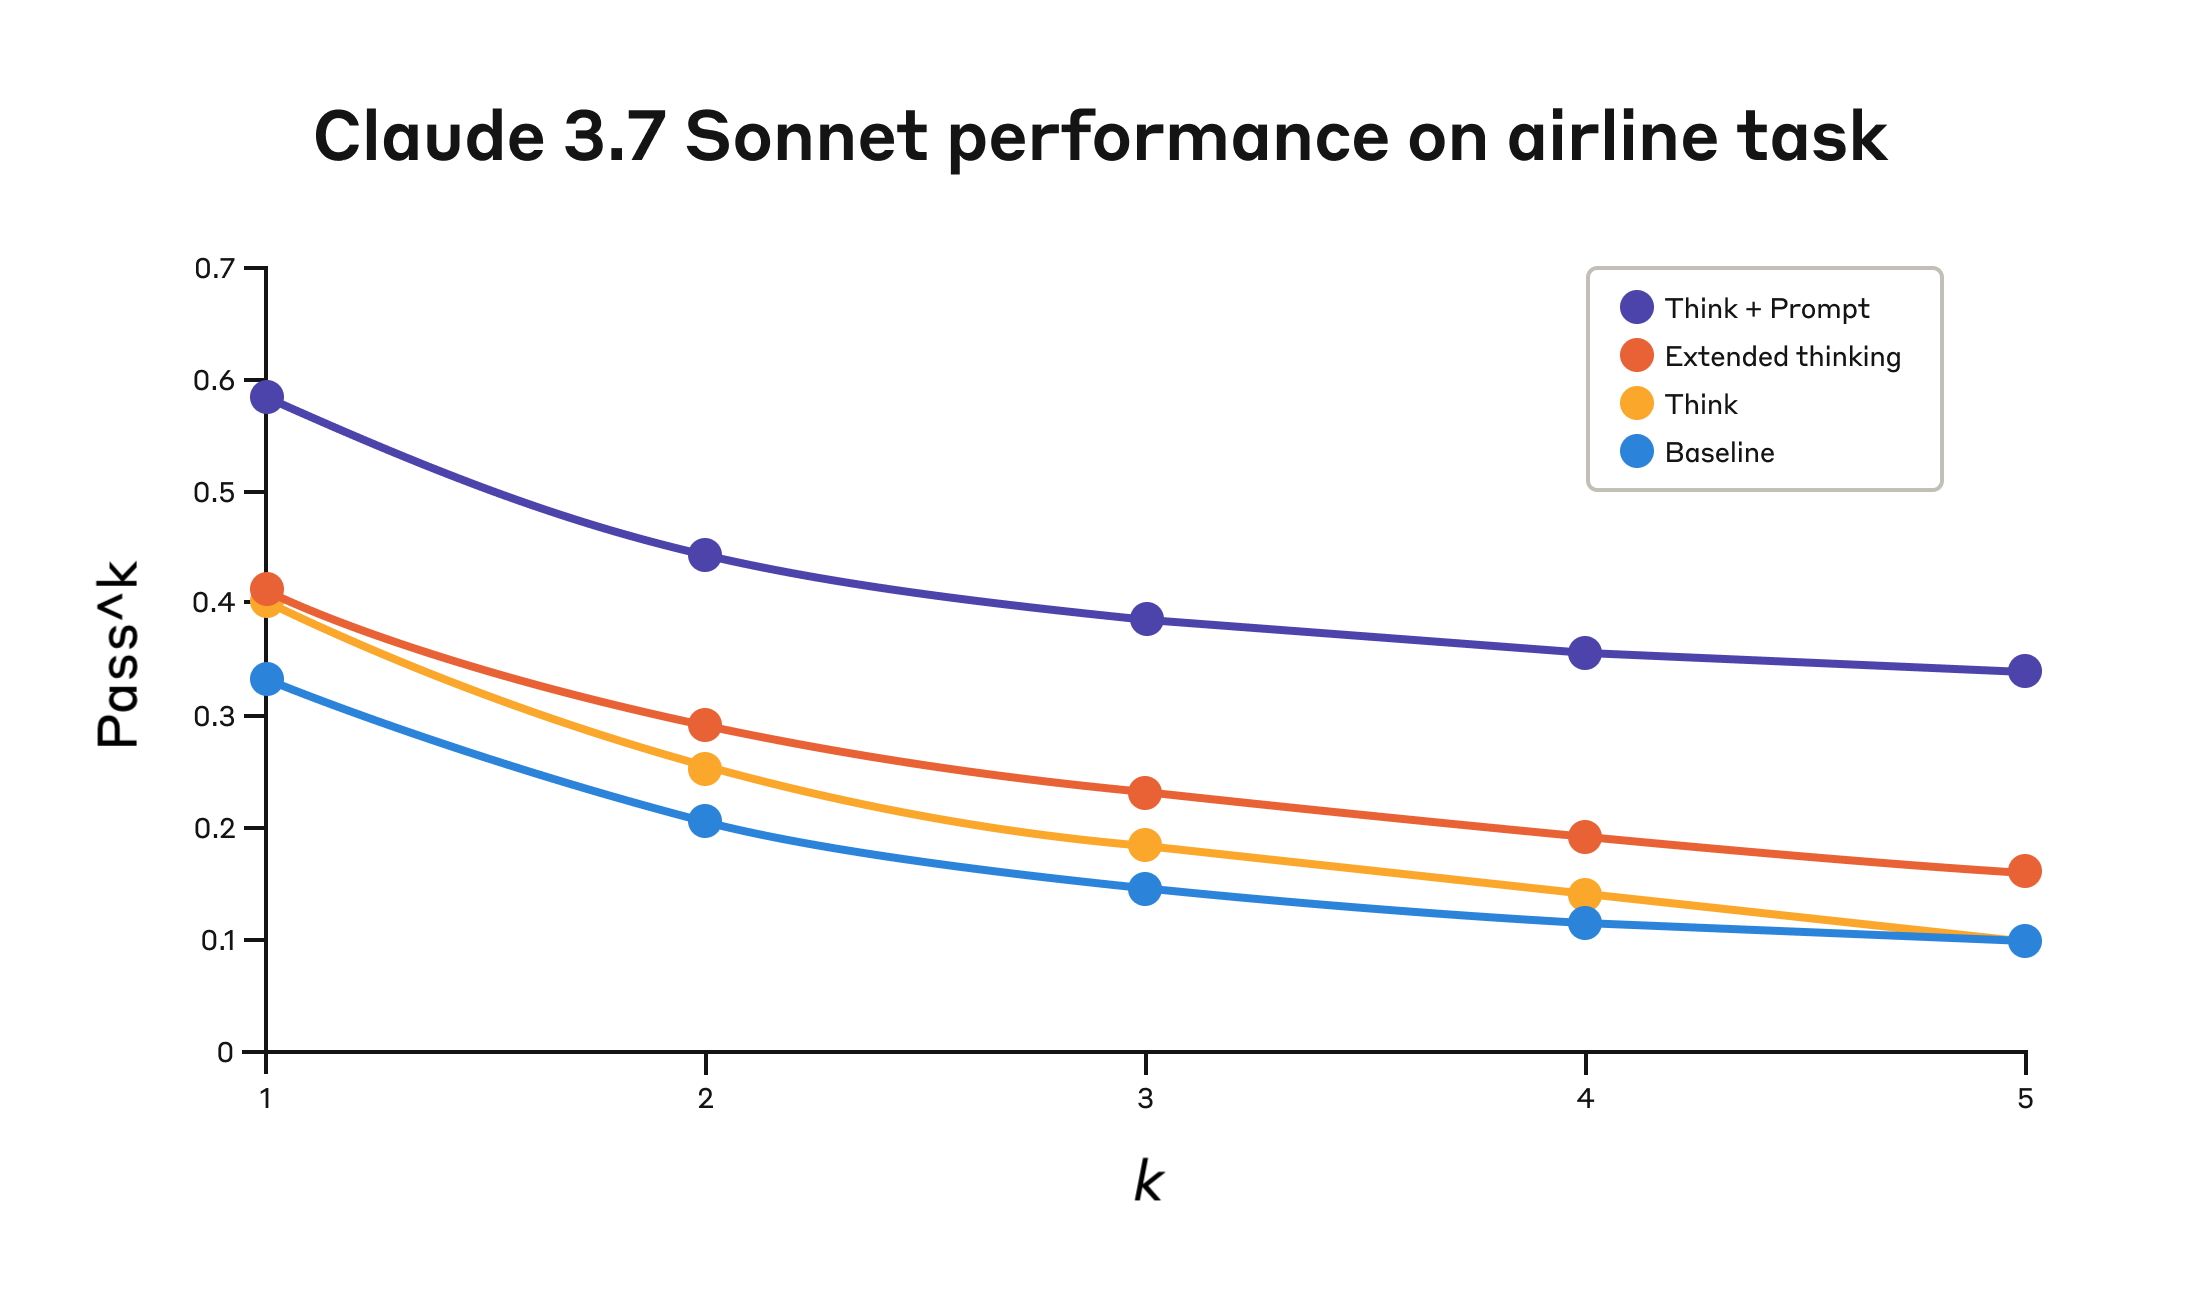 Claude 3.7 Sonnet 在四种不同配置下在 TAU-bench 评估的"航空"领域的表现。
| 配置 | k =1 | k =2 | k =3 | k =4 | k =5 |
|---|---|---|---|---|---|
| "思考" + 提示 | 0.584 | 0.444 | 0.384 | 0.356 | 0.340 |
| "思考" | 0.404 | 0.254 | 0.186 | 0.140 | 0.100 |
| 扩展思考 | 0.412 | 0.290 | 0.232 | 0.192 | 0.160 |
| 基线 | 0.332 | 0.206 | 0.148 | 0.116 | 0.100 |
四种不同配置的评估结果。分数为比例。
在航空领域的最佳表现是通过将"思考"工具与优化提示配对实现的,该优化提示提供了分析客户请求时使用的推理方法类型的示例。以下是优化提示的示例:
## 使用思考工具

在采取任何行动或收到工具结果后响应用户之前,使用思考工具作为暂存器来:
- 列出适用于当前请求的特定规则
- 检查是否已收集所有必需的信息
- 验证计划的行动是否符合所有策略
- 迭代工具结果以确保正确性

以下是在思考工具中要迭代的一些示例:
<think_tool_example_1>
用户想要取消航班 ABC123
- 需要验证:用户 ID、预订 ID、原因
- 检查取消规则:
  * 是否在预订后 24 小时内?
  * 如果不是,检查机票等级和保险
- 验证没有航段已飞行或已过期
- 计划:收集缺失信息、验证规则、获取确认
</think_tool_example_1>

<think_tool_example_2>
用户想要预订 3 张去纽约的机票,每张有 2 件托运行李
- 需要用户 ID 来检查:
  * 行李津贴的会员等级
  * 个人资料中存在哪些付款方式
- 行李计算:
  * 经济舱 × 3 名乘客
  * 如果是普通会员:每人 1 件免费行李 → 3 件额外行李 = 150 美元
  * 如果是白银会员:每人 2 件免费行李 → 0 件额外行李 = 0 美元
  * 如果是黄金会员:每人 3 件免费行李 → 0 件额外行李 = 0 美元
- 要验证的付款规则:
  * 最多 1 张旅行券、1 张信用卡、3 张礼品卡
  * 所有付款方式必须在个人资料中
  * 旅行券剩余部分将作废
- 计划:
1. 获取用户 ID
2. 验证行李费的会员等级
3. 检查个人资料中有哪些付款方式以及它们的组合是否允许
4. 计算总计:机票价格 + 任何行李费
5. 获取明确的预订确认
</think_tool_example_2>
特别有趣的是不同方法之间的比较。使用带有优化提示的"思考"工具比扩展思考模式取得了显著更好的结果(扩展思考模式显示出与无提示的"思考"工具类似的性能)。单独使用"思考"工具(无提示)比基线提高了性能,但仍不及优化方法。
"思考"工具与优化提示的组合以显著优势带来了最强的性能,这可能是由于基准测试中航空公司政策部分的高度复杂性,模型从获得如何"思考"的示例中受益最多。
在零售领域,我们还测试了各种配置以了解每种方法的具体影响
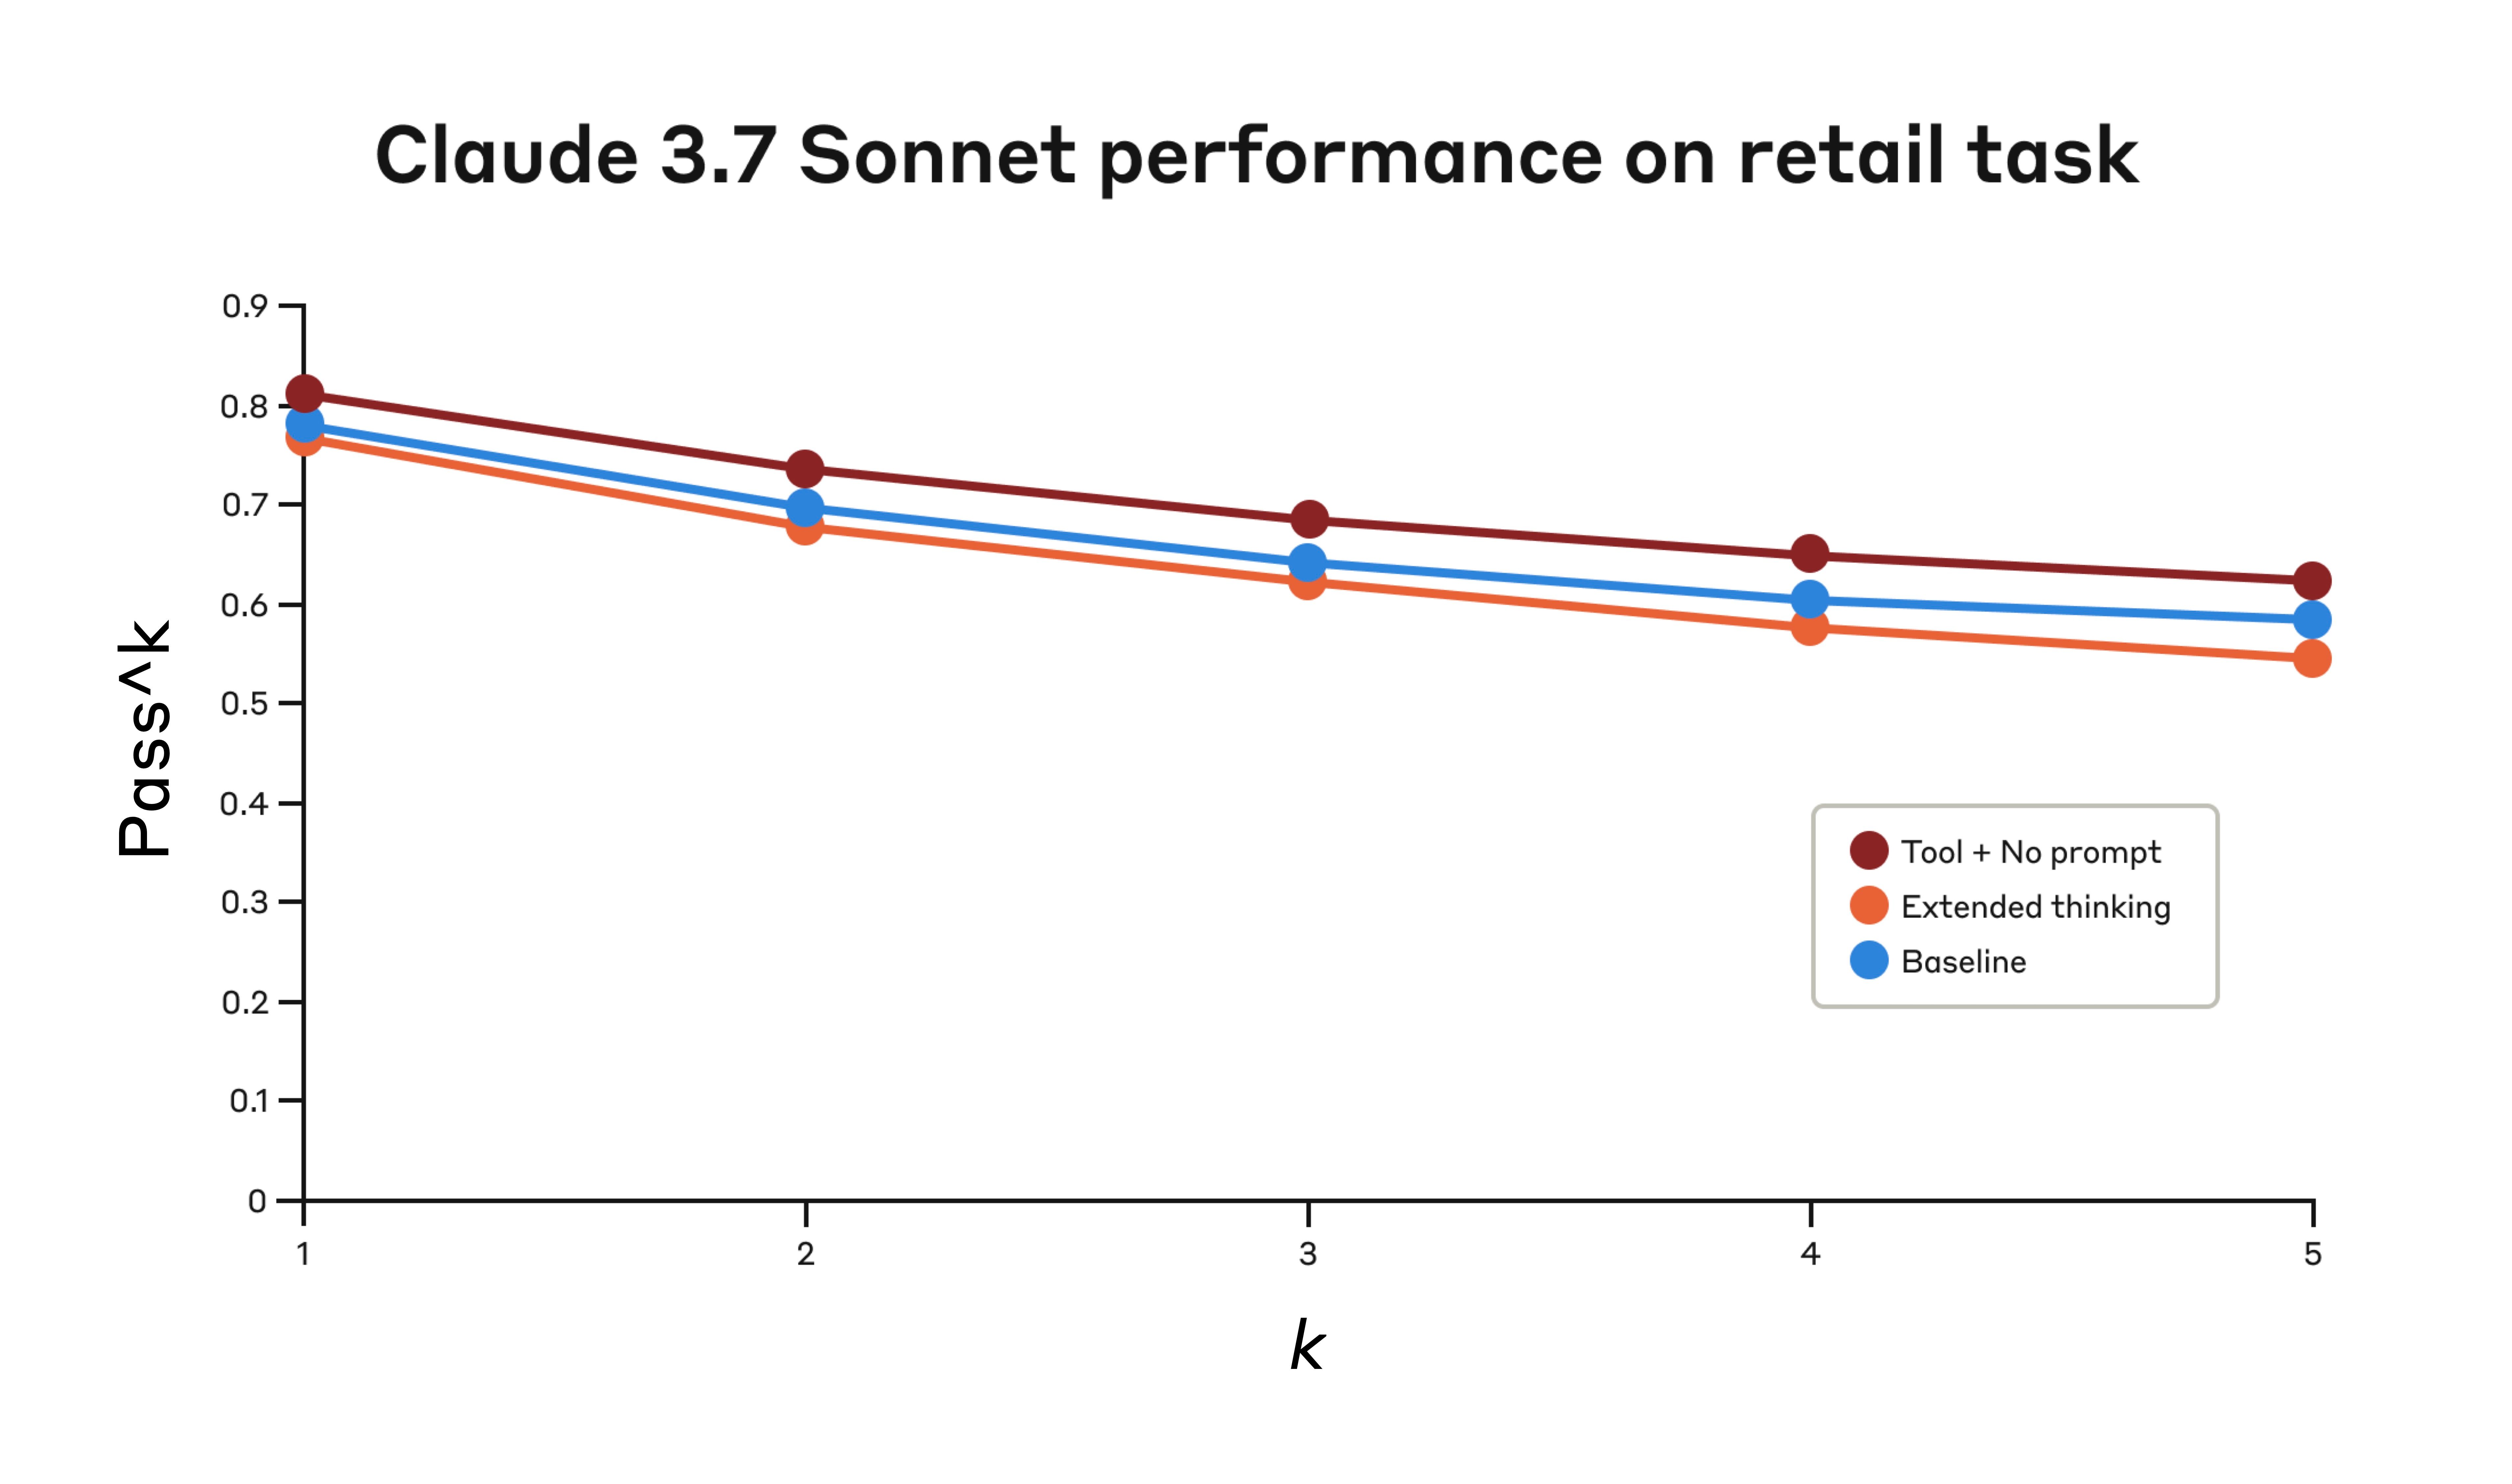 Claude 3.7 Sonnet 在三种不同配置下在 TAU-bench 评估的"零售"领域的表现。
| 配置 | k =1 | k =2 | k =3 | k =4 | k =5 |
|---|---|---|---|---|---|
| "思考" + 无提示 | 0.812 | 0.735 | 0.685 | 0.650 | 0.626 |
| 扩展思考 | 0.770 | 0.681 | 0.623 | 0.581 | 0.548 |
| 基线 | 0.783 | 0.695 | 0.643 | 0.607 | 0.583 |
三种不同配置的评估结果。分数为比例。
即使没有额外提示,"思考"工具也达到了 0.812 的最高 pass^1 分数。与航空领域相比,零售政策明显更容易导航,Claude 只需拥有一个思考空间就能有所改进,而无需进一步指导。
τ-Bench 分析的关键见解
我们的详细分析揭示了几种可以帮助您有效实现"思考"工具的模式:
- 在困难领域,提示至关重要。仅仅提供"思考"工具可能会在一定程度上提高性能,但在困难领域,将其与优化提示配对会产生显著更好的结果。然而,较简单的领域可能只需能够"思考"即可受益。
- 跨试验的一致性提高。使用"思考"的改进在 pass^k 中一直保持到 k=5,这表明该工具帮助 Claude 更有效地处理边缘情况和不寻常的场景。
在 SWE-bench 上的表现
在评估 Claude 3.7 Sonnet 时,我们的 SWE-bench 设置中添加了类似的"思考"工具,为达到 0.623 的最先进分数做出了贡献。调整后的"思考"工具定义如下:
{
  "name": "think",
  "description": "Use the tool to think about something. It will not obtain new information or make any changes to the repository, but just log the thought. Use it when complex reasoning or brainstorming is needed. For example, if you explore the repo and discover the source of a bug, call this tool to brainstorm several unique ways of fixing the bug, and assess which change(s) are likely to be simplest and most effective. Alternatively, if you receive some test results, call this tool to brainstorm ways to fix the failing tests.",
  "input_schema": {
    "type": "object",
    "properties": {
      "thought": {
        "type": "string",
        "description": "Your thoughts."
      }
    },
    "required": ["thought"]
  }
}
我们的实验(n =30 个带"思考"工具的样本,n =144 个不带工具的样本)表明,包含该工具的孤立效应平均提高了 1.6% 的性能(韦尔奇 t 检验:t(38.89) = 6.71,p < .001,d = 1.47)。
何时使用"思考"工具
基于这些评估结果,我们确定了 Claude 从"思考"工具中受益最多的特定场景:
- 工具输出分析。当 Claude 需要在采取行动之前仔细处理先前工具调用的输出,并且可能需要回溯其方法时;
- 策略密集型环境。当 Claude 需要遵循详细指南并验证合规性时;以及
- 顺序决策。当每个行动都建立在先前的行动之上,且错误成本高昂时(通常出现在多步骤领域)。
实现最佳实践
为了充分利用 Claude 的"思考"工具,我们基于 τ-bench 实验推荐以下实现实践。
1. 带有特定领域示例的战略性提示
最有效的方法是提供关于何时以及如何使用"思考"工具的清晰说明,例如用于 τ-bench 航空领域的说明。提供针对您特定用例的示例可显著提高模型使用"思考"工具的有效性:
- 推理过程中预期的细节程度;
- 如何将复杂指令分解为可操作的步骤;
- 处理常见场景的决策树;以及
- 如何检查是否已收集所有必要信息。
2. 将复杂指导放在系统提示中
我们发现,当指令很长和/或很复杂时,将"思考"工具的说明包含在系统提示中比将它们放在工具描述本身更有效。这种方法提供了更广泛的上下文,并帮助模型更好地将思考过程集成到其整体行为中。
何时不使用"思考"工具
虽然"思考"工具可以提供实质性的改进,但它并不适用于所有工具使用用例,而且确实会以增加提示长度和输出令牌为代价。具体来说,我们发现"思考"工具在以下用例中没有提供任何改进:
- 非顺序工具调用。如果 Claude 只需进行单个工具调用或多个并行调用即可完成任务,那么添加"思考"不太可能有任何改进。
- 简单指令遵循。当 Claude 需要遵守的约束不多,并且其默认行为足够好时,额外的"思考"不太可能带来收益。
开始使用
"思考"工具是对 Claude 实现的直接补充,只需几个步骤即可产生有意义的改进:
- 用智能体工具使用场景进行测试。从具有挑战性的用例开始——即 Claude 当前在策略合规性或长工具调用链中的复杂推理方面存在困难的用例。
- 添加工具定义。实现一个为您的领域定制的"思考"工具。它需要最少的代码,但可以实现更结构化的推理。还要考虑包括关于何时以及如何使用该工具的说明,并在系统提示中添加与您的领域相关的示例。
- 监控和优化。观察 Claude 在实践中如何使用该工具,并调整您的提示以鼓励更有效的思考模式。
最好的部分是,添加这个工具在性能结果方面的负面影响最小。除非 Claude 决定使用它,否则它不会改变外部行为,也不会干扰您现有的工具或工作流程。
结论
我们的研究表明,"思考"工具可以显著增强 Claude 3.7 Sonnet 在需要策略遵守和长工具调用链推理的复杂任务上的性能¹。"思考"不是一个万能的解决方案,但它为正确的用例提供了实质性的好处,而且所有这些都只需要最小的实现复杂性。
我们期待看到您如何使用"思考"工具来构建更有能力、更可靠、更透明的 Claude AI 系统。
- 虽然我们的 τ-Bench 结果专注于 Claude 3.7 Sonnet 使用"思考"工具的改进,但我们的实验表明,Claude 3.5 Sonnet(新版)也能够通过与 3.7 Sonnet 相同的配置实现性能提升,这表明这种改进可以推广到其他 Claude 模型。