为 AI 智能体编写有效的工具——使用 AI 智能体 | Anthropic
来源: https://www.anthropic.com/engineering/writing-tools-for-agents 抓取时间: 2026-07-21 16:19:06
模型上下文协议 (MCP) 可以为 LLM 智能体提供可能数百个工具来解决真实世界的任务。但是我们如何使这些工具最大限度地发挥作用呢?
在这篇文章中,我们描述了我们在各种智能 AI 系统中提高性能的最有效技术¹。
我们首先介绍如何:
- 构建和测试工具的原型
- 创建并运行智能体对工具的全面评估
- 与 Claude Code 等智能体协作,自动提高工具的性能
我们最后总结了我们在此过程中确定的编写高质量工具的关键原则:
- 选择正确的工具来实现(和不实现)
- 对工具进行命名空间划分,定义清晰的功能边界
- 从工具向智能体返回有意义的上下文
- 优化工具响应的令牌效率
- 对工具描述和规范进行提示工程
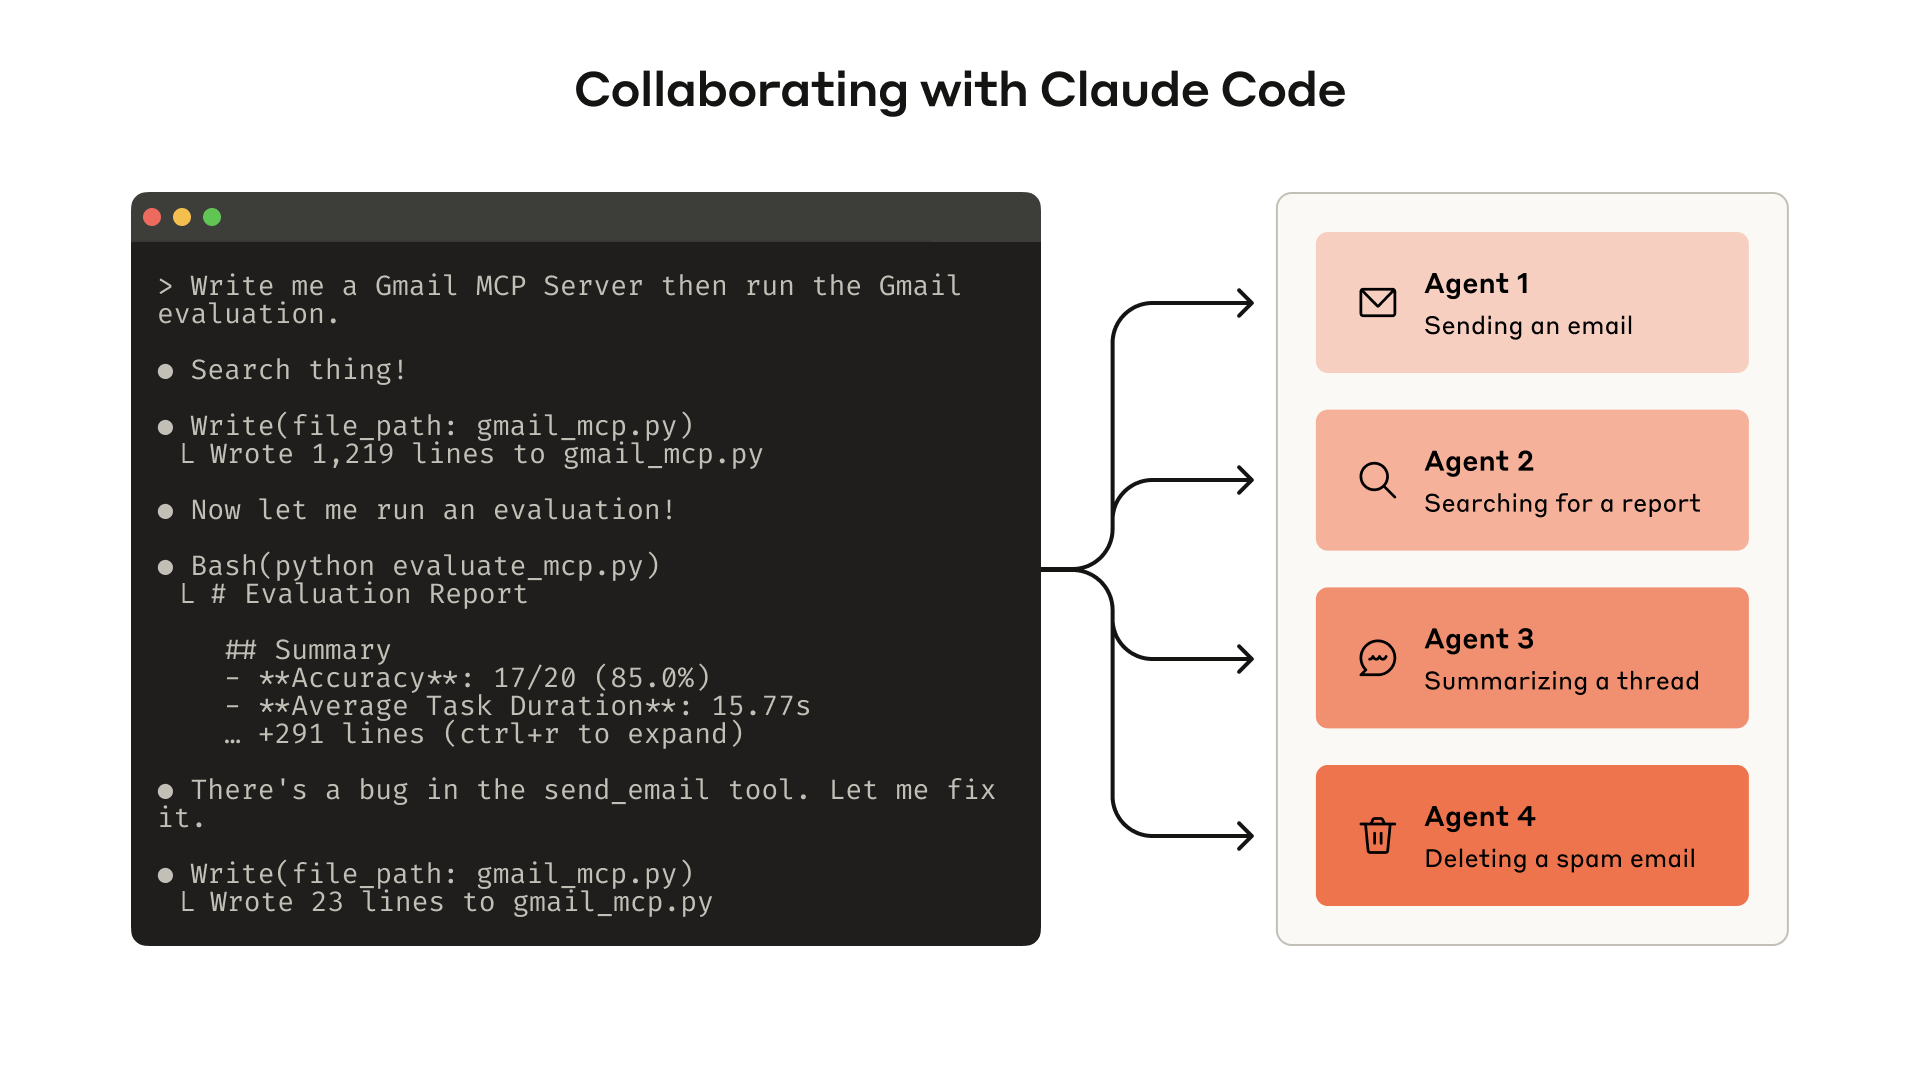 构建评估允许你系统地衡量工具的性能。你可以使用 Claude Code 针对此评估自动优化你的工具。
什么是工具?
在计算中,确定性系统在给定相同输入时每次都产生相同的输出,而非确定性系统——如智能体——即使在相同的起始条件下也能生成不同的响应。
当我们传统地编写软件时,我们正在确定性系统之间建立契约。例如,像 getWeather("NYC") 这样的函数调用每次都会以完全相同的方式获取纽约市的天气。
工具是一种新的软件,它反映了确定性系统和非确定性智能体之间的契约。当用户问"我今天应该带伞吗?"时,智能体可能会调用天气工具、从常识中回答,或者甚至先问一个关于位置的澄清问题。有时,智能体可能会产生幻觉,甚至无法理解如何使用工具。
这意味着在为智能体编写软件时,我们需要从根本上重新思考我们的方法:不是像我们为其他开发者或系统编写函数和 API 那样编写工具和 MCP 服务器,我们需要为智能体设计它们。
我们的目标是通过使用工具来追求各种成功的策略,增加智能体在解决广泛任务时能够有效发挥作用的范围。幸运的是,根据我们的经验,对智能体来说最"符合人体工程学"的工具最终对人类来说也出奇地直观易懂。
如何编写工具
在本节中,我们描述了如何与智能体协作来编写和改进你提供给它们的工具。首先快速建立你的工具原型并在本地测试。接下来,运行全面的评估来衡量后续的变化。与智能体一起工作,你可以重复评估和改进工具的过程,直到你的智能体在真实世界任务上取得强大的性能。
构建原型
如果不亲自动手,很难预测哪些工具智能体会觉得符合人体工程学,哪些工具不会。首先快速建立你的工具原型。如果你使用 Claude Code 来编写你的工具(可能一次性完成),向 Claude 提供你的工具将依赖的任何软件库、API 或 SDK(包括可能的 MCP SDK)的文档会有帮助。LLM 友好的文档通常可以在官方文档站点的 flat llms.txt 文件中找到(这是我们 API 的)。
将你的工具包装在本地 MCP 服务器或桌面扩展 (DXT) 中,将允许你在 Claude Code 或 Claude 桌面应用中连接和测试你的工具。
要将你的本地 MCP 服务器连接到 Claude Code,请运行 claude mcp add <name> <command> [args...]。
要将你的本地 MCP 服务器或 DXT 连接到 Claude 桌面应用,请分别导航到 设置 > 开发者 或 设置 > 扩展。
工具也可以直接传递到 Anthropic API 调用中,用于程序化测试。
亲自测试工具以识别任何粗糙的边缘。收集用户的反馈,以建立对你期望工具能够实现的用例和提示的直觉。
运行评估
接下来,你需要通过运行评估来衡量 Claude 使用你的工具的效果如何。首先生成大量评估任务,基于现实世界的使用。我们建议与智能体协作,帮助分析你的结果并确定如何改进工具。在我们的工具评估教程中查看完整的端到端过程。
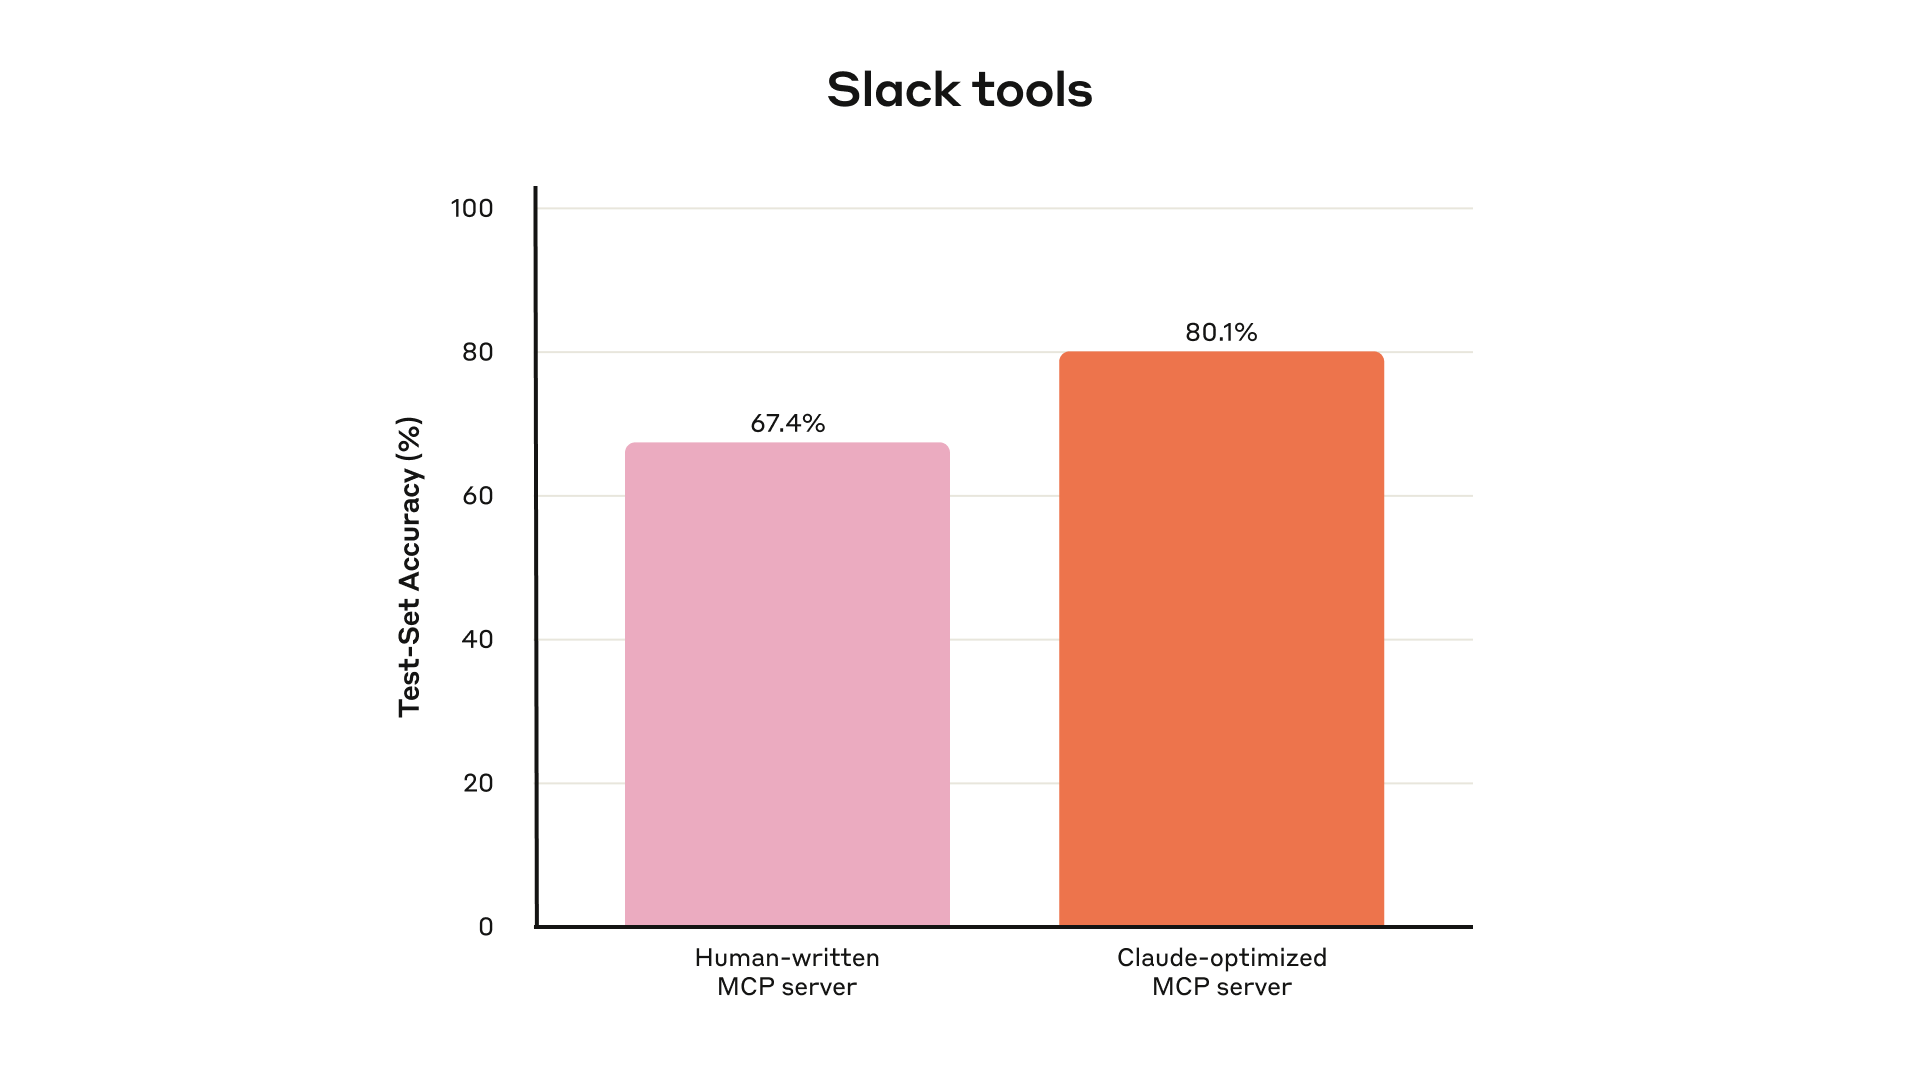 我们内部 Slack 工具的留存测试集性能
生成评估任务 使用你的早期原型,Claude Code 可以快速探索你的工具并创建数十个提示和响应对。提示应该受到现实世界使用的启发,并基于现实的数据源和服务(例如,内部知识库和微服务)。我们建议你避免过于简单或表面化的"沙箱"环境,这些环境不会用足够的复杂性对你的工具进行压力测试。强大的评估任务可能需要多次工具调用——可能多达数十次。
以下是一些强大任务的例子:
- 下周安排与 Jane 的会议,讨论我们最新的 Acme Corp 项目。附上我们上次项目规划会议的笔记,并预订一个会议室。
- 客户 ID 9182 报告他们在一次购买尝试中被收取了三次费用。查找所有相关的日志条目,并确定是否有其他客户受到同一问题的影响。
- 客户 Sarah Chen 刚刚提交了取消请求。准备一份留存提议。确定:(1) 他们为什么离开,(2) 什么留存提议最有吸引力,以及 (3) 在提出提议之前我们应该注意的任何风险因素。
以下是一些较弱的任务:
- 下周安排与 jane@acme.corp 的会议。
- 在支付日志中搜索
purchase_complete和customer_id=9182。 - 查找客户 ID 45892 的取消请求。
每个评估提示都应该与一个可验证的响应或结果配对。你的验证器可以像基础事实和采样响应之间的精确字符串比较一样简单,也可以像请求 Claude 判断响应一样高级。避免过于严格的验证器,因为它们会由于格式、标点或有效替代措辞等虚假差异而拒绝正确的响应。
对于每个提示-响应对,你还可以选择指定你期望智能体在解决任务时调用的工具,以衡量智能体在评估过程中是否成功掌握了每个工具的目的。但是,由于解决任务可能有多个有效路径,所以尽量避免过度指定或过度拟合策略。
运行评估
我们建议使用直接的 LLM API 调用以编程方式运行你的评估。使用简单的智能体循环(while 循环包装交替的 LLM API 和工具调用):每个评估任务一个循环。每个评估智能体应该被赋予一个任务提示和你的工具。
在你的评估智能体的系统提示中,我们建议指示智能体不仅输出结构化响应块(用于验证),还要输出推理和反馈块。指示智能体在工具调用和响应块之前输出这些内容,可以通过触发思维链 (CoT) 行为来提高 LLM 的有效智能。
如果你使用 Claude 运行你的评估,你可以打开交错思考以获得类似的"现成"功能。这将帮助你探究智能体为什么调用或不调用某些工具,并突出工具描述和规范中需要改进的具体领域。
除了顶级准确率之外,我们建议收集其他指标,如单个工具调用和任务的总运行时间、工具调用总数、总令牌消耗和工具错误。跟踪工具调用可以帮助揭示智能体追求的常见工作流,并提供一些工具合并的机会。
 我们内部 Asana 工具的留存测试集性能
分析结果 智能体是你的有用伙伴,它们可以发现问题并提供从矛盾的工具描述到低效的工具实现和令人困惑的工具模式的所有反馈。但是,请记住,智能体在反馈和响应中省略的内容往往比它们包含的内容更重要。LLM 并不总是说出它们的意思。
观察你的智能体在哪里被难住或困惑。通读评估智能体的推理和反馈(或 CoT)以识别粗糙的边缘。查看原始转录(包括工具调用和工具响应)以捕获智能体 CoT 中未明确描述的任何行为。读懂字里行间的意思;记住你的评估智能体不一定知道正确的答案和策略。
分析你的工具调用指标。大量冗余的工具调用可能表明需要调整分页或令牌限制参数;大量无效参数的工具错误可能表明工具需要更清晰的描述或更好的示例。当我们推出 Claude 的网络搜索工具时,我们发现 Claude 不必要地在工具的 query 参数后附加了 2025,这使搜索结果产生偏见并降低了性能(我们通过改进工具描述引导 Claude 朝正确方向发展)。
与智能体协作
你甚至可以让智能体分析你的结果并为你改进工具。只需将评估智能体的转录连接起来,并粘贴到 Claude Code 中。Claude 是分析转录和一次性重构大量工具的专家——例如,确保工具实现和描述在进行新更改时保持自洽。
事实上,这篇文章中的大多数建议都来自于用 Claude Code 反复优化我们的内部工具实现。我们的评估是在我们的内部工作空间之上创建的,反映了我们内部工作流的复杂性,包括真实的项目、文档和消息。
我们依靠留存测试集来确保我们不会过度拟合到我们的"训练"评估。这些测试集显示,我们可以获得额外的性能改进,甚至超过我们使用"专家"工具实现所取得的成果——无论这些工具是由我们的研究人员手动编写还是由 Claude 自己生成的。
在下一节中,我们将分享我们从这个过程中学到的一些东西。
编写有效工具的原则
在本节中,我们将我们的学习提炼为编写有效工具的几个指导原则。
为智能体选择正确的工具
更多工具并不总是带来更好的结果。我们观察到的一个常见错误是,工具仅仅包装现有的软件功能或 API 端点——无论这些工具是否适合智能体。这是因为智能体与传统软件有不同的"可供性"——也就是说,它们感知可以用这些工具采取的潜在行动的方式不同。
LLM 智能体有有限的"上下文"(也就是说,它们一次可以处理多少信息是有限的),而计算机内存便宜且丰富。考虑在地址簿中搜索联系人的任务。传统软件程序可以有效地存储和处理联系人列表,一次一个,检查每个然后继续。
但是,如果 LLM 智能体使用一个返回所有联系人然后必须逐个令牌读取每个联系人的工具,它就会在无关信息上浪费其有限的上下文空间(想象一下通过从上到下阅读每一页来在你的地址簿中搜索联系人——也就是说,通过暴力搜索)。更好和更自然的方法(对于智能体和人类都一样)是先跳到相关页面(也许按字母顺序找到它)。
我们建议构建一些针对特定高影响力工作流的深思熟虑的工具,这些工具与你的评估任务相匹配,并从那里开始扩展。在地址簿案例中,你可能选择实现 search_contacts 或 message_contact 工具而不是 list_contacts 工具。
工具可以合并功能,在后台处理潜在的多个离散操作(或 API 调用)。例如,工具可以用相关元数据丰富工具响应,或者在单个工具调用中处理经常链接的多步骤任务。
以下是一些例子:
- 与其实现
list_users、list_events和create_event工具,不如考虑实现一个schedule_event工具,它可以找到可用性并安排事件。 - 与其实现
read_logs工具,不如考虑实现一个search_logs工具,它只返回相关的日志行和一些周围的上下文。 - 与其实现
get_customer_by_id、list_transactions和list_notes工具,不如实现一个get_customer_context工具,它一次性编译所有客户的最近和相关信息。
确保你构建的每个工具都有一个清晰、独特的目的。工具应该使智能体能够细分和解决任务,就像人类在访问相同的底层资源时所做的那样,同时减少否则会被中间输出消耗的上下文。
太多工具或重叠的工具也会分散智能体追求高效策略的注意力。仔细、有选择地规划你构建(或不构建)的工具真的会有回报。
对你的工具进行命名空间划分
你的 AI 智能体可能会获得对数十个 MCP 服务器和数百个不同工具的访问——包括其他开发者的工具。当工具在功能上重叠或目的模糊时,智能体可能会对使用哪些工具感到困惑。
命名空间划分(将相关工具分组在公共前缀下)可以帮助在大量工具之间划定界限;MCP 客户端有时会默认这样做。例如,按服务(例如,asana_search、jira_search)和按资源(例如,asana_projects_search、asana_users_search)对工具进行命名空间划分,可以帮助智能体在正确的时间选择正确的工具。
我们发现选择基于前缀和基于后缀的命名空间划分对我们的工具使用评估有不小的影响。效果因 LLM 而异,我们鼓励你根据自己的评估选择命名方案。
智能体可能会调用错误的工具、用错误的参数调用正确的工具、调用太少的工具,或者错误地处理工具响应。通过有选择地实现名称反映任务自然细分的工具,你同时减少了加载到智能体上下文中的工具和工具描述的数量,并将智能体计算从智能体的上下文卸载回工具调用本身。这降低了智能体犯错误的整体风险。
从你的工具返回有意义的上下文
同样,工具实现应该注意只向智能体返回高信号信息。它们应该优先考虑上下文相关性而不是灵活性,并避免低级技术标识符(例如:uuid、256px_image_url、mime_type)。像 name、image_url 和 file_type 这样的字段更有可能直接告知智能体的下游行动和响应。
智能体在处理自然语言名称、术语或标识符方面也往往比处理神秘标识符要成功得多。我们发现,仅仅将任意字母数字 UUID 解析为更具语义意义和可解释的语言(甚至是 0 索引的 ID 方案),通过减少幻觉显著提高了 Claude 在检索任务中的精确度。
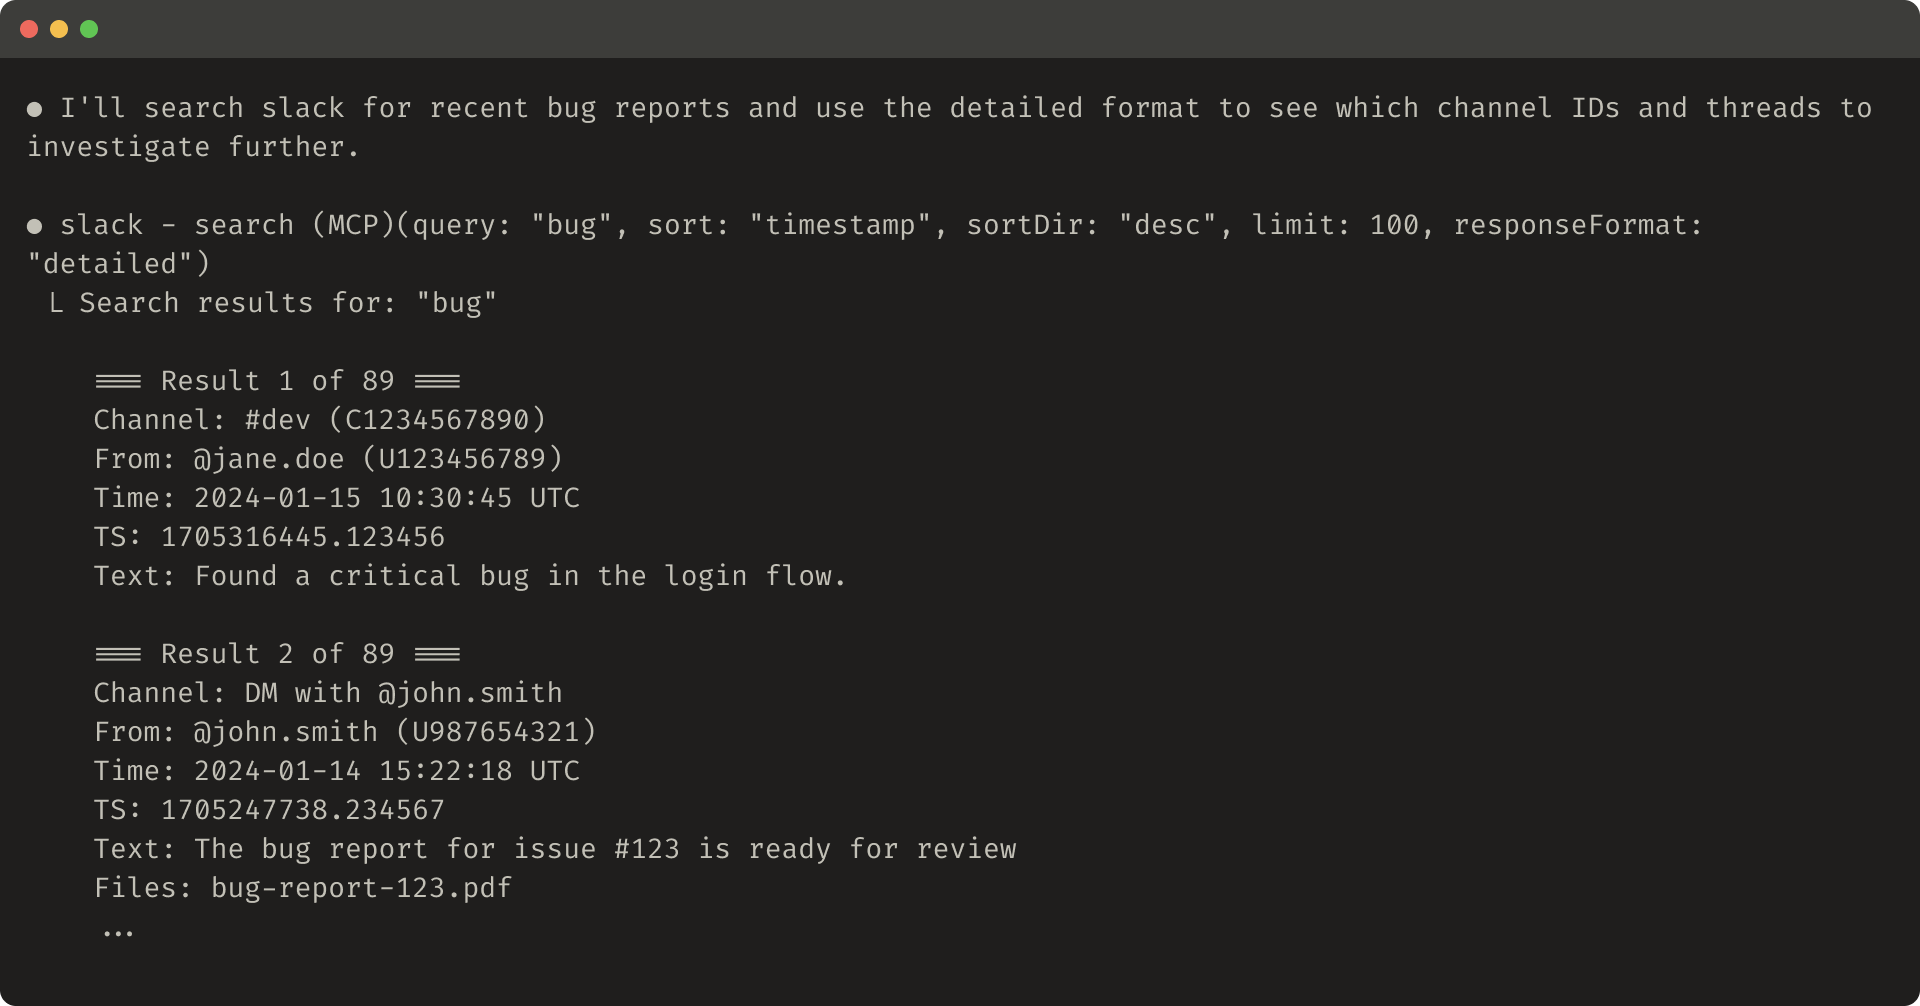
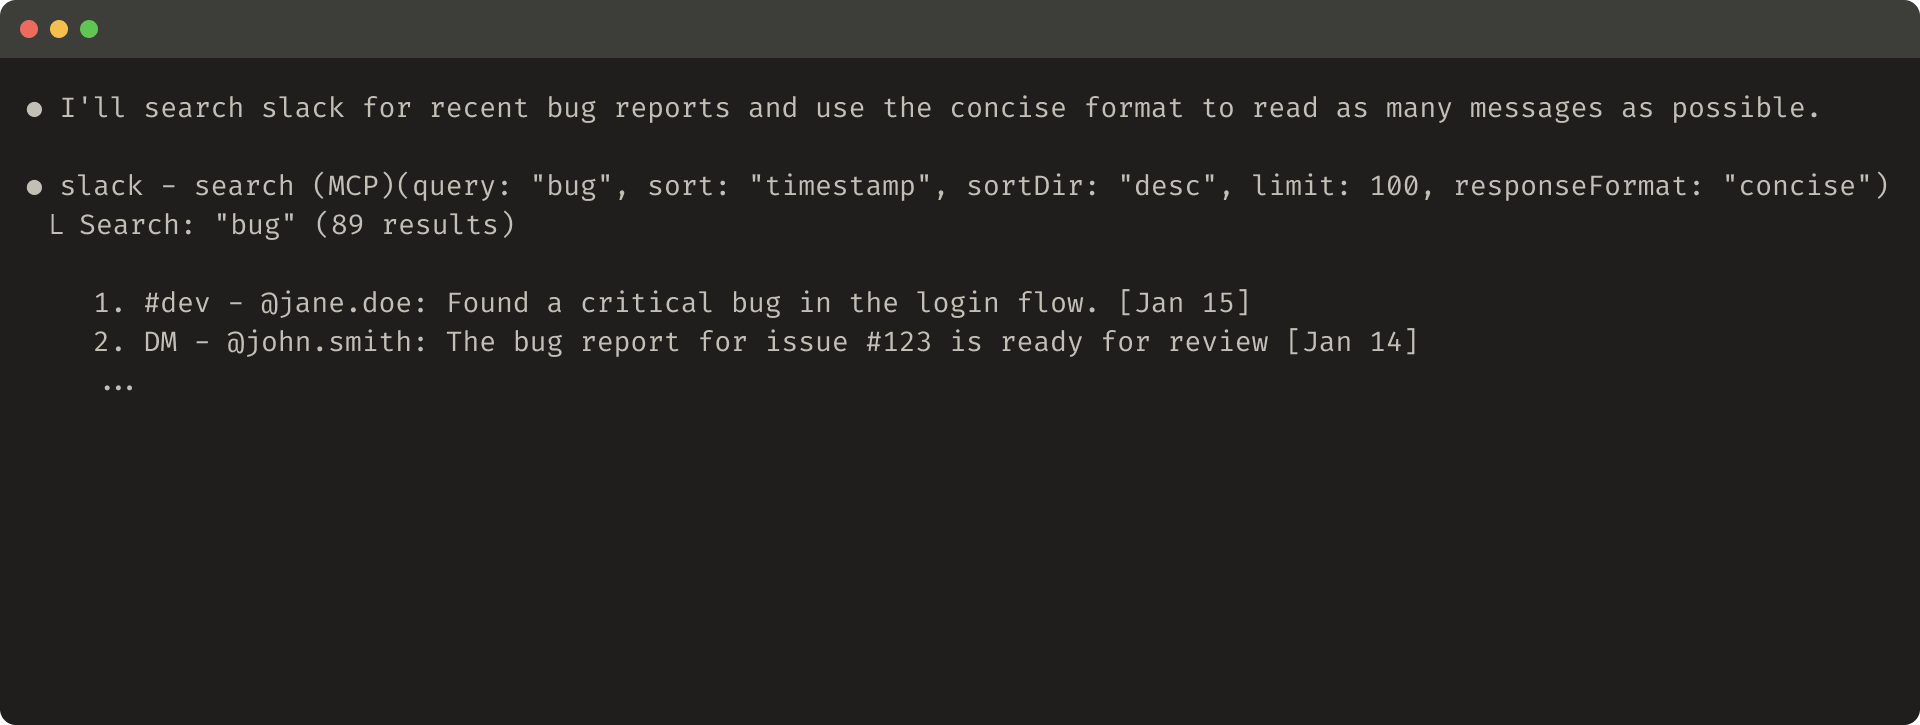
在某些情况下,智能体可能需要与自然语言和技术标识符输出交互的灵活性,即使只是为了触发下游工具调用(例如,search_user(name='jane') → send_message(id=12345))。你可以通过在你的工具中暴露一个简单的 response_format 枚举参数来实现这两种方式,允许你的智能体控制工具是返回 "concise" 还是 "detailed" 响应(见下图)。
你可以添加更多格式以获得更大的灵活性,类似于 GraphQL,你可以准确选择你想要接收哪些信息。以下是一个控制工具响应详细程度的 ResponseFormat 枚举示例:
enum ResponseFormat {
   DETAILED = "detailed",
   CONCISE = "concise"
}
以下是详细工具响应的示例(206 个令牌):
以下是简洁工具响应的示例(72 个令牌):
 Slack 线程和线程回复由唯一的
thread_ts 标识,获取线程回复需要这个。thread_ts 和其他 ID(channel_id、user_id)可以从 "detailed" 工具响应中检索,以启用需要这些的进一步工具调用。"concise" 工具响应只返回线程内容,不包括 ID。在这个例子中,我们使用 "concise" 工具响应使用了约 ⅓ 的令牌。
甚至你的工具响应结构——例如 XML、JSON 或 Markdown——也会对评估性能产生影响:没有万能的解决方案。这是因为 LLM 是基于下一个令牌预测进行训练的,并且倾向于使用与其训练数据匹配的格式表现更好。最佳响应结构会因任务和智能体而异。我们鼓励你根据自己的评估选择最佳响应结构。
优化工具响应的令牌效率
优化上下文质量很重要。但优化工具响应返回给智能体的上下文数量也很重要。
我们建议为任何可能占用大量上下文的工具响应实现分页、范围选择、过滤和/或截断的某种组合,并使用合理的默认参数值。对于 Claude Code,我们默认将工具响应限制为 25,000 个令牌。我们预计智能体的有效上下文长度会随着时间的推移而增长,但对上下文高效工具的需求将保持不变。
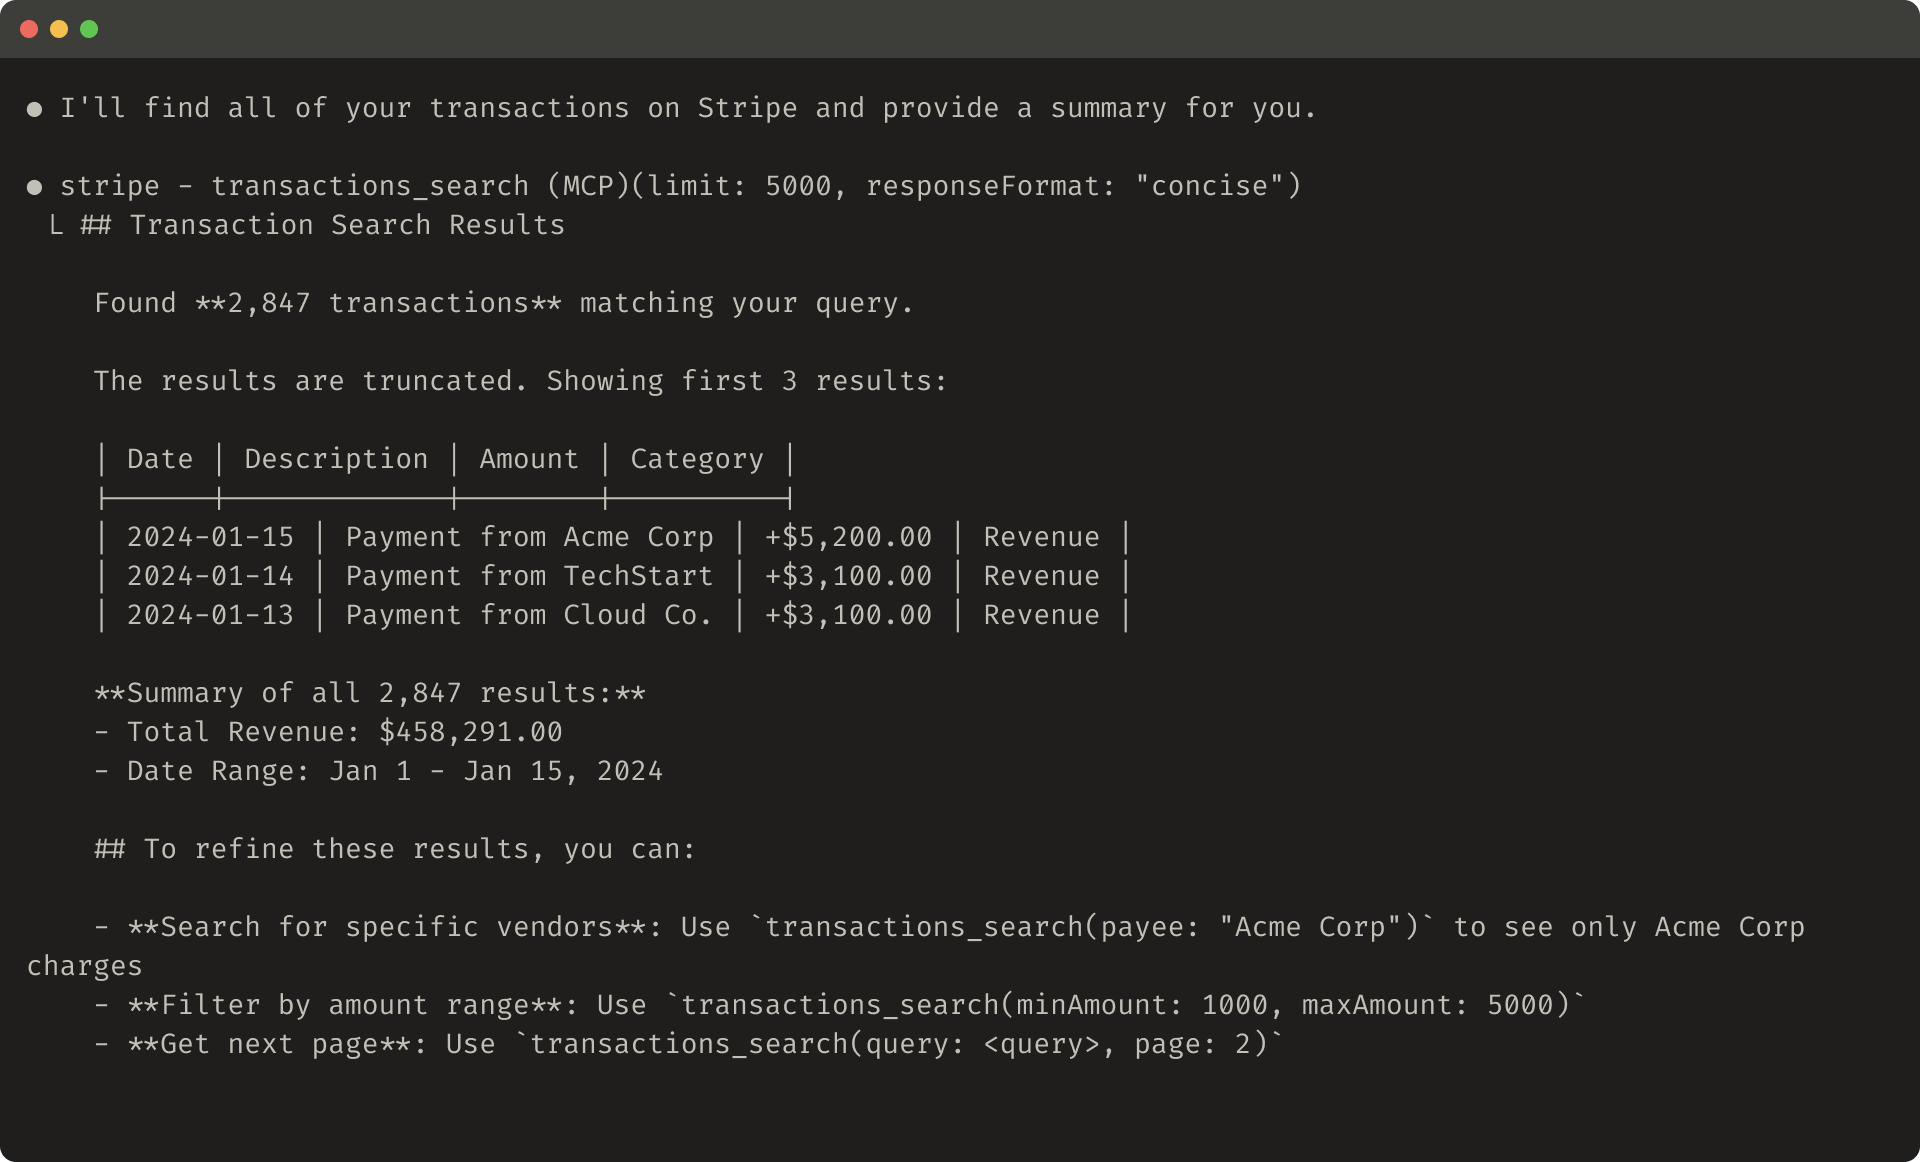
如果你选择截断响应,一定要用有用的指令引导智能体。你可以直接鼓励智能体追求更令牌高效的策略,比如进行许多小而有针对性的搜索,而不是针对知识检索任务进行单个广泛的搜索。同样,如果工具调用引发错误(例如,在输入验证期间),你可以对错误响应进行提示工程,以清晰地传达具体和可操作的改进,而不是不透明的错误代码或跟踪。
以下是截断工具响应的示例:
以下是无益错误响应的示例:
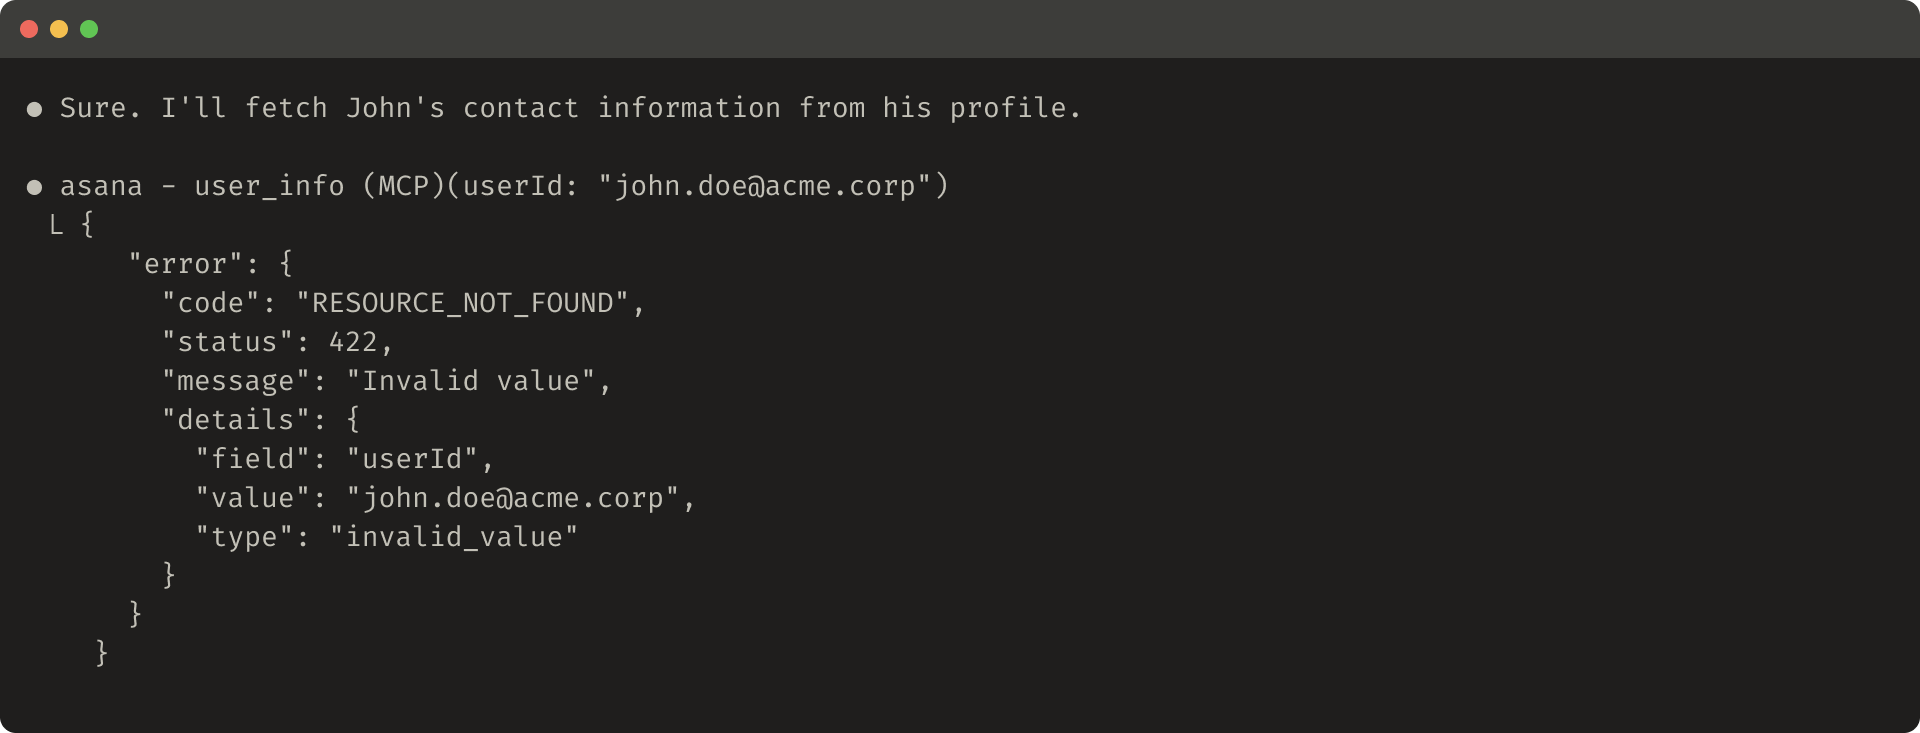
以下是有益错误响应的示例:
 工具截断和错误响应可以引导智能体采取更令牌高效的工具使用行为(使用过滤器或分页),或给出正确格式化的工具输入示例。
对你的工具描述进行提示工程
现在我们来谈谈改进工具的最有效方法之一:对你的工具描述和规范进行提示工程。因为这些被加载到你的智能体的上下文中,它们可以共同引导智能体采取有效的工具调用行为。
在编写工具描述和规范时,想想你会如何向团队的新成员描述你的工具。考虑你可能隐含带来的上下文——专门的查询格式、小众术语的定义、底层资源之间的关系——并使其明确。通过清晰描述(并用严格的数据模型强制执行)预期的输入和输出来避免歧义。特别是,输入参数应该明确命名:不要使用名为 user 的参数,尝试名为 user_id 的参数。
通过你的评估,你可以更有信心地衡量提示工程的影响。即使是工具描述的微小改进也能带来显著的改进。Claude Sonnet 3.5 在我们对工具描述进行精确改进后,在 SWE-bench Verified 评估中取得了最先进的性能,显著降低了错误率并提高了任务完成率。
你可以在我们的开发者指南中找到工具定义的其他最佳实践。如果你正在为 Claude 构建工具,我们还建议阅读工具如何动态加载到 Claude 的系统提示中。最后,如果你正在为 MCP 服务器编写工具,工具注释有助于披露哪些工具需要开放世界访问或进行破坏性更改。
展望未来
为智能体构建有效的工具,我们需要将我们的软件开发实践从可预测的确定性模式重新定位到非确定性模式。
通过我们在本文中描述的迭代、评估驱动的过程,我们已经确定了使工具成功的一致模式:有效的工具是有意且清晰定义的,明智地使用智能体上下文,可以在多样化的工作流中组合在一起,并使智能体能够直观地解决真实世界的任务。
在未来,我们预计智能体与世界交互的具体机制会演变——从 MCP 协议的更新到底层 LLM 本身的升级。通过系统、评估驱动的方法来改进智能体的工具,我们可以确保随着智能体变得更有能力,它们使用的工具也会随之演变。
致谢
由 Ken Aizawa 撰写,研究团队(Barry Zhang、Zachary Witten、Daniel Jiang、Sami Al-Sheikh、Matt Bell、Maggie Vo)、MCP 团队(Theodora Chu、John Welsh、David Soria Parra、Adam Jones)、产品工程团队(Santiago Seira)、营销团队(Molly Vorwerck)、设计团队(Drew Roper)和应用 AI 团队(Christian Ryan、Alexander Bricken)的同事提供了宝贵贡献。
¹除了训练底层 LLM 本身。