使用 MCP 执行代码:构建更高效的 AI 智能体 \ Anthropic
来源: https://www.anthropic.com/engineering/code-execution-with-mcp 抓取时间: 2026-07-21 16:19:09
模型上下文协议 (MCP) 是连接 AI 智能体与外部系统的开放标准。传统上,将智能体连接到工具和数据需要为每对集成定制实现,这造成了碎片化和重复工作,使得真正的互联系统难以扩展。MCP 提供了一个通用协议——开发者在其智能体中实现一次 MCP,即可解锁整个集成生态系统。
自 2024 年 11 月推出 MCP 以来,采用速度很快:社区已经构建了数千个 MCP 服务器,所有主要编程语言都有 SDK,行业已将 MCP 作为将智能体连接到工具和数据的事实标准。
今天,开发者通常构建的智能体可以跨数十个 MCP 服务器访问数百或数千个工具。然而,随着连接工具数量的增长,预先加载所有工具定义并通过上下文窗口传递中间结果会减慢智能体的速度并增加成本。
在这篇博客中,我们将探讨代码执行如何使智能体能够更高效地与 MCP 服务器交互,在使用更少令牌的同时处理更多工具。
工具的过度令牌消耗使智能体效率降低
随着 MCP 使用规模的扩大,有两种常见模式会增加智能体的成本和延迟:
- 工具定义使上下文窗口过载;
- 中间工具结果消耗额外的令牌。
1. 工具定义使上下文窗口过载
大多数 MCP 客户端将所有工具定义直接预先加载到上下文中,使用直接工具调用语法将它们暴露给模型。这些工具定义可能如下:
gdrive.getDocument
     Description: Retrieves a document from Google Drive
     Parameters:
                documentId (required, string): The ID of the document to retrieve
                fields (optional, string): Specific fields to return
     Returns: Document object with title, body content, metadata, permissions, etc.
salesforce.updateRecord
    Description: Updates a record in Salesforce
    Parameters:
               objectType (required, string): Type of Salesforce object (Lead, Contact, Account, etc.)
               recordId (required, string): The ID of the record to update
               data (required, object): Fields to update with their new values
     Returns: Updated record object with confirmation
工具描述占用了更多的上下文窗口空间,增加了响应时间和成本。在智能体连接到数千个工具的情况下,它们需要在读取请求之前处理数十万个令牌。
2. 中间工具结果消耗额外的令牌
大多数 MCP 客户端允许模型直接调用 MCP 工具。例如,你可能会问你的智能体:"从 Google Drive 下载我的会议记录并将其附加到 Salesforce 潜在客户。"
模型将进行如下调用:
TOOL CALL: gdrive.getDocument(documentId: "abc123")
        → returns "Discussed Q4 goals...\n[full transcript text]"
           (loaded into model context)

TOOL CALL: salesforce.updateRecord(
		objectType: "SalesMeeting",
		recordId: "00Q5f000001abcXYZ",
 		data: { "Notes": "Discussed Q4 goals...\n[full transcript text written out]" }
	)
	(model needs to write entire transcript into context again)
每个中间结果都必须经过模型。在这个例子中,完整的通话记录流动了两次。对于 2 小时的销售会议,这可能意味着额外处理 50,000 个令牌。甚至更大的文档可能超过上下文窗口限制,破坏工作流程。
对于大型文档或复杂的数据结构,模型在工具调用之间复制数据时可能更容易出错。
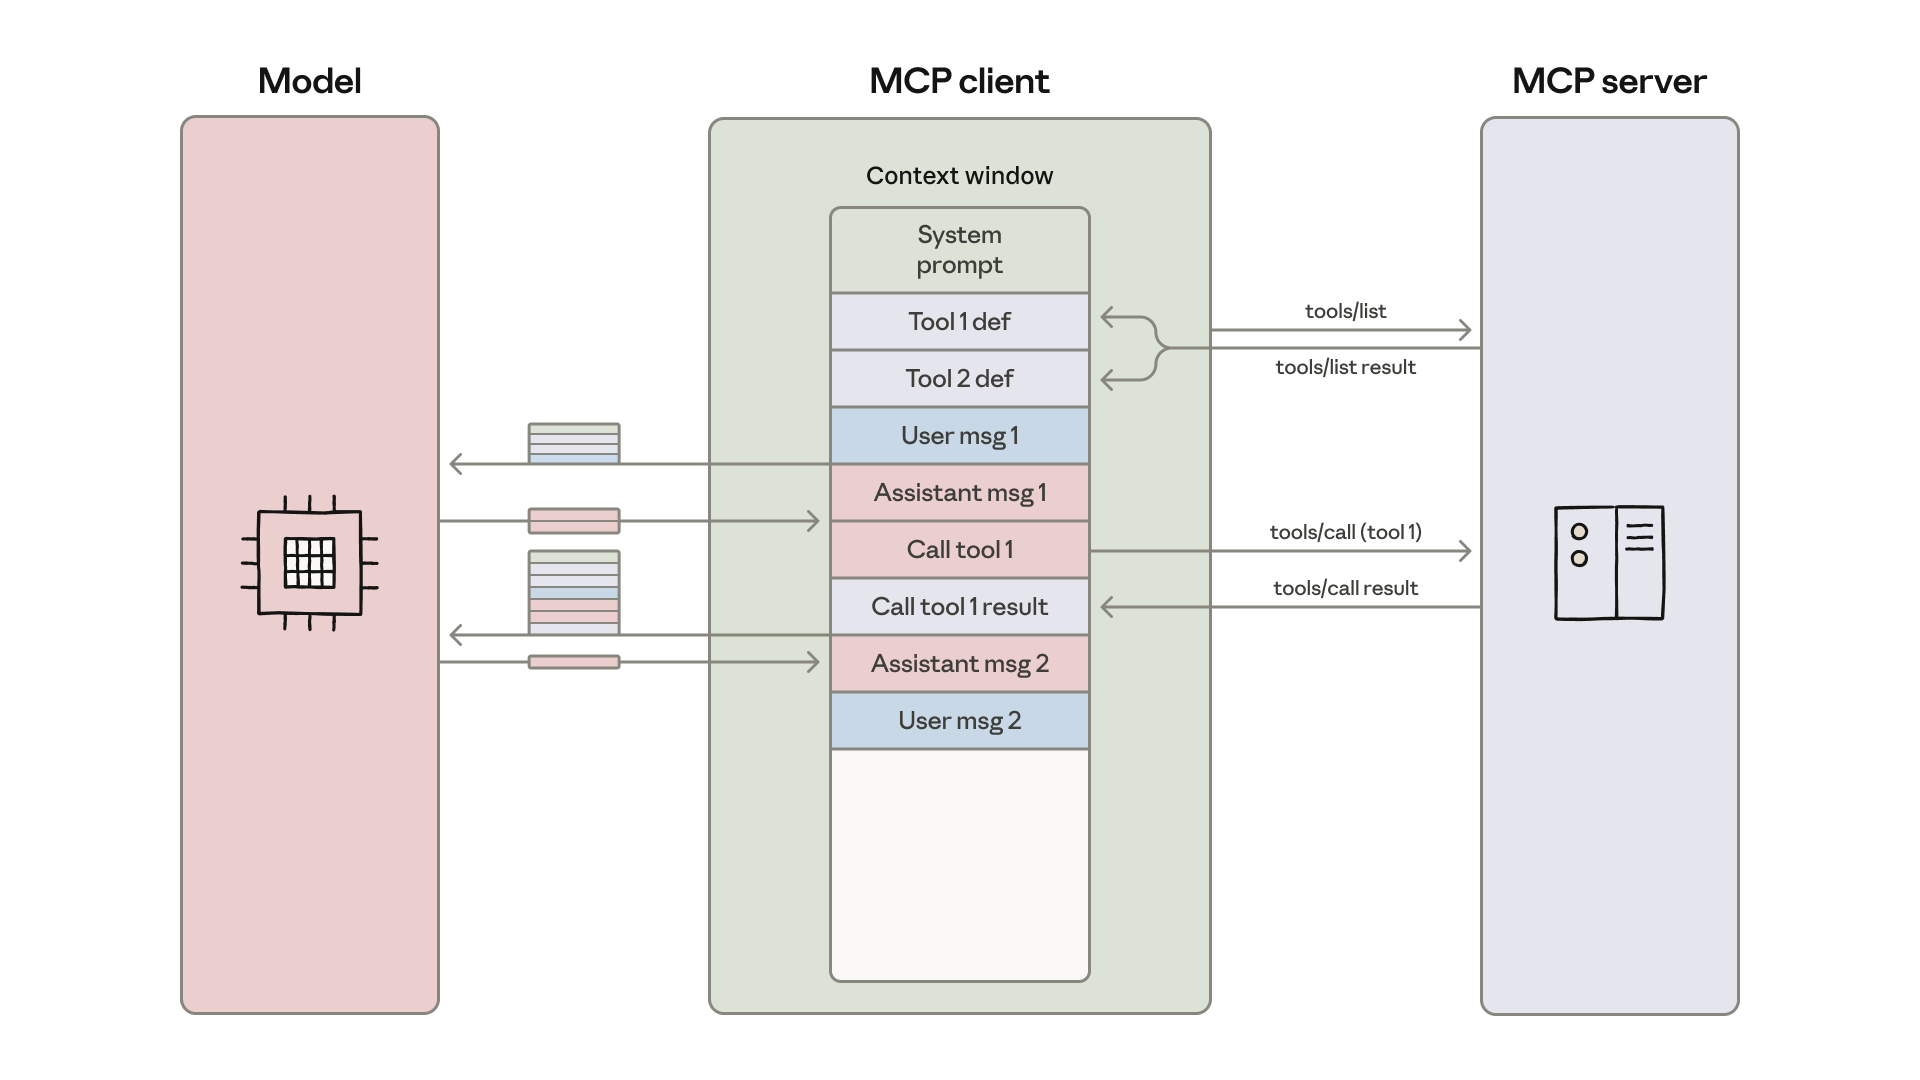 MCP 客户端将工具定义加载到模型的上下文窗口中,并编排一个消息循环,其中每个工具调用和结果在操作之间通过模型。
使用 MCP 执行代码可提高上下文效率
随着代码执行环境对智能体变得越来越普遍,解决方案是将 MCP 服务器呈现为代码 API 而不是直接工具调用。然后智能体可以编写代码来与 MCP 服务器交互。这种方法解决了两个挑战:智能体可以只加载它们需要的工具,并在将结果传递回模型之前在执行环境中处理数据。
有很多方法可以做到这一点。一种方法是从连接的 MCP 服务器生成所有可用工具的文件树。这是一个使用 TypeScript 的实现:
servers
├── google-drive
│   ├── getDocument.ts
│   ├── ... (other tools)
│   └── index.ts
├── salesforce
│   ├── updateRecord.ts
│   ├── ... (other tools)
│   └── index.ts
└── ... (other servers)
然后每个工具对应一个文件,类似于:
// ./servers/google-drive/getDocument.ts
import { callMCPTool } from "../../../client.js";

interface GetDocumentInput {
  documentId: string;
}

interface GetDocumentResponse {
  content: string;
}

/* Read a document from Google Drive */
export async function getDocument(input: GetDocumentInput): Promise<GetDocumentResponse> {
  return callMCPTool<GetDocumentResponse>('google_drive__get_document', input);
}
我们上面的 Google Drive 到 Salesforce 示例变成了代码:
// Read transcript from Google Docs and add to Salesforce prospect
import * as gdrive from './servers/google-drive';
import * as salesforce from './servers/salesforce';

const transcript = (await gdrive.getDocument({ documentId: 'abc123' })).content;
await salesforce.updateRecord({
  objectType: 'SalesMeeting',
  recordId: '00Q5f000001abcXYZ',
  data: { Notes: transcript }
});
智能体通过探索文件系统来发现工具:列出./servers/目录以找到可用的服务器(如google-drive和salesforce),然后读取它需要的特定工具文件(如getDocument.ts和updateRecord.ts)以了解每个工具的接口。这让智能体只加载当前任务所需的定义。这将令牌使用从 150,000 个令牌减少到 2,000 个令牌——节省了 98.7% 的时间和成本**。**
Cloudflare 发表了类似的发现,将使用 MCP 的代码执行称为"代码模式"。核心见解是相同的:LLM 擅长编写代码,开发者应该利用这一优势来构建与 MCP 服务器更高效交互的智能体。
使用 MCP 执行代码的好处
使用 MCP 执行代码使智能体能够通过按需加载工具、在数据到达模型之前过滤数据以及在单个步骤中执行复杂逻辑来更有效地使用上下文。使用这种方法还有安全性和状态管理的好处。
渐进式披露
模型擅长导航文件系统。将工具呈现为文件系统上的代码允许模型按需读取工具定义,而不是预先全部读取。
或者,可以向服务器添加一个search_tools工具来查找相关定义。例如,当使用上面使用的假设 Salesforce 服务器时,智能体搜索"salesforce"并只加载当前任务所需的那些工具。在search_tools工具中包含一个详细级别参数,允许智能体选择所需的详细程度(例如仅名称、名称和描述,或带有模式的完整定义),这也有助于智能体节省上下文并高效地找到工具。
上下文高效的工具结果
处理大型数据集时,智能体可以在返回结果之前在代码中过滤和转换结果。考虑获取一个 10,000 行的电子表格:
// Without code execution - all rows flow through context
TOOL CALL: gdrive.getSheet(sheetId: 'abc123')
        → returns 10,000 rows in context to filter manually

// With code execution - filter in the execution environment
const allRows = await gdrive.getSheet({ sheetId: 'abc123' });
const pendingOrders = allRows.filter(row =>
  row["Status"] === 'pending'
);
console.log(`Found ${pendingOrders.length} pending orders`);
console.log(pendingOrders.slice(0, 5)); // Only log first 5 for review
智能体看到的是 5 行,而不是 10,000 行。类似的模式适用于聚合、跨多个数据源的连接或提取特定字段——所有这些都不会使上下文窗口膨胀。
更强大和上下文高效的控制流
循环、条件和错误处理可以使用熟悉的代码模式完成,而不是链接单个工具调用。例如,如果你需要在 Slack 中收到部署通知,智能体可以编写:
let found = false;
while (!found) {
  const messages = await slack.getChannelHistory({ channel: 'C123456' });
  found = messages.some(m => m.text.includes('deployment complete'));
  if (!found) await new Promise(r => setTimeout(r, 5000));
}
console.log('Deployment notification received');
这种方法比在智能体循环中交替使用 MCP 工具调用和睡眠命令更高效。
此外,能够写出一个要执行的条件树还可以节省"首次令牌时间"延迟:智能体可以让代码执行环境执行,而不是等待模型评估 if 语句。
隐私保护操作
当智能体使用 MCP 执行代码时,中间结果默认保留在执行环境中。这样,智能体只能看到您显式记录或返回的内容,这意味着您不希望与模型共享的数据可以流经您的工作流程,而永远不会进入模型的上下文。
对于更敏感的工作负载,智能体支架可以自动对敏感数据进行令牌化。例如,假设您需要将电子表格中的客户联系人详细信息导入 Salesforce。智能体编写:
const sheet = await gdrive.getSheet({ sheetId: 'abc123' });
for (const row of sheet.rows) {
  await salesforce.updateRecord({
    objectType: 'Lead',
    recordId: row.salesforceId,
    data: {
      Email: row.email,
      Phone: row.phone,
      Name: row.name
    }
  });
}
console.log(`Updated ${sheet.rows.length} leads`);
MCP 客户端拦截数据并在到达模型之前对 PII 进行令牌化:
// What the agent would see, if it logged the sheet.rows:
[
  { salesforceId: '00Q...', email: '[EMAIL_1]', phone: '[PHONE_1]', name: '[NAME_1]' },
  { salesforceId: '00Q...', email: '[EMAIL_2]', phone: '[PHONE_2]', name: '[NAME_2]' },
  ...
]
然后,当数据在另一个 MCP 工具调用中共享时,它通过 MCP 客户端中的查找进行反令牌化。真实的电子邮件地址、电话号码和姓名从 Google Sheets 流向 Salesforce,但从不流经模型。这防止了智能体意外记录或处理敏感数据。您还可以使用此来定义确定性安全规则,选择数据可以流向和流出的位置。
状态持久化和技能
具有文件系统访问权限的代码执行允许智能体跨操作维护状态。智能体可以将中间结果写入文件,使它们能够恢复工作并跟踪进度:
const leads = await salesforce.query({
  query: 'SELECT Id, Email FROM Lead LIMIT 1000'
});
const csvData = leads.map(l => `${l.Id},${l.Email}`).join('\n');
await fs.writeFile('./workspace/leads.csv', csvData);

// Later execution picks up where it left off
const saved = await fs.readFile('./workspace/leads.csv', 'utf-8');
智能体还可以将自己的代码持久化为可重用函数。一旦智能体开发了用于任务的工作代码,它就可以保存该实现以供将来使用:
// In ./skills/save-sheet-as-csv.ts
import * as gdrive from './servers/google-drive';
export async function saveSheetAsCsv(sheetId: string) {
  const data = await gdrive.getSheet({ sheetId });
  const csv = data.map(row => row.join(',')).join('\n');
  await fs.writeFile(`./workspace/sheet-${sheetId}.csv`, csv);
  return `./workspace/sheet-${sheetId}.csv`;
}

// Later, in any agent execution:
import { saveSheetAsCsv } from './skills/save-sheet-as-csv';
const csvPath = await saveSheetAsCsv('abc123');
这与技能的概念密切相关,技能是模型在专业任务上提高性能的可重用指令、脚本和资源的文件夹。将 SKILL.md 文件添加到这些保存的函数中会创建一个模型可以参考和使用的结构化技能。随着时间的推移,这允许您的智能体构建一个更高级能力的工具箱,进化它最有效工作所需的脚手架。
请注意,代码执行引入了其自身的复杂性。运行智能体生成的代码需要一个安全的执行环境,具有适当的沙箱、资源限制和监控。这些基础设施要求增加了操作开销和安全考虑,而直接工具调用避免了这些。代码执行的好处——降低令牌成本、降低延迟和改进工具组合——应该与这些实现成本进行权衡。
总结
MCP 为智能体连接到许多工具和系统提供了一个基础协议。然而,一旦连接了太多服务器,工具定义和结果可能会消耗过多的令牌,降低智能体效率。
尽管这里的许多问题感觉很新颖——上下文管理、工具组合、状态持久化——但它们有软件工程中的已知解决方案。代码执行将这些已建立的模式应用于智能体,让它们使用熟悉的编程构造更高效地与 MCP 服务器交互。如果您实现了这种方法,我们鼓励您与 MCP 社区分享您的发现。
致谢
本文由 Adam Jones 和 Conor Kelly 撰写。感谢 Jeremy Fox、Jerome Swannack、Stuart Ritchie、Molly Vorwerck、Matt Samuels 和 Maggie Vo 对本文草稿的反馈。