我们如何为深度智能体构建评估
来源: https://www.langchain.com/blog/how-we-build-evals-for-deep-agents 抓取时间: 2026-07-21 16:24:22
深度智能体 可观测性与评估
我们如何为深度智能体构建评估
 Vivek Trivedy
Mason Daugherty
Eugene Yurtsev
Harrison Chase
2026年3月26日
10
分钟
返回博客
创建智能体
分享
关键要点
**💡 摘要:**最好的智能体评估直接衡量我们关心的智能体行为。以下是我们如何采购数据、创建指标,以及随着时间的推移运行范围明确、有针对性的实验,以使智能体更准确和可靠。
评估塑造智能体行为
我们一直在策划评估来衡量和改进深度智能体。深度智能体是一个开源、模型无关的智能体框架,为 Fleet 和 Open SWE 等产品提供支持。评估定义并塑造智能体行为,这就是为什么精心设计它们如此重要。
每个评估都是一个向量,它会改变你的智能体系统的行为。例如,如果一个高效文件读取的评估失败,你可能会调整系统提示或 read_file 工具描述来引导行为,直到它通过。你保留的每个评估都会随着时间的推移对整个系统施加压力。
在添加评估时深思熟虑至关重要。盲目添加数百(或数千)个测试是很诱人的。这会导致通过在一个可能无法准确反映你在生产中关心的行为的评估套件上取得好成绩来「改进你的智能体」的错觉。
更多评估 ≠ 更好的智能体。相反,构建反映生产中期望行为的有针对性的评估。
在构建深度智能体时,我们编目了在生产中重要的行为,例如跨文件系统中的多个文件检索内容,或按顺序准确组合 5+ 个工具调用。我们不汇总使用基准任务,而是采用以下评估策划方法:
- 决定我们希望智能体遵循哪些行为。然后研究并策划有针对性的评估,以可验证的方式衡量这些行为。
- 对于每个评估,添加一个解释_如何_衡量智能体能力的文档字符串。这确保**每个评估都是自文档化的。**我们还为每个评估标记类别,如
tool_use,以启用分组运行。 - 审查输出追踪以了解故障模式并更新评估覆盖率。
因为我们将每个评估运行追踪到共享的 LangSmith 项目,团队中的任何人都可以介入分析问题、进行修复,并重新评估给定评估的价值。这为添加和维护良好的评估创造了共同责任。在许多评估中运行许多模型也可能变得昂贵,因此有针对性的评估可以在改进智能体的同时节省资金。 在本博客中,我们涵盖:
- 我们如何策划数据
- 我们如何定义指标
- 我们如何运行评估
我们如何策划数据
我们有几种获取评估的方式:
- 使用来自内部测试我们的智能体的反馈
- 从外部基准(如 Terminal Bench 2.0 或 BFCL)中提取选定的评估,并经常为特定智能体适配它们
- 为我们认为重要的行为手工编写我们自己的(手工制作的)评估和单元测试
 我们每天都在内部测试我们的智能体。每个错误都成为编写评估和更新我们的智能体定义与上下文工程实践的机会。
💡
**注意:**我们将 SDK 单元和集成测试(系统提示传递、中断配置、子智能体路由)与模型能力评估分开。任何模型都通过这些测试,因此将它们包含在评分中不会增加信号。你绝对应该编写单元和集成测试,但本博客仅专注于模型能力评估。
内部测试智能体和阅读追踪是评估的重要来源
这使得发现错误成为可能。追踪给我们提供了解智能体行为的数据。由于追踪通常很大,我们使用内置的智能体,如 Polly 或 洞察 来大规模分析它们。你可以对其他智能体(如 Claude Code 或 深度智能体 CLI)加上一种拉取追踪的方式(如 LangSmith CLI)做同样的事情。我们的目标是了解每个故障模式,提出修复建议,重新运行智能体,并随着时间的推移跟踪进展和回归。
例如,大部分错误修复 PR 现在都是通过 Open SWE 驱动的,这是我们的开源背景编码智能体。使用它的团队接触了许多具有不同上下文、约定和目标的不同代码库。这自然会导致错误。Open SWE 的每次交互都被追踪,因此这些可以很容易地成为评估,以确保错误不会再次发生。
其他评估是从现有的基准(如用于函数调用的 BFCL)中提取和调整的。对于编码任务,我们与 Harbor 集成,以在沙盒环境中运行来自 Terminal Bench 2.0 任务等数据集的选定任务。许多评估是从零开始编写的,并作为重点测试来观察孤立的行为,例如测试 read_file 工具。
我们按测试内容对评估分组
拥有评估分类法有助于获得智能体表现的中间视图(不是单个数字,不是单个运行)。 💡 **提示:**通过查看测试内容创建该分类法,而不是它们来自哪里。
例如,来自 FRAMES 和 BFCL 的任务可以标记为「外部基准」,但这不会显示它们如何分别衡量检索和工具使用。
以下是我们定义的一些类别及其测试内容:
| 类别 | 测试内容 |
|---|---|
file_operations | 文件工具(读取、写入、编辑、列出、grep、glob)、并行调用、分页 |
retrieval | 跨文件查找信息、搜索策略、多跳文档合成 |
tool_use | 选择正确的工具、链接多步调用、跨轮跟踪状态 |
memory | 回忆种子上下文、提取隐式偏好、持久化持久信息 |
conversation | 为模糊请求提出澄清问题、通过正确操作维持多轮对话 |
summarization | 处理上下文溢出、触发摘要、压缩后恢复信息 |
unit_tests | SDK 管道——我们的系统提示传递、中断配置、子智能体路由、技能路径解析等是否都有效? |
| 今天,所有评估都是智能体在任务上的端到端运行。我们有意鼓励评估结构的多样性。有些任务从输入提示一步完成,而另一些则需要与另一个模拟用户的模型进行 10+ 轮交互。 |
我们如何定义指标
在为我们的智能体选择模型时,我们从正确性开始。如果模型无法可靠地完成我们关心的任务,其他任何事情都不重要。我们在评估中运行多个模型,并随着时间的推移改进框架以解决我们发现的问题。 衡量正确性取决于正在测试的内容。大多数内部评估使用自定义断言,例如「智能体是否并行化了工具调用?」。像 BFCL 这样的外部基准使用与数据集中的地面实况答案精确匹配。对于正确性是语义性的评估,例如智能体是否在内存中持久化了正确的内容,我们使用 LLM 作为裁判。 一旦几个模型清除了这个障碍,我们就转向效率。**在实践中,解决相同任务的两个模型的行为可能非常不同。**一个可能需要额外的轮次,进行不必要的工具调用,或者由于模型大小而更慢地完成任务。在生产中,这些差异表现为更高的延迟、更高的成本和更差的整体用户体验。 总之,我们为每个评估器运行测量的指标是:
| 指标 | 定义 |
|---|---|
| 正确性 | 模型是否正确完成了任务 |
| 步数比率 | 观察到的智能体步数 / 理想智能体步数 |
| 工具调用比率 | 观察到的工具调用 / 理想工具调用 |
| 延迟比率 | 观察到的延迟 / 理想延迟 |
| 解决率 | 预期步数 / 观察到的延迟,如果任务未正确解决则得分为 0 |
| 解决率衡量智能体解决任务的速度,按预期步数标准化。与延迟比率一样,它捕获端到端解决任务的时间,包括模型往返、提供商延迟、错误转向和工具执行时间。对于我们可以定义理想轨迹的简单任务,解决率可能比延迟比率更容易使用,因为它只需要测量给定智能体的任务持续时间。 | |
| 这为我们提供了一种使用有针对性的评估集选择模型的简单方法: |
- 首先检查正确性:哪些模型在你实际关心的任务上足够准确?
- 然后比较效率:在足够好的模型中,哪一个在正确性、延迟和成本之间提供了最佳权衡?
围绕评估的有用指标示例
为了使模型比较可操作,我们检查模型_如何_成功和失败。除了准确性之外,这还需要一个具体的参考点来定义「良好」执行是什么。我们使用的一个原语是**理想轨迹。**这是产生正确结果而没有「不必要」操作的步骤序列。 对于简单、范围明确的任务,变量定义得足够紧密,最优路径通常是显而易见的。对于更开放的任务,我们使用迄今为止我们见过的表现最好的模型来近似轨迹,然后随着模型和框架的改进重新审视基线。通过这种方式,观察智能体行为有助于我们完善关于理想轨迹的先验知识。 考虑一个简单的请求:
「我住的地方现在的时间和天气是多少?」 智能体的理想轨迹可能如下所示:
- 它进行最少必要的工具调用(例如,解析用户 → 解析位置 → 获取时间和天气)
- 它尽可能并行化独立的工具调用
- 它产生最终答案而没有不必要的中间轮次
**理想轨迹:**4 步,4 次工具调用,约 8 秒
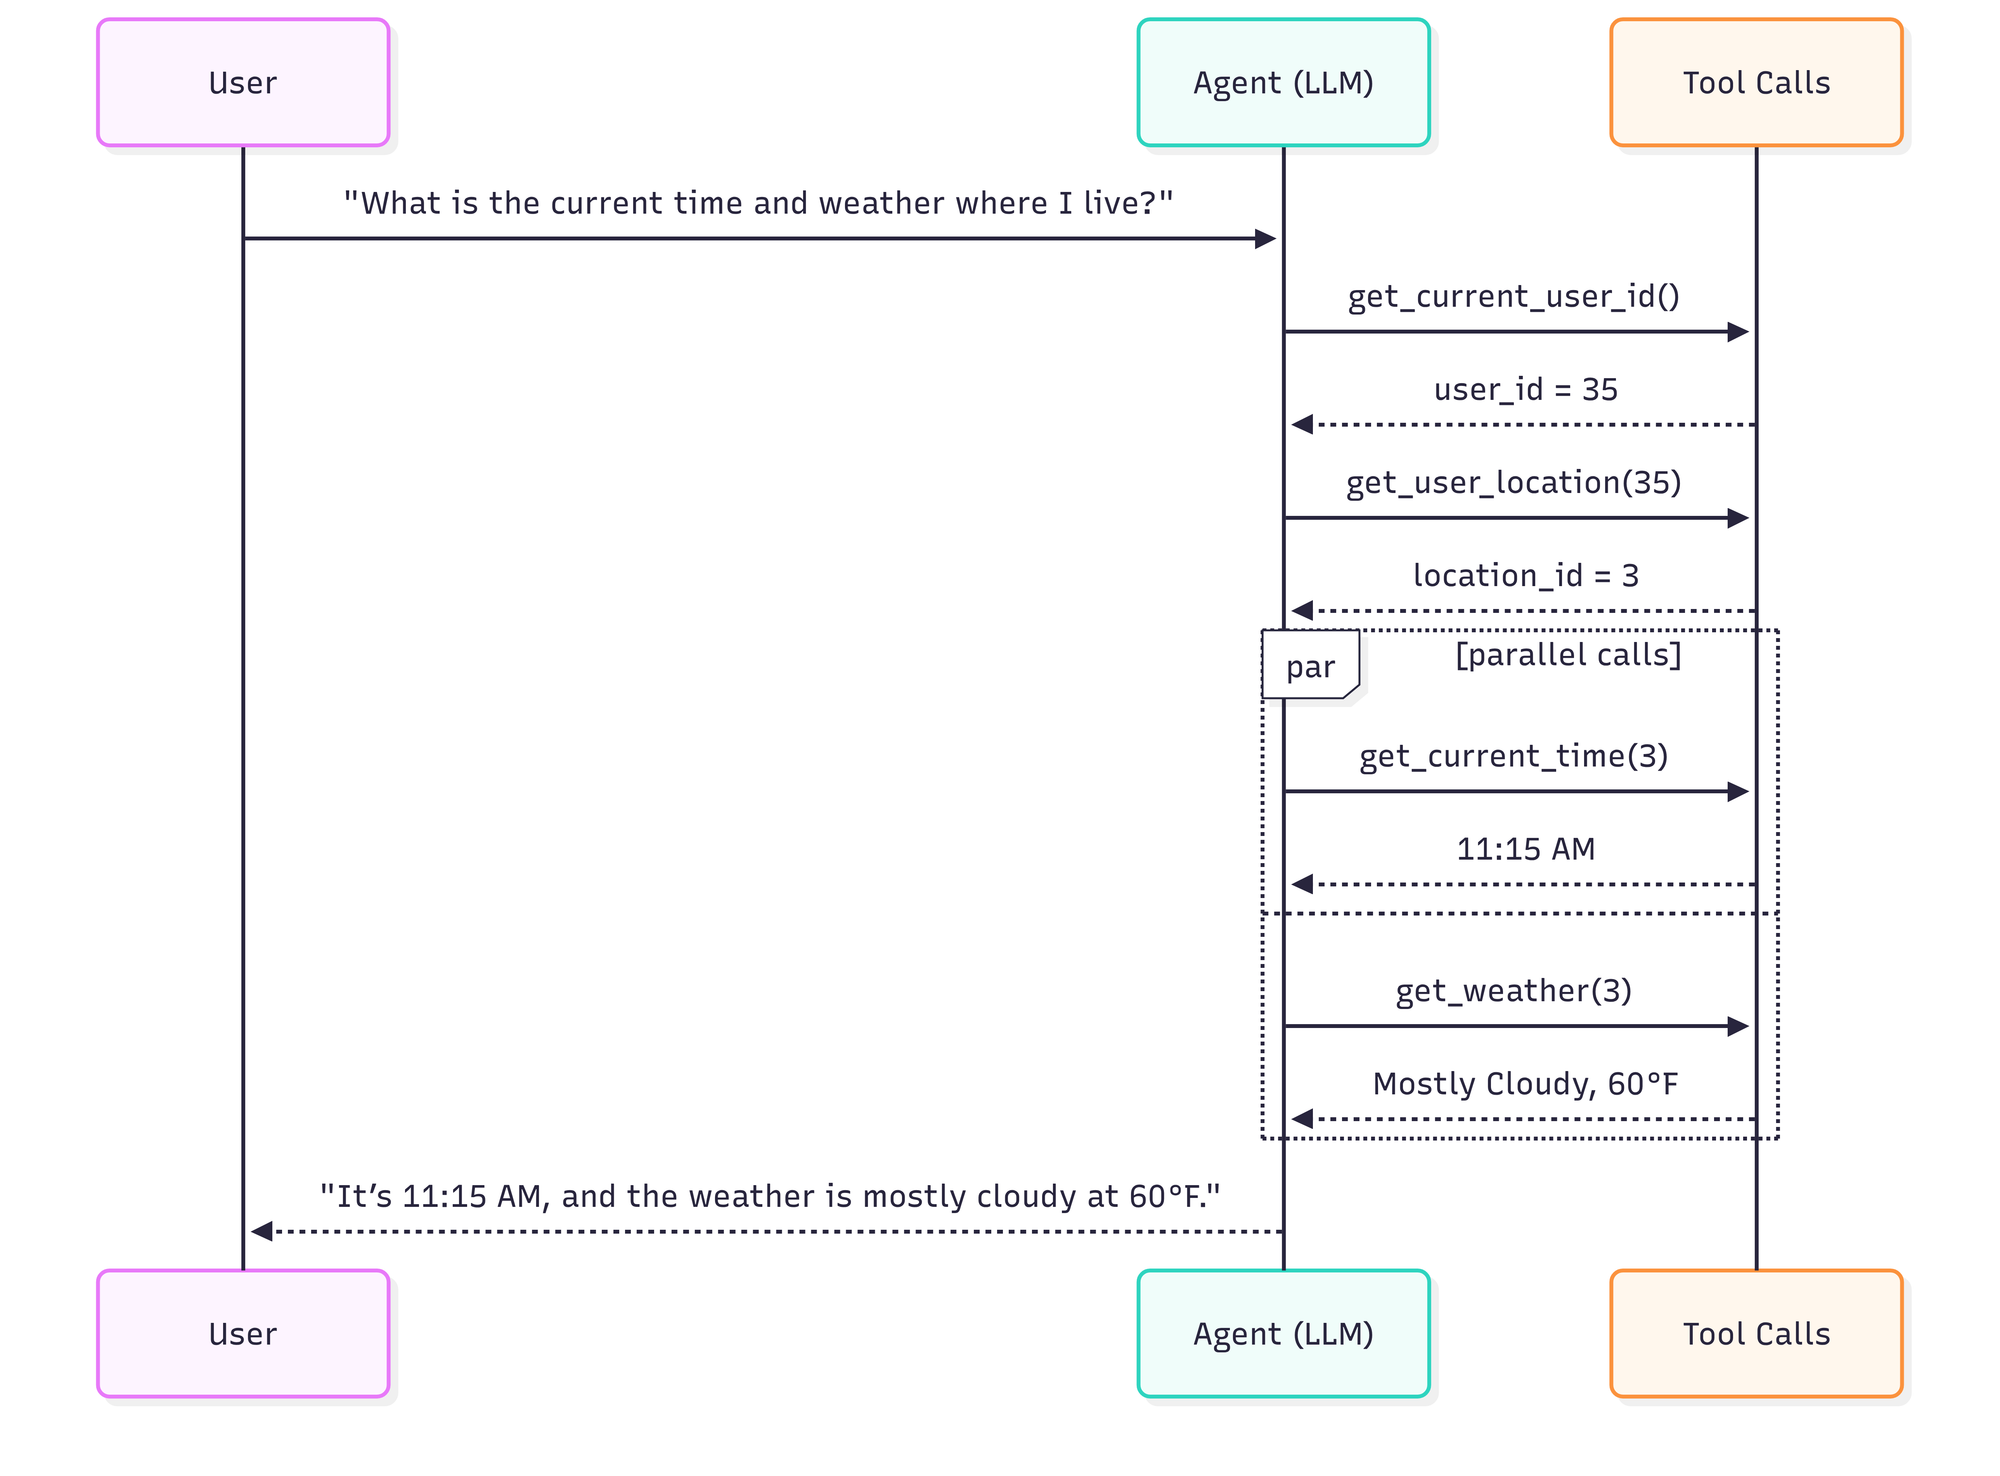 现在将其与一个在技术上仍然正确但效率较低的轨迹进行比较。
**低效轨迹:**6 步,5 次工具调用,约 14 秒。
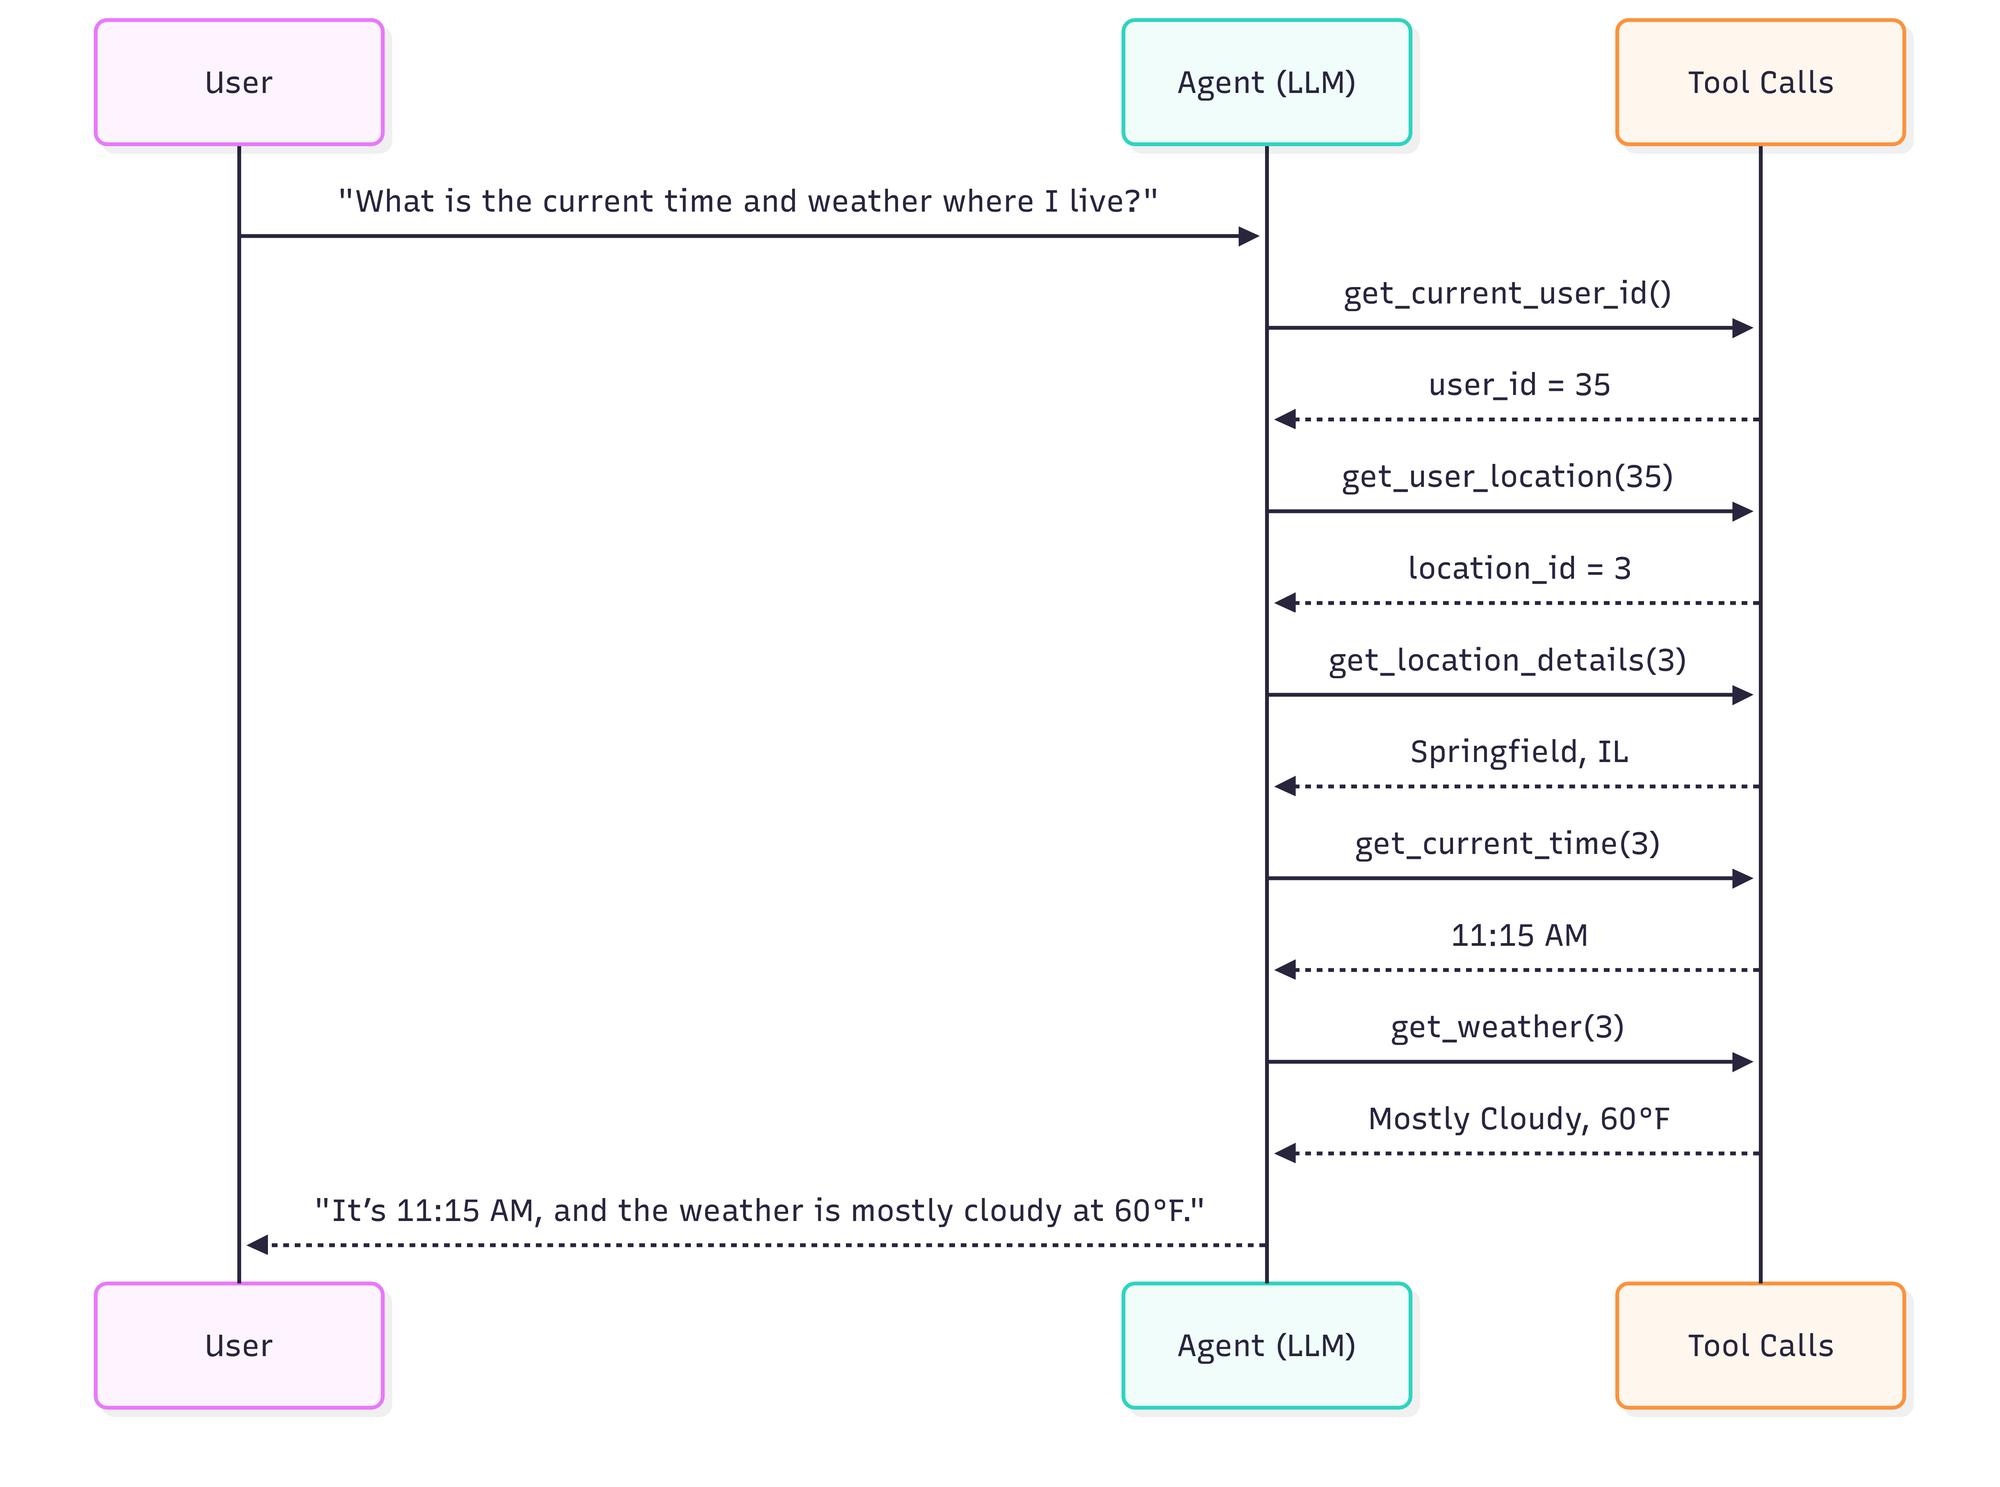 **正确但低效的轨迹:**6 个智能体步骤,5 次工具调用,包含不必要的工具调用,并且没有并行化工具调用。
以上示例是说明性的:REPL 可以更快地解决这个特定任务,但更简单的工具调用版本使想法更容易解释。
两次运行都是正确的,但第二次运行增加了延迟和成本,并创造了更多的失败机会。
这个框架使我们能够在评估中评估正确性和效率。我们维护和更新指标,以将运行提炼成我们可以用来比较实验的可测量数字。
从上面的示例中,低效但正确的运行将得分:
| 指标 | 定义 | 示例 | 解释 |
|---|---|---|---|
| 正确性 | 模型是否正确完成了任务 | 1 | 运行成功 |
| 步数比率 | 观察到的智能体步数 / 理想智能体步数 | 6 / 4 = 1.5 | 智能体步数比理想多 50%;越低越好 |
| 工具调用比率 | 观察到的工具调用 / 理想工具调用 | 5 / 4 = 1.25 | 工具调用比理想多 25%;越低越好 |
| 延迟比率 | 观察到的延迟 / 理想延迟 | 14 / 8 = 1.75 | 比理想慢 75%;越低越好 |
| 解决率 | 预期步数 / 观察到的延迟,如果任务未正确解决则得分为 0 | 4 / 14 = 0.29 预期步数/秒 | 通过预期轨迹的进展更快;越高越好 |
我们如何运行评估
我们使用带有 GitHub Actions 的 pytest 在 CI 中运行评估,以便更改在干净、可重现的环境中运行。每个评估创建一个带有给定模型的深度智能体实例,向其提供任务,并计算正确性和效率指标。
我们还可以使用标签运行评估的子集,以节省成本并衡量有针对性的实验。例如,如果构建一个需要大量本地文件处理和合成的智能体,我们可能专注于标记为 file_operations 和 tool_use 的子集。
export LANGSMITH_API_KEY="lsv2_..."

uv run pytest tests/evals --eval-category file_operations --eval-category tool_use --model baseten:nvidia/zai-org/GLM-5
我们的评估架构和实现在深度智能体存储库中是开源的。
下一步是什么
我们正在扩展我们的评估套件,并围绕开源 LLM 做更多工作!我们很期待很快分享一些东西:
- 开放模型在评估类别中与封闭前沿模型相比如何
- 评估作为一种实时自动改进智能体任务的机制
- 公开分享我们如何随着时间的推移为每个智能体维护、减少和扩展评估
深度智能体是完全开源的。试试看,让我们知道你的想法!我们很乐意帮助团队构建出色的智能体和评估。
相关内容
 可观测性与评估
IssueBench——我们如何评估 Engine
 Nick Bray
Arjun Nargolwala
2026年7月20日
 6
分钟
 可观测性与评估
改进智能体是一个数据挖掘问题
Vivek Trivedy
2026年7月7日
7
分钟
 LangChain
LangSmith
可观测性与评估
你的编码智能体账单翻倍了。以下是如何修复它。
 Amy Ru
2026年7月2日
6
分钟
 注册我们的新闻通讯以保持最新
谢谢!你的提交已收到!
哎呀!提交表单时出了问题。
看看你的智能体到底在做什么
LangSmith,我们的智能体工程平台,帮助开发者调试每个智能体决策、评估更改,并一键部署。 尝试 LangSmith 获取演示