展开 Codex Agent 循环 | OpenAI
来源: https://openai.com/index/unrolling-the-codex-agent-loop/ 抓取时间: 2026-07-21 16:20:17
2026年1月23日 工程
展开 Codex Agent 循环
作者:Michael Bolin,技术团队成员 加载中… Agent 循环
-
Agent 循环
-
模型推理
- 构建初始提示
- 第一轮
- 性能考虑
-
下一步
-
Agent 循环
-
模型推理
- 构建初始提示
- 第一轮
- 性能考虑
-
下一步
Codex CLI (在新窗口中打开) 是我们的跨平台本地软件 Agent,旨在在您的机器上安全高效地运行的同时,产生高质量、可靠的软件更改。自从我们在 4 月首次推出 CLI 以来 ,我们学到了大量关于如何构建世界一流软件 Agent 的知识。为了解释这些见解,这是一个持续系列中的第一篇文章,我们将探索 Codex 工作原理的各个方面,以及来之不易的教训。(要更细致地了解 Codex CLI 是如何构建的,请查看我们的开源存储库 https://github.com/openai/codex (在新窗口中打开)。如果您想了解更多,我们设计决策的许多细节都记录在 GitHub 问题和拉取请求中。) 首先,我们将关注 Agent 循环,这是 Codex CLI 中的核心逻辑,负责协调用户、模型和模型调用的工具之间的交互,以执行有意义的软件工作。我们希望这篇文章能让您很好地了解我们的 Agent(或 "harness")在使用 LLM 中所扮演的角色。 在深入之前,快速说明一下术语:在 OpenAI,"Codex" 包含一套软件 Agent 产品,包括 Codex CLI、Codex Cloud 和 Codex VS Code 扩展。这篇文章关注 Codex harness,它提供核心 Agent 循环和执行逻辑,是所有 Codex 体验的基础,并通过 Codex CLI 呈现。为方便起见,我们将互换使用 "Codex" 和 "Codex CLI" 这两个术语。
Agent 循环
每个 AI Agent 的核心都是所谓的 "Agent 循环"。Agent 循环的简化图示如下:
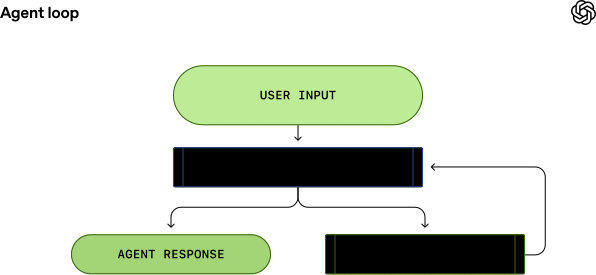 首先,Agent 从用户获取 输入,以包含在它为模型准备的文本指令集中,这些指令集被称为 提示。
下一步是通过向模型发送我们的指令并要求它生成响应来查询模型,这个过程称为 推理。在推理期间,文本提示首先被转换为输入 token (在新窗口中打开) 序列——索引到模型词汇表的整数。然后这些 token 被用来采样模型,产生新的输出 token 序列。
输出 token 被转换回文本,成为模型的响应。因为 token 是增量产生的,所以这种转换可以在模型运行时进行,这就是为什么许多基于 LLM 的应用程序显示流式输出。实际上,推理通常封装在处理文本的 API 后面,抽象掉了 token 化的细节。
作为推理步骤的结果,模型要么 (1) 对用户的原始输入产生最终响应,要么 (2) 请求 Agent 执行 工具调用(例如,"运行
ls 并报告输出")。在 (2) 的情况下,Agent 执行工具调用,并将其输出附加到原始提示。这个输出被用来生成新的输入,用于重新查询模型;然后 Agent 可以考虑这个新信息并再次尝试。
这个过程重复进行,直到模型停止发出工具调用,而是为用户生成一条消息(在 OpenAI 模型中称为 助手消息)。在许多情况下,这条消息直接回答了用户的原始请求,但也可能是对用户的后续问题。
因为 Agent 可以执行修改本地环境的工具调用,所以它的 "输出" 不限于助手消息。在许多情况下,软件 Agent 的主要输出是它在您的机器上编写或编辑的代码。然而,每一轮总是以助手消息结束——例如 "我添加了您要求的 architecture.md"——这表示 Agent 循环中的终止状态。从 Agent 的角度来看,它的工作已完成,控制权返回给用户。
图中所示的从 用户输入 到 Agent 响应 的过程被称为对话的 一轮(Codex 中的一个 线程)。虽然这个 对话轮次 可以包含 模型推理 和 工具调用 之间的多次迭代。每次您向现有对话发送新消息时,对话历史都会作为新轮次提示的一部分包含,其中包括先前轮次的消息和工具调用:
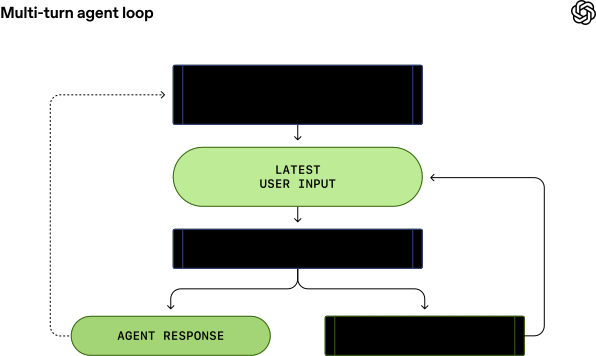 这意味着随着对话的增长,用于采样模型的提示的长度也会增长。这个长度很重要,因为每个模型都有一个 上下文窗口,这是它可以用于一次推理调用的最大 token 数。请注意,这个窗口包括输入 和 输出 token。您可能想象得到,Agent 可能决定在单轮中进行数百次工具调用,这可能会耗尽上下文窗口。因此,上下文窗口管理 是 Agent 的众多职责之一。现在,让我们深入了解 Codex 如何运行 Agent 循环。
模型推理
Codex CLI 向 Responses API (在新窗口中打开) 发送 HTTP 请求以运行模型推理。我们将研究信息如何通过 Codex 流动,Codex 使用 Responses API 驱动 Agent 循环。 Codex CLI 使用的 Responses API 端点是 可配置的 (在新窗口中打开),因此它可以与任何 实现 Responses API (在新窗口中打开) 的端点一起使用:
- 使用 ChatGPT 登录时 (在新窗口中打开) 与 Codex CLI 一起使用,它使用
https://chatgpt.com/backend-api/codex/responses作为端点 - 使用 API 密钥认证时 (在新窗口中打开) 与 OpenAI 托管模型一起使用,它使用
https://api.openai.com/v1/responses作为端点 - 当使用
--oss运行 Codex CLI 以与 ollama 0.13.4+ (在新窗口中打开) 或 LM Studio 0.3.39+ (在新窗口中打开) 一起使用 gpt-oss 时,它默认为在您的计算机上本地运行的http://localhost:11434/v1/responses - Codex CLI 可以与由 Azure 等云提供商托管的 Responses API 一起使用
让我们探索 Codex 如何为对话中的第一个推理调用创建提示。
构建初始提示
作为最终用户,当您查询 Responses API 时,您不会逐字指定用于采样模型的提示。相反,您将各种输入类型指定为查询的一部分,Responses API 服务器决定如何将这些信息构建到模型设计用于消费的提示中。您可以将提示视为 "项目列表";本节将解释您的查询如何转换为该列表。
在初始提示中,列表中的每个项目都与一个角色相关联。role 表示相关内容应该具有多大的权重,并且是以下值之一(按优先级递减顺序):system、developer、user、assistant。
Responses API (在新窗口中打开) 接受带有许多参数的 JSON 负载。我们将关注以下三个:
_instructions_(在新窗口中打开):插入到模型上下文中的系统(或开发者)消息_tools_(在新窗口中打开):模型在生成响应时可以调用的工具列表_input_(在新窗口中打开):模型的文本、图像或文件输入列表
在 Codex 中,如果指定了 ~/.codex/config.toml 中的 _model_instructions_file_ (在新窗口中打开),则从该文件读取 instructions 字段;否则,使用 与模型关联的 _base_instructions_ (在新窗口中打开)。特定于模型的指令存在于 Codex 存储库中,并捆绑到 CLI 中(例如,gpt-5.2-codex_prompt.md (在新窗口中打开))。
tools 字段是符合 Responses API 定义的模式的工具定义列表。对于 Codex,这包括由 Codex CLI 提供的工具、由 Responses API 提供的应该提供给 Codex 的工具,以及用户通常通过 MCP 服务器提供的工具:
JavaScript
`
1
[
2
  // Codex 的 [默认 shell 工具](https://github.com/openai/codex/blob/99f47d6e9a3546c14c43af99c7a58fa6bd130548/codex-rs/core/src/tools/spec.rs#L278-L340) 用于在本地生成新进程。
3
  {
4
    "type": "function",
5
    "name": "shell",
6
    "description": "Runs a shell command and returns its output...",
7
    "strict": false,
8
    "parameters": {
9
      "type": "object",
10
      "properties": {
11
        "command": {"type": "array", "description": "The command to execute", ...},
12
        "workdir": {"description": "The working directory...", ...},
13
        "timeout_ms": {"description": "The timeout for the command...", ...},
14
        ...
15
      },
16
      "required": ["command"],
17
    }
18
  }
19


20
  // Codex 的 [内置计划工具](https://github.com/openai/codex/blob/99f47d6e9a3546c14c43af99c7a58fa6bd130548/codex-rs/core/src/tools/handlers/plan.rs#L20-L60)。
21
  {
22
    "type": "function",
23
    "name": "update_plan",
24
    "description": "Updates the task plan...",
25
    "strict": false,
26
    "parameters": {
27
      "type": "object",
28
      "properties": {"plan":..., "explanation":...},
29
      "required": ["plan"]
30
    }
31
  },
32


33
  // 由 Responses API 提供的 [网络搜索工具](https://platform.openai.com/docs/guides/tools-web-search)。
34
  {
35
    "type": "web_search",
36
    "external_web_access": false
37
  },
38


39
  // MCP 服务器,用于获取天气,如用户的 ~/.codex/config.toml 中配置的。
40
  {
41
    "type": "function",
42
    "name": "mcp__weather__get-forecast",
43
    "description": "Get weather alerts for a US state",
44
    "strict": false,
45
    "parameters": {
46
      "type": "object",
47
      "properties": {"latitude": {...}, "longitude": {...}},
48
      "required": ["latitude", "longitude"]
49
    }
50
  }
51
]
最后,JSON 负载的input字段是项目列表。Codex [_插入以下项目_ (在新窗口中打开)](https://github.com/openai/codex/blob/99f47d6e9a3546c14c43af99c7a58fa6bd130548/codex-rs/core/src/codex.rs#L1387-L1415) 到input` 中,然后添加用户消息:
- 一条带有
role=developer的消息,描述 仅适用于 Codex 提供的_shell_工具 的沙箱,该工具在tools部分中定义。也就是说,其他工具(如 MCP 服务器提供的工具)不由 Codex 沙箱化,并且负责执行它们自己的防护措施。 该消息是从模板构建的,其中关键内容来自捆绑到 Codex CLI 中的 Markdown 片段,例如_workspace_write.md_(在新窗口中打开) 和_on_request.md_(在新窗口中打开):
纯文本
`
1
<permissions instructions>
2
  - description of the sandbox explaining file permissions and network access
3
  - instructions for when to ask the user for permissions to run a shell command
4
  - list of folders writable by Codex, if any
5
</permissions instructions>
2.(可选)一条带有role=developer的消息,其内容是从用户的config.toml文件中读取的developer_instructions值。 3.(可选)一条带有role=user` 的消息,其内容是 "用户指令",它们不是来自单个文件,而是 跨多个来源聚合 (在新窗口中打开)。通常,更具体的指令出现在后面:
$CODEX_HOME中的AGENTS.override.md和AGENTS.md的内容- 受限于一个限制(默认 32 KiB),从
cwd的 Git/项目根目录(如果存在)一直到cwd本身的每个文件夹中查找:添加AGENTS.override.md、AGENTS.md或config.toml中由project_doc_fallback_filenames指定的任何文件名的内容 - 如果配置了任何 技能 (在新窗口中打开):
- 关于技能的简短序言
- 每个技能的 技能元数据 (在新窗口中打开)
- 关于 如何使用技能 (在新窗口中打开) 的部分
- 一条带有
role=user的消息,描述 Agent 当前运行的本地环境。这 指定当前工作目录和用户的 shell (在新窗口中打开):
纯文本
`
1
<environment_context>
2
  <cwd>/Users/mbolin/code/codex5</cwd>
3
  <shell>zsh</shell>
4
</environment_context>
一旦 Codex 完成了上述所有计算以初始化input,它就会附加用户消息以开始对话。 前面的示例侧重于每条消息的内容,但请注意,input的每个元素都是一个带有type、[role(在新窗口中打开)](https://www.reddit.com/r/OpenAI/comments/1hgxcgi/what_is_the_purpose_of_the_new_developer_role_in/) 和 content` 的 JSON 对象,如下所示:
JSON
`
1
{
2
  "type": "message",
3
  "role": "user",
4
  "content": [
5
    {
6
      "type": "input_text",
7
      "text": "Add an architecture diagram to the README.md"
8
    }
9
  ]
10
}
一旦 Codex 构建了要发送到 Responses API 的完整 JSON 负载,它就会发出带有Authorization标头的 HTTP POST 请求,具体取决于~/.codex/config.toml中 Responses API 端点的配置方式(如果指定了额外的 HTTP 标头和查询参数,则会添加它们)。 当 OpenAI Responses API 服务器收到请求时,它使用 JSON 来派生模型的提示,如下所示(可以肯定的是,Responses API 的自定义实现可能会做出不同的选择):  如您所见,提示中前三个项目的顺序由服务器决定,而不是客户端。也就是说,在这三个项目中,只有 _系统消息_ 的内容也由服务器控制,因为tools和instructions由客户端决定。这些后面跟着 JSON 负载中的input`,以完成提示。
现在我们有了提示,我们准备好对模型进行采样。
第一轮
对 Responses API 的这个 HTTP 请求启动了 Codex 中对话的第一 "轮"。服务器以服务器发送事件(SSE (在新窗口中打开))流进行回复。每个事件的 data 是一个带有 \"type\" 的 JSON 负载,该类型以 \"response\" 开头,可能是这样的(完整的事件列表可以在我们的 API 文档 (在新窗口中打开) 中找到):
纯文本
`
1
data: {"type":"response.reasoning_summary_text.delta","delta":"ah ", ...}
2
data: {"type":"response.reasoning_summary_text.delta","delta":"ha!", ...}
3
data: {"type":"response.reasoning_summary_text.done", "item_id":...}
4
data: {"type":"response.output_item.added", "item":{...}}
5
data: {"type":"response.output_text.delta", "delta":"forty-", ...}
6
data: {"type":"response.output_text.delta", "delta":"two!", ...}
7
data: {"type":"response.completed","response":{...}}
Codex [_消费事件流_ (在新窗口中打开)](https://github.com/openai/codex/blob/2a68b74b9bf16b64e285495c1b149d7d6ac8bdf4/codex-rs/codex-api/src/sse/responses.rs#L334-L342) 并将它们重新发布为客户端可以使用的内部事件对象。像response.output_text.delta这样的事件用于支持 UI 中的流式传输,而其他事件如response.output_item.added被转换为对象,这些对象被附加到input用于后续的 Responses API 调用。 假设对 Responses API 的第一个请求包含两个response.output_item.done事件:一个带有type=reasoning,一个带有 type=function_call。当我们使用工具调用的响应再次查询模型时,这些事件必须表示在 JSON 的 input` 字段中:
JavaScript
`
1
[
2
  /* ... original 5 items from the input array ... */
3
  {
4
    "type": "reasoning",
5
    "summary": [
6
      "type": "summary_text",
7
      "text": "**Adding an architecture diagram for README.md**\\n\\nI need to..."
8
    ],
9
    "encrypted_content": "gAAAAABpaDWNMxMeLw..."
10
  },
11
  {
12
    "type": "function_call",
13
    "name": "shell",
14
    "arguments": "{\"command\":\"cat README.md\",\"workdir\":\"/Users/mbolin/code/codex5\"}",
15
    "call_id": "call_8675309..."
16
  },
17
  {
18
    "type": "function_call_output",
19
    "call_id": "call_8675309...",
20
    "output": "<p align=\\\"center\\\"><code>npm i -g @openai/codex</code>..."
21
  }
22
]
`
作为后续查询的一部分用于采样模型的最终提示将如下所示:
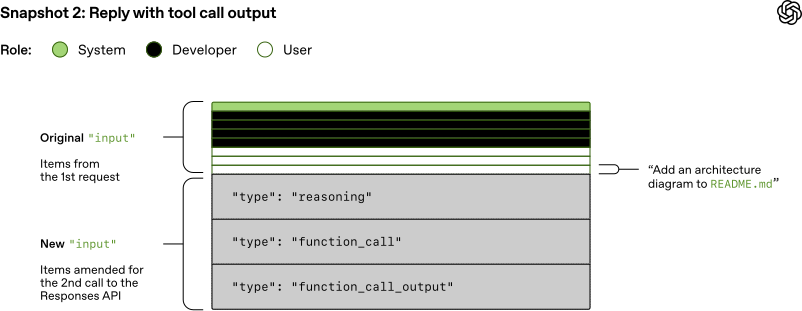 特别是,请注意旧提示 是新提示的精确前缀。这是有意的,因为这使得后续请求更加高效,因为它使我们能够利用 提示缓存(我们将在下一节关于性能中讨论)。
回顾我们的第一个 Agent 循环图,我们看到推理和工具调用之间可能有多次迭代。提示可能会继续增长,直到我们最终收到助手消息,指示轮次结束:
纯文本
`
1
data: {"type":"response.output_text.done","text": "I added a diagram to explain...", ...}
2
data: {"type":"response.completed","response":{...}}
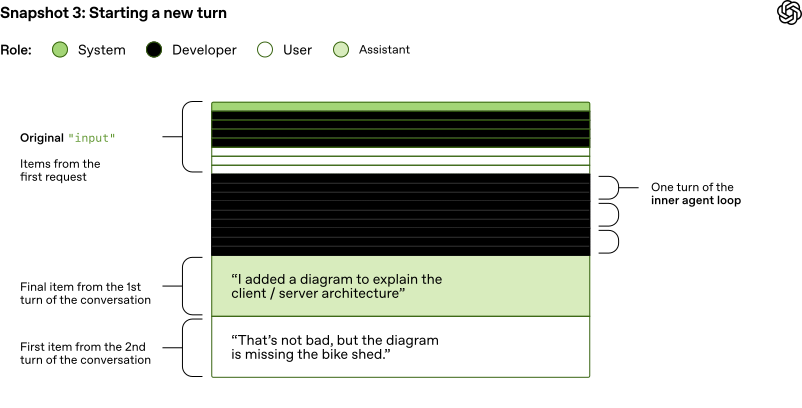
在 Codex CLI 中,我们向用户呈现助手消息并聚焦编辑器,以向用户指示现在是他们继续对话的 "回合"。如果用户响应,则前一轮的助手消息以及用户的新消息都必须附加到 Responses API 请求的input` 中,以开始新轮次:
JavaScript
`
1
[
2
  /* ... all items from the last Responses API request ... */
3
  {
4
    "type": "message",
5
    "role": "assistant",
6
    "content": [
7
      {
8
        "type": "output_text",
9
        "text": "I added a diagram to explain the client/server architecture."
10
      }
11
    ]
12
  },
13
  {
14
    "type": "message",
15
    "role": "user",
16
    "content": [
17
      {
18
        "type": "input_text",
19
        "text": "That's not bad, but the diagram is missing the bike shed."
20
      }
21
    ]
22
  }
23
]
再次,因为我们正在继续对话,所以我们发送到 Responses API 的input` 的长度不断增加:
 让我们研究这个不断增长的提示对性能意味着什么。
性能考虑
您可能会问自己,"等等,Agent 循环在对话过程中发送到 Responses API 的 JSON 量是不是 二次方的?" 您是对的。虽然 Responses API 确实支持可选的 _previous_response_id_ (在新窗口中打开) 参数来缓解这个问题,但 Codex 今天没有使用它,主要是为了保持请求完全无状态并支持零数据保留(ZDR)配置。
避免 previous_response_id 简化了 Responses API 提供商的工作,因为它确保每个请求都是 无状态的。这也使得支持选择加入 零数据保留 (ZDR) (在新窗口中打开) 的客户变得简单明了,因为存储支持 previous_response_id 所需的数据将与 ZDR 不一致。请注意,ZDR 客户不会牺牲从先前轮次中受益于专有推理消息的能力,因为相关的 encrypted_content 可以在服务器上解密。(OpenAI 持久化 ZDR 客户的解密密钥,但不持久化他们的数据。)请参阅 PR #642 (在新窗口中打开) 和 #1641 (在新窗口中打开) 中 Codex 支持 ZDR 的相关更改。
通常,采样模型的成本主导了网络流量的成本,使得采样成为我们效率工作的主要目标。这就是为什么提示缓存如此重要,因为它使我们能够重用先前推理调用的计算。当我们获得缓存命中时,对模型采样是线性的,而不是二次方的。我们的 提示缓存 (在新窗口中打开) 文档更详细地解释了这一点:
缓存命中仅在提示中的精确前缀匹配时才有可能。为了实现缓存优势,将静态内容(如指令和示例)放在提示的开头,将可变内容(如用户特定信息)放在结尾。这也适用于图像和工具,它们在请求之间必须完全相同。
考虑到这一点,让我们研究什么类型的操作可能会导致 Codex 中的 "缓存未命中":
- 在对话中间更改模型可用的
tools。 - 更改作为 Responses API 请求目标的
model(实际上,这会更改原始提示中的第三个项目,因为它包含特定于模型的指令)。 - 更改沙箱配置、审批模式或当前工作目录。
Codex 团队在 Codex CLI 中引入可能损害提示缓存的新功能时必须勤勉。例如,我们对 MCP 工具的初始支持引入了一个 错误,即我们未能以一致的顺序枚举工具 (在新窗口中打开),导致缓存未命中。请注意,MCP 工具可能特别棘手,因为 MCP 服务器可以通过 _notifications/tools/list_changed_ (在新窗口中打开) 通知即时更改它们提供的工具列表。在长对话中处理此通知可能会导致昂贵的缓存未命中。
在可能的情况下,我们通过向 input 附加一条 新 消息来反映更改,而不是修改较早的消息,来处理对话中发生的配置更改:
- 如果沙箱配置或审批模式更改,我们 插入 (在新窗口中打开) 一条新的
role=developer消息,其格式与原始<permissions instructions>项目相同。 - 如果当前工作目录更改,我们 插入 (在新窗口中打开) 一条新的
role=user消息,其格式与原始<environment_context>相同。
我们不遗余力地确保缓存命中以提高性能。我们必须管理的另一个关键资源是上下文窗口。
我们避免用完上下文窗口的一般策略是,一旦 token 数量超过某个阈值,就 压缩 对话。具体来说,我们用一个新的、更小的项目列表替换 input,该列表代表对话,使 Agent 能够在理解迄今为止发生的事情的情况下继续。早期的 压缩实现 (在新窗口中打开) 要求用户手动调用 /compact 命令,该命令将使用现有对话加上 摘要 (在新窗口中打开) 的自定义指令来查询 Responses API。Codex 使用包含摘要的结果助手消息 作为后续对话轮次的新 _input_ (在新窗口中打开)。
从那以后,Responses API 已经发展到支持一个特殊的 _/responses/compact_ 端点 (在新窗口中打开),它可以更有效地执行压缩。它返回 项目列表 (在新窗口中打开),可以用来代替之前的 input 来继续对话,同时释放上下文窗口。该列表包括一个特殊的 type=compaction 项目,带有一个不透明的 encrypted_content 项目,该项目保留了模型对原始对话的潜在理解。现在,当超过 _auto_compact_limit_ (在新窗口中打开) 时,Codex 自动使用此端点来压缩对话。
下一步
我们已经介绍了 Codex Agent 循环,并详细介绍了 Codex 在查询模型时如何构建和管理其上下文。在此过程中,我们强调了适用于任何在 Responses API 之上构建 Agent 循环的人的实际考虑和最佳实践。 虽然 Agent 循环为 Codex 提供了基础,但这只是开始。在即将到来的文章中,我们将深入研究 CLI 的架构,探索工具使用是如何实现的,并仔细研究 Codex 的沙箱模型。
作者
Michael Bolin
致谢
特别感谢构建 Codex CLI 的整个团队。
继续阅读
查看全部
 核心转储流行病学:修复一个 18 年的 bug工程2026年6月30日
 使用 Codex 构建自我改进的税务 Agent工程2026年5月27日
 构建安全、有效的沙箱以在 Windows 上启用 Codex工程2026年5月13日