AI 智能体评估:如何测试、调试和改进生产中的智能体 - Arize AI
来源: https://arize.com/blog/why-testing-ai-agents-is-non-negotiable/ 抓取时间: 2026-07-21 16:23:12
AI 智能体评估:如何测试、调试和改进生产中的智能体
发布于 2026 年 5 月 5 日
共同作者:Sally-Ann DeLucia,产品总监;Chris Cooning,产品营销负责人;Priyan Jindal,AI 工程师;Jack Zhou,资深软件工程师。
构建和交付我们的 AI 智能体 Alyx 的经验教训
在传统软件工程中,测试是一个已解决的问题。你编写单元测试,设置 CI/CD 流水线,你的 GitHub Actions 确保在进入生产之前没有任何东西崩溃。但是 AI 智能体是一个完全不同的野兽。
当我们开始构建 Alyx 时,我们很快发现旧的剧本不适用。对工具描述的微小更改或系统提示词中的单行内容可能会产生几乎无法预测的级联失败。
在本文中,我们分享了我们在为 AI 智能体构建评估方面学到的东西,以及为什么我们现在认为它们对于任何将智能体交付到生产的团队来说都是不可谈判的。这是继过去深入探讨如何在智能体中构建规划和如何管理智能体中的记忆之后的文章。
让我们开始吧。
早期:Google 文档和痛苦
老实说,大多数团队开始时都是:在文档中手动测试。
当 Alyx 还年轻时,我们的"测试框架"是一个 Google 文档。我们会写下查询,记录响应,进行更改,检查事情是否有所改善,然后重复。这很痛苦,效率低下,而且无法扩展。
核心问题是什么?AI 智能体不是确定性的。相同的输入可以产生不同的输出。提示词以意想不到的方式相互作用。当你快速迭代时,没有可靠的方法来知道你的"修复"是否刚刚破坏了其他三个工作流。
我们知道我们需要更好的东西。一种可以跟上开发步伐的系统验证智能体行为的方法。
解决方案:来自真实生产追踪的黄金数据集
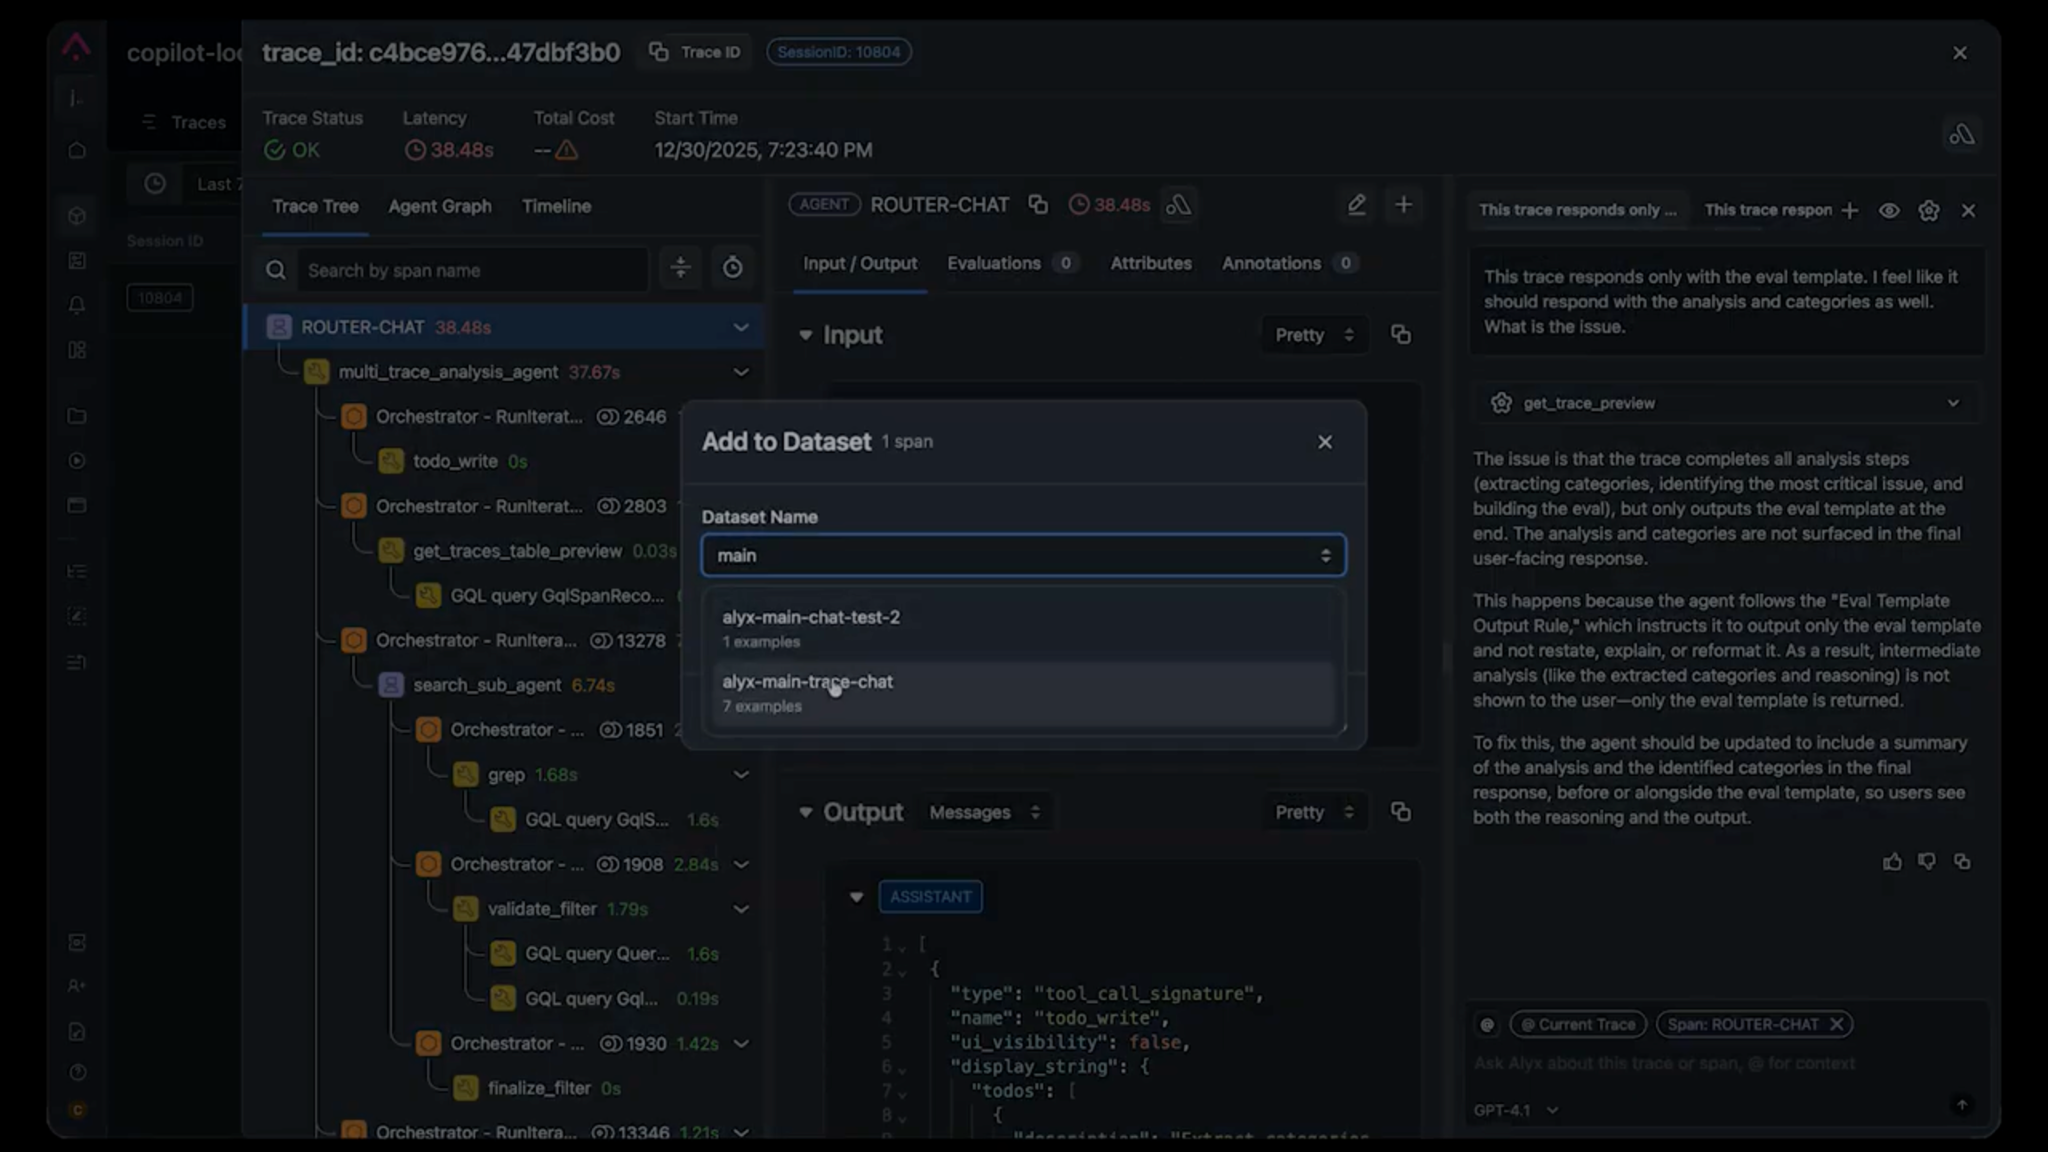
我们测试方法的基础看似简单:捕获真实的生产追踪并将其用作测试用例。
这为什么很重要:
- 合成数据会遗漏边缘案例。 你可以用大语言模型生成测试用例,但它们往往是"快乐路径"的例子。真实用户会做意想不到的事情。
- 生产追踪捕获实际失败。 当生产中出现问题时,该追踪就变成了测试用例。你正在针对导致问题的确切条件进行测试。
- 它支持团队协作。 当有人发现错误时,他们可以将追踪添加到共享数据集中。不再有"在我的机器上可以工作"的争论,每个人都在针对相同的数据进行测试。
我们如何构建测试用例
数据集中的每个测试用例都包括:
- 输入追踪:触发行为的确切用户查询和上下文
- 预期结果:自然语言描述_应该_发生什么
注意我们说的是"自然语言描述",而不是僵化的 JSON 模式。这是有意的。例如,预期结果可能是:"运行分类工具后,大语言模型应该先用文本解释类别,然后再创建评估模板。"
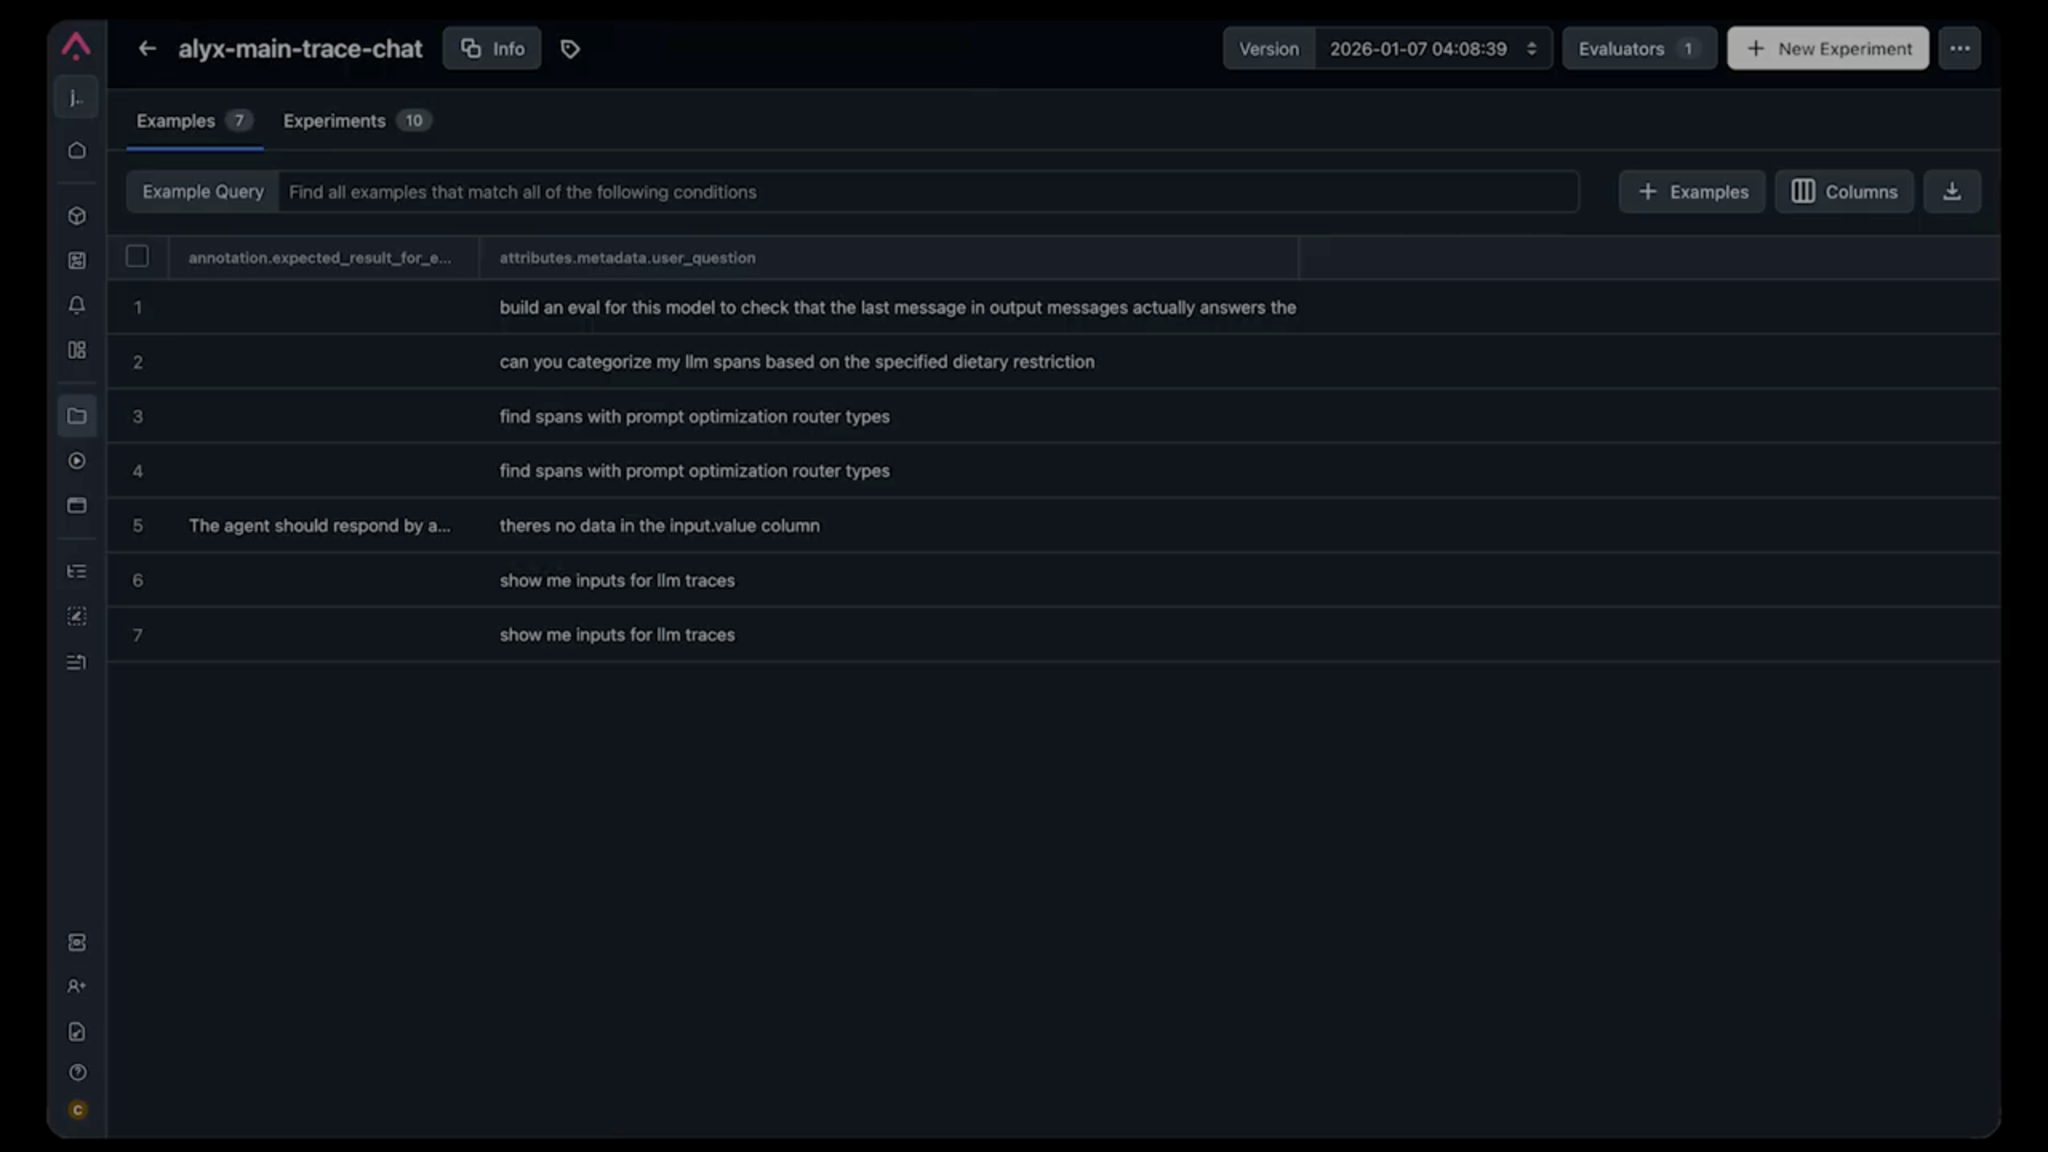
为什么不使用精确输出匹配?因为 AI 输出在措辞、格式和结构上各不相同。精确匹配会创建脆弱的测试,这些测试会在语义正确的响应上失败。相反,我们使用理解_意图_的基于大语言模型的评估器。
大语言模型作为评判者:为什么我们停止编写断言
传统断言不适用于 AI 输出。检查响应 == 预期响应会在智能体使用稍微不同的措辞时立即失败。
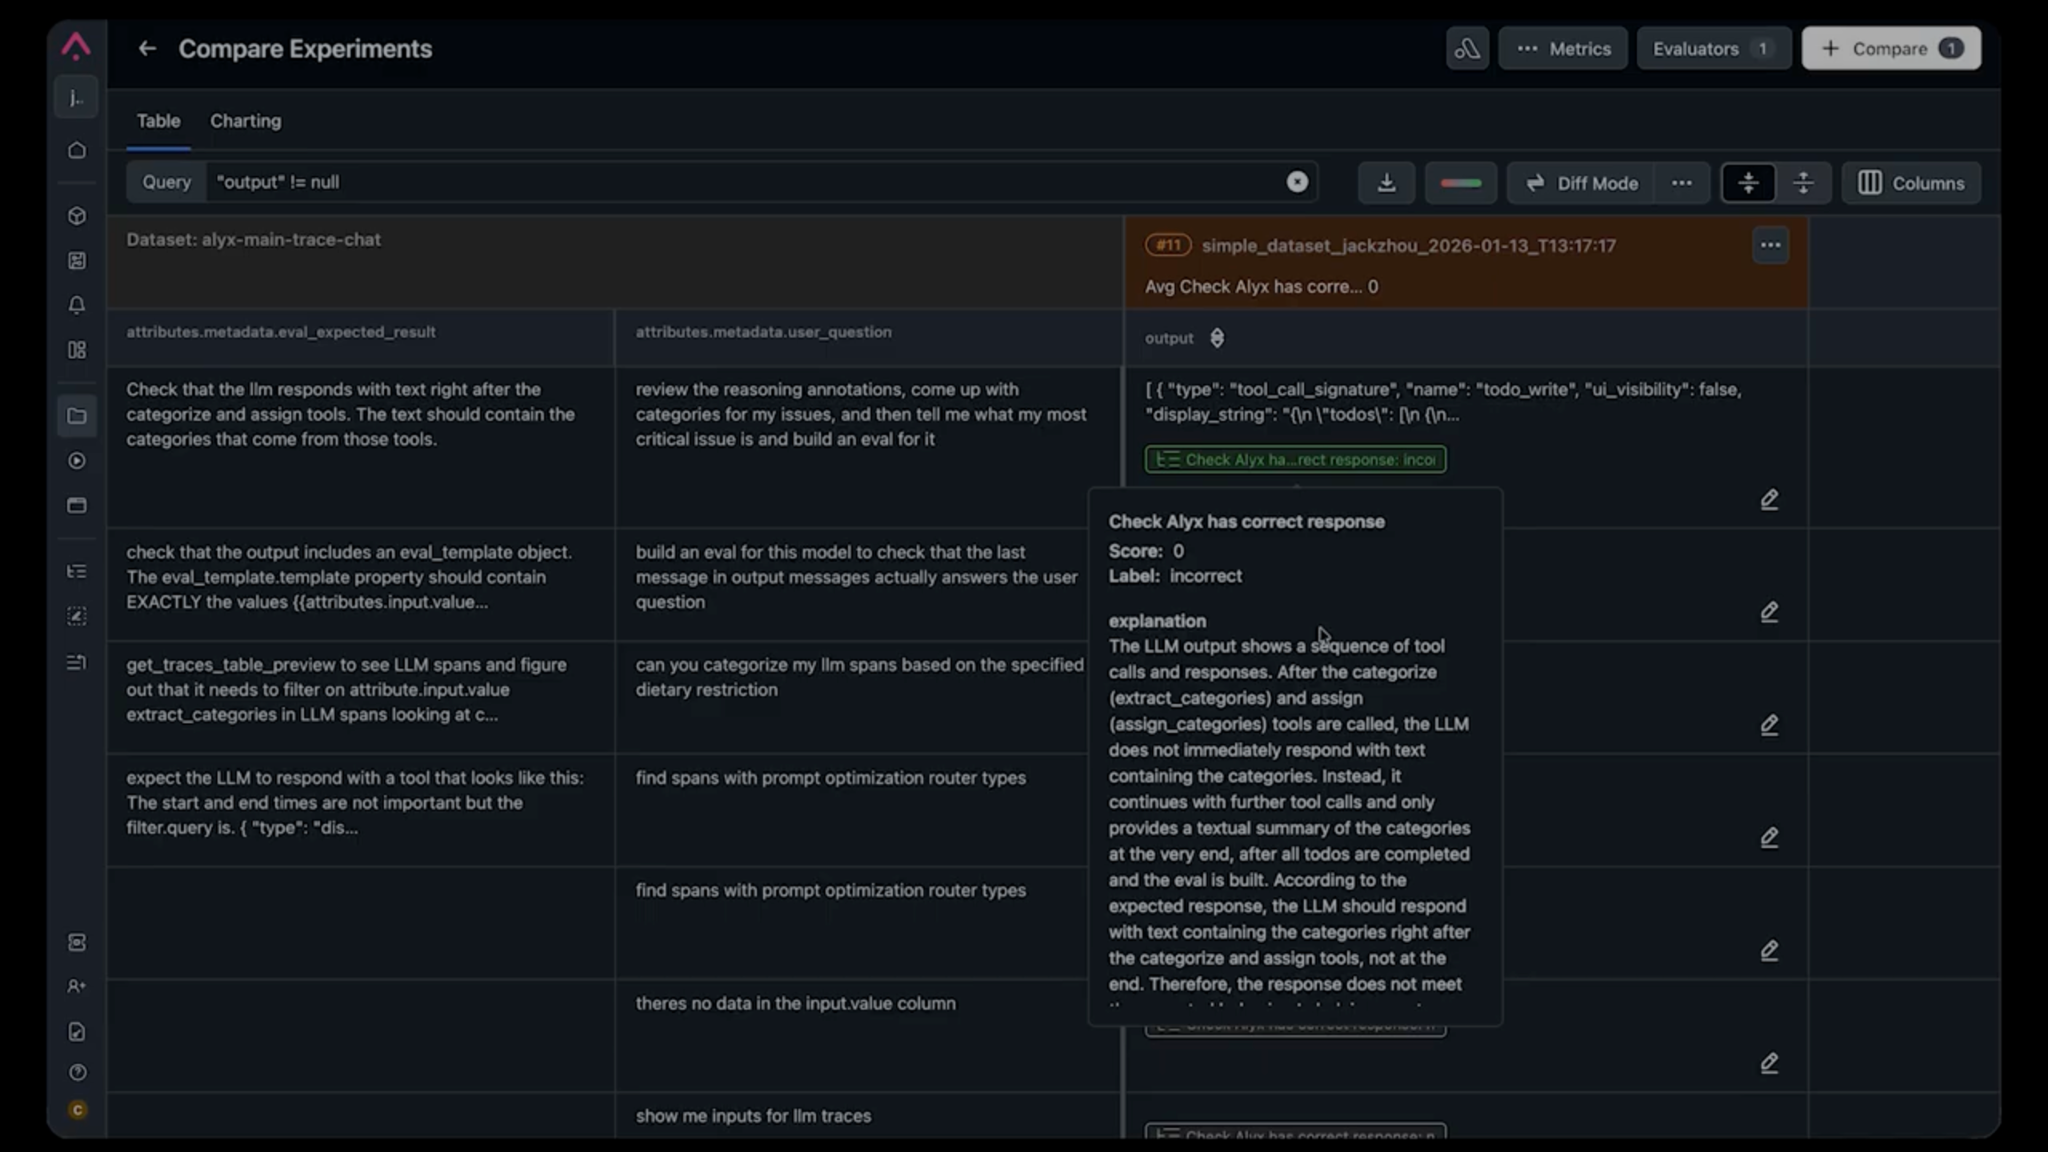
这就是基于大语言模型的评估的用武之地。我们的方法:使用大语言模型来评估输出是否符合预期。 评估器很简单:它接受预期结果和实际输出,然后返回通过/失败判断以及解释。
这个解释通常比二进制结果更有用,它用通俗的语言告诉你_为什么_某件事失败了。
例如,当我们调试 Alyx 跳过解释步骤并直接跳转到生成评估模板的流程时,评估器告诉我们: "在 categorize_and_assign 之后,大语言模型不会立即用文本响应。相反,它继续进行更多的工具调用,而没有向用户解释类别。"
这比大多数人类写的错误描述更好。
选择正确的评估类型
并非每个测试都需要大语言模型评判器。这是我们的框架:
| 场景 | 评估类型 |
|---|---|
| 输出必须包含特定数据(API 响应、提取的值) | 确定性检查(正则表达式、JSON 模式) |
| 输出应遵循行为准则 | 大语言模型作为评判者 |
| 输出质量/语调评估 | 带有评分标准的大语言模型作为评判者 |
| 工具调用序列验证 | 追踪分析(确定性) |
| 延迟/成本要求 | 指标阈值 |
对于 Alyx,大多数测试使用大语言模型作为评判者,因为我们主要验证_行为_。智能体是否按正确的顺序做了正确的事情?
AI 智能体的测试驱动开发
一旦你的智能体框架就位,你就可以采用 TDD 工作流。以下是改变我们交付功能方式的流程:
- 识别失败的追踪。 用户报告问题,或者我们在生产中注意到意外行为。
- 将其添加到测试数据集中。 该追踪成为一个测试用例,带有描述_正确_行为的预期结果。
- 运行测试(它应该失败)。 这验证你的测试确实捕获了问题。如果它通过了,你的期望不够具体。
- 进行更改以修复行为。 修改系统提示词、工具描述或智能体逻辑。
- 再次运行测试。 迭代直到它通过。
- 运行完整的评估套件。 确保你的修复没有破坏其他任何东西。
这是 AI 的 TDD。从失败的评估开始,进行迭代改进直到它通过。
真实示例:评估模板输出规则错误
我们有一个追踪,用户要求 Alyx:
- 对他们的问题进行分类
- 告诉他们关键问题是什么
- 为其构建一个评估
Alyx 跳过了第 2 步。它会对问题进行分类,然后立即生成评估,而没有向用户解释分析。
使用我们的追踪调试工具,我们确定了罪魁祸首:一个名为 eval_template_output_rule 的系统提示词规则,它指示: "当工具返回评估模板时,不要重述或重新格式化它。只输出完成的调用,不要有文本。"
这个规则是几个月前添加的,用于解决一个_不同的_问题(生成评估时冗长的响应),但现在它导致 Alyx 完全跳过解释。
如果没有我们的测试套件,这几乎不可能系统地捕获。这个规则被埋在一个长长的系统提示词中,而且失败只出现在特定的多步骤工作流中。
实验:随时间运行评估
单独的测试运行告诉你某件事_现在_是否有效。但是将评估作为实验运行告诉你事情是随着时间_变得更好还是更坏_。
每次我们运行测试套件时,我们都会将结果作为实验记录在 Arize 中。这给了我们:
- 性能趋势:我们是在改进还是在回归?
- 跨更改比较:这个提示词更改是有帮助还是有害?
- 异常检测:通过率突然下降会触发警报
我们不期望 100% 的通过率(那会很可疑)。但我们确实期望一致性,当突然下降时,我们知道出了问题。
模型升级测试
这就是实验变得至关重要的地方。
我们在从 GPT-3.5 升级到 GPT-4 时亲身体验了这一点。从逻辑上讲,一个更聪明的模型应该产生更好的结果,对吧?
错了。我们的智能体开始表现得不稳定。以前工作的工具调用现在失败了。响应格式改变了。我们花了_几天_才发现所有的回归,而且我们的客户首先发现了其中的大部分(不幸的是)。
现在,在任何模型升级之前,我们都会针对新模型运行完整的测试套件,并并排比较实验。
如果新模型导致回归,我们会在_推送_到生产之前修复它们。不再有意外的错误报告。
CI/CD 集成:自动化质量门
测试只有在持续运行时才有用。这就是智能体框架工程发挥作用的地方。一旦你构建了在隔离中运行智能体的基础设施,将其插入 CI/CD 就很简单了。
我们已经将我们的智能体测试集成到我们的 CI/CD 流水线中,因此每个涉及提示词、工具或智能体逻辑的 PR 都会触发测试套件。如果通过率低于我们的阈值,PR 就会被阻止。
这对于团队成长尤其重要。新工程师可能会将两行的提示词更改视为无害,但这两行可能是几个月前为了修复一个微妙的问题而添加的。测试套件在这些回归到达用户之前捕获它们。
构建你的评估数据集:实用建议
从零开始?以下是如何为你的评估构建有用的数据集:
1. 从已知失败开始
每个错误报告都是一个潜在的测试用例。当用户报告问题时,捕获追踪并将其添加到你的数据集中,并附上预期行为。
2. 覆盖核心工作流
确定你的智能体做的 5-10 件最重要的事情。为每一个创建测试用例,包括:
- 快乐路径(一切正常)
- 边缘案例(不寻常的输入、缺失的数据)
- 错误处理(工具失败时会发生什么)
沟通益处
除了捕获错误之外,评估还改变了我们团队的沟通方式。
之前:"嘿,这不行。""你做了什么?""我让它分类东西。""给我看看你的屏幕。"来回 30 分钟
之后:"我将追踪 #247 添加到数据集中。预期行为是 X,但它正在做 Y。这是失败的评估。"
评估给了我们一个讨论智能体行为的_共同语言_。追踪是确切的输入。预期结果是规范。评估是裁决。没有歧义。
关键要点
- 测试对于生产智能体是不可谈判的。 系统提示词和工具交互的复杂性使得手动测试不足。
- 尽早投资你的智能体框架。 运行、捕获和评估智能体行为的基础设施是基础。其他一切都建立在它之上。
- 使用真实的生产追踪。 合成数据会遗漏实际破坏东西的边缘案例。
- 基于大语言模型的评估优于精确匹配。 自然语言期望更健壮且更容易编写。
- 随时间追踪实验。 单次测试运行是不够的。你需要趋势来捕获回归。
- 与 CI/CD 集成。 自动化质量门防止回归到达生产。
- 模型升级前测试。 更聪明的模型不能保证更好的智能体行为。
- 测试支持团队协作。 它们提供了讨论智能体行为的共同语言。
我们仍在学习,因为智能体框架工程是一门不断发展的学科。但这些实践让我们能够自信地交付,扩展我们的团队,并停止玩打地鼠的生产错误游戏。
如果你正在构建智能体却没有适当的测试框架,你不是在快速前进,你是在积累以后会减慢你的债务。从小处开始,捕获你的第一个失败追踪,然后从那里开始构建。
想看看 Arize 如何帮助团队为 AI 智能体构建评估吗? 预约演示
系列的下一篇文章
这是关于我们如何构建 Alyx 的四部分深入系列的一部分。如果你错过了,第一部分和第二部分在这里:
- 第一部分: 如何在智能体中构建规划
- 第二部分: 管理智能体中的记忆
- 即将推出: 使用 Alyx 调试 Alyx
- 我们如何使用 Arize AX 追踪 Alyx 的规划行为,捕获回归,并在智能体做什么和它应该做什么之间建立闭环。
 Sally-Ann DeLucia 产品总监
 Chris Cooning 产品营销负责人
 Priyan Jindal AI 工程师
 Jack Zhou 资深软件工程师
- [](//www.linkedin.com/shareArticle?mini=true&url=https%3A%2F%2Farize.com%2Fblog%2Fwhy-testing-ai-agents-is-non-negotiable%2F&title=AI agent evaluation: How to test, debug, and improve agents in production)
- [](//twitter.com/intent/tweet?url=https%3A%2F%2Farize.com%2Fblog%2Fwhy-testing-ai-agents-is-non-negotiable%2F&text=AI agent evaluation: How to test, debug, and improve agents in production)
- 已复制